初始Agent/固定模型
- 机制
- 以初始工具与流程作为基线,模型权重不参与训练。
- 条件/配置
- 各配置使用相同执行模型与限制。
- 报告结果
- 为改进效果提供比较起点。
- 局限
- 模型固定不等于运行成本或任务行为完全相同。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第2节/第3.1节:基线与模型配置
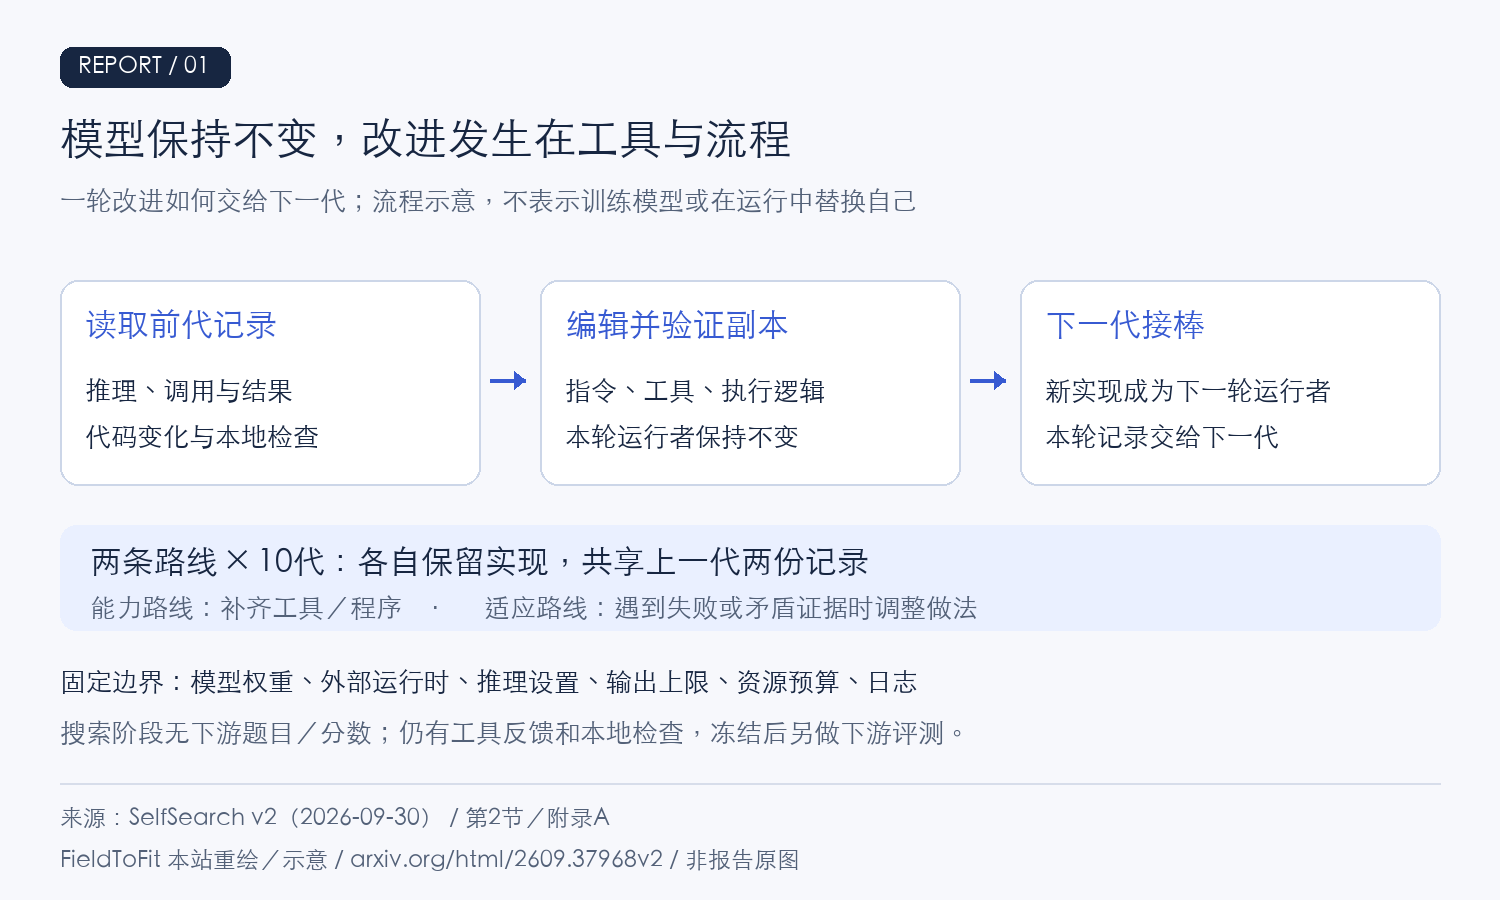
固定模型 → 读取改进记录 → 修改工具与流程 → 冻结后独立评测与迁移。
改进经验可以生成有用工具,部分作者实验同时提高成功率并降低执行费用;是否更好仍须冻结实现后按同一任务和成本口径验证。
作者实验,未独立复现。Verified为120题子集;38.5%仅为共同成功题执行费用降幅,搜索和事后评测另计;不代表无限持续进步。
本次变化:所有者选择今日报告1后发布:四个编号观点与对应论述、四张本站重绘/示意、固定模型/费用分母/反例与迁移边界。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第2节/第3.1节:基线与模型配置
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第2节/第4节:流程与工具变化
DeepSeek适应路线多语言成功率:73.3 % · 比较基线 初始Agent 68.3% · SWE-bench Multilingual抽样60题/8种语言;DeepSeek V4 Flash执行;10代;作者实验
共同成功题执行费用降幅:38.5 % · 比较基线 初始Agent在双方共同成功题上的执行费用 · DeepSeek适应路线/SWE-bench Multilingual;表10独立分母;不含搜索/事后评测费用
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第3.1–3.2节/表1;附录表10
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第3.4节/表3;第6节
方法继承/纳入:同一初始实现经过记录驱动的逐代修改
第2节:两条路线从相同初始Agent出发基线对比:相同执行模型与限制下比较初始和第10代
第3.1–3.2节/表1:比较条件方法继承/纳入:最后一代工具实现冻结后进入下游评测
第2节/第3.1节:搜索与评测分开并行探索:同一冻结实现的另一种评测:换执行模型,不重新搜索
第3.4节/表3:跨模型迁移SelfSearch把改进对象放在指令、工具和执行逻辑上:读取前代记录,编辑并验证副本,再由新实现接棒下一轮。
消融实验支持前代记录和改进者接棒的作用;工具演进案例显示,记录中的失败能变成下一代的具体修复目标。
DeepSeek适应路线在60道多语言题中,成功率由68.3%升至73.3%;“节省38.5%”另指双方都解对的题上的执行费用。
作者在120道Verified题上换用执行模型,观察到跨模型复用收益;这支持工具实现具有可迁移性,但还不足以证明通用、持续的自我进化。
这篇报告问的是:不在搜索期间反复跑下游题目、按分数筛选候选,Agent能否从“改进自己”的经历中找到有用变化?作者让Agent读取此前改进的过程记录,而不只是最终代码。记录包括推理、工具调用及结果、代码变化和本地检查。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第2节/附录A:运行边界
适用边界:“无奖励搜索”仍使用工具反馈与本地检查,也仍需要事后评测;这里没有训练模型权重。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第2节:改进轮次、两条路线与固定运行时
返回核心结论报告中最有启发的变化很具体:读取长记录时,输出截断会隐藏关键证据;一个工具修复后,下一轮又会暴露新的阅读或验证困难。这让“自我改进”有了可检查的工程过程。
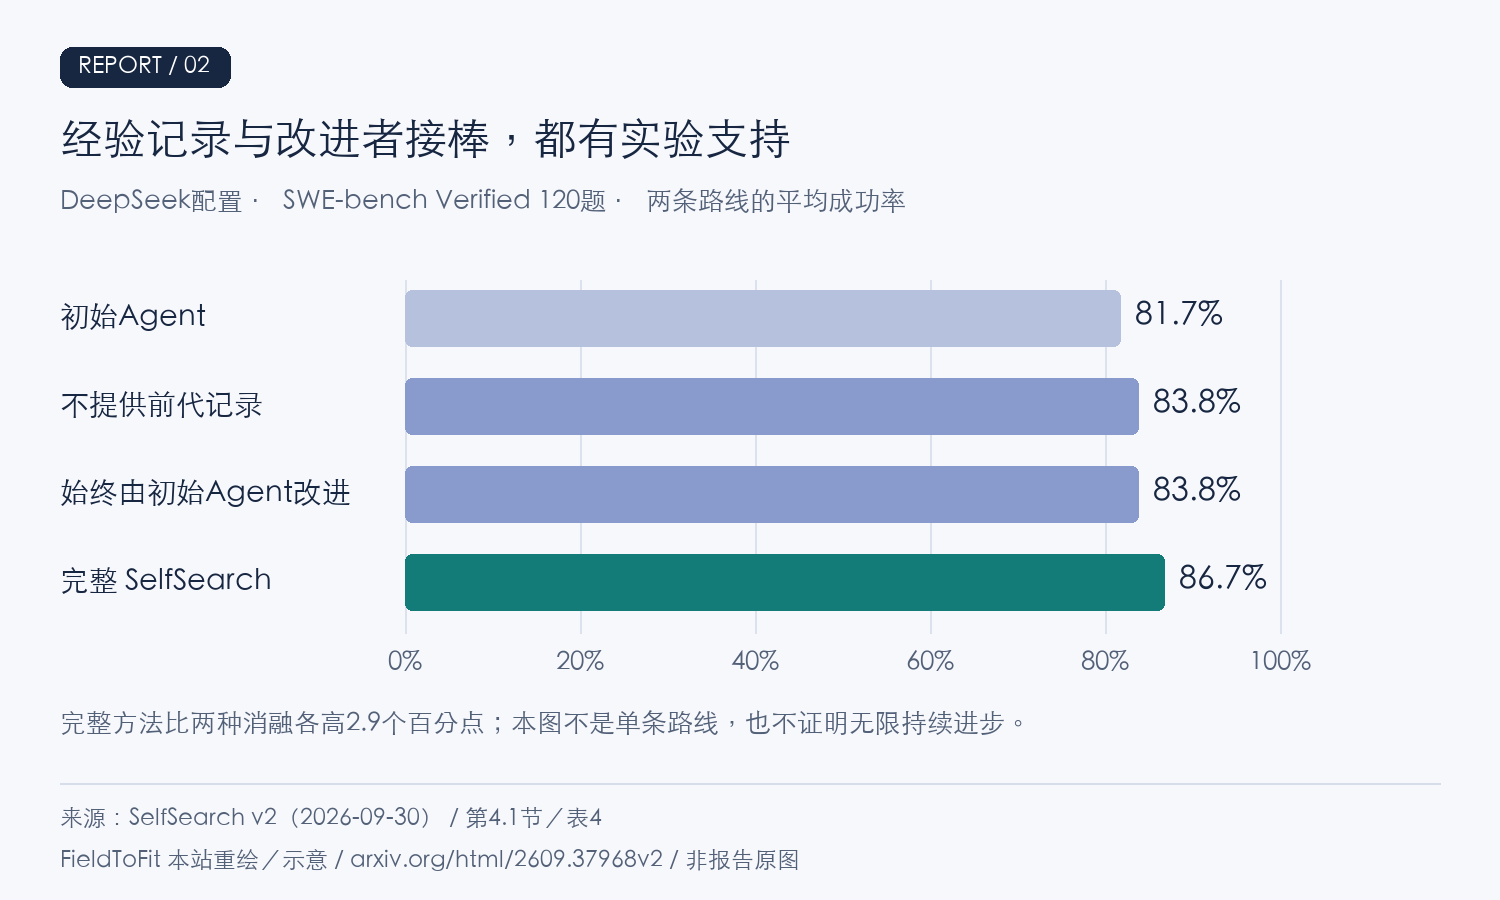
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第4.1节/表4:消融条件与均值
关键证据:工具的作用也分层:文本搜索和按行阅读被用于下游任务;GPT记录阅读器未在下游调用,它主要支持继续改进的过程。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第4.1–4.3节:消融、逐代变化与下游工具复用
返回核心结论报告测试了两种模型配置、三个基准。两条最终路线的平均成功率在六个模型—基准设置中均高于初始Agent;具体到单条路线,效果与费用并不总是一起改善。
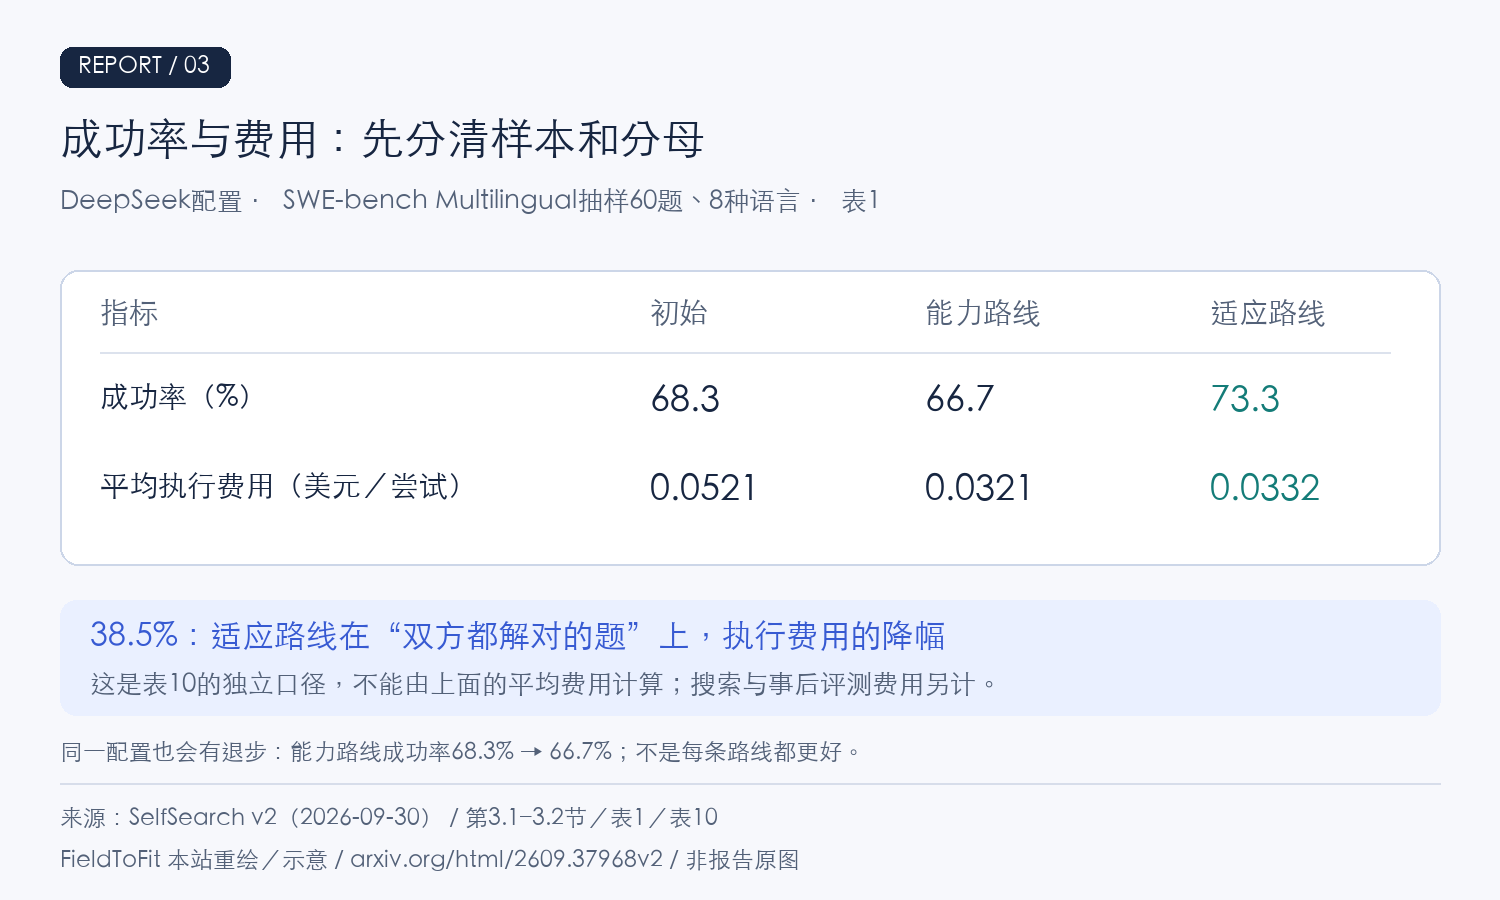
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 表1:平均每次尝试;表10:共同成功题执行费用
适用边界:73.3%比68.3%高5个百分点。38.5%不是总体研发成本降幅,也不是所有任务、模型或真实业务的费用承诺。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第3.1–3.2节/表1;附录D.2/表10:费用分母
返回核心结论如果改进只对生成它的模型有用,工具价值会很受限。作者把搜索得到的实现冻结后,交给另一模型执行,不再重新搜索。这是一项关于工具与程序可迁移性的实验。
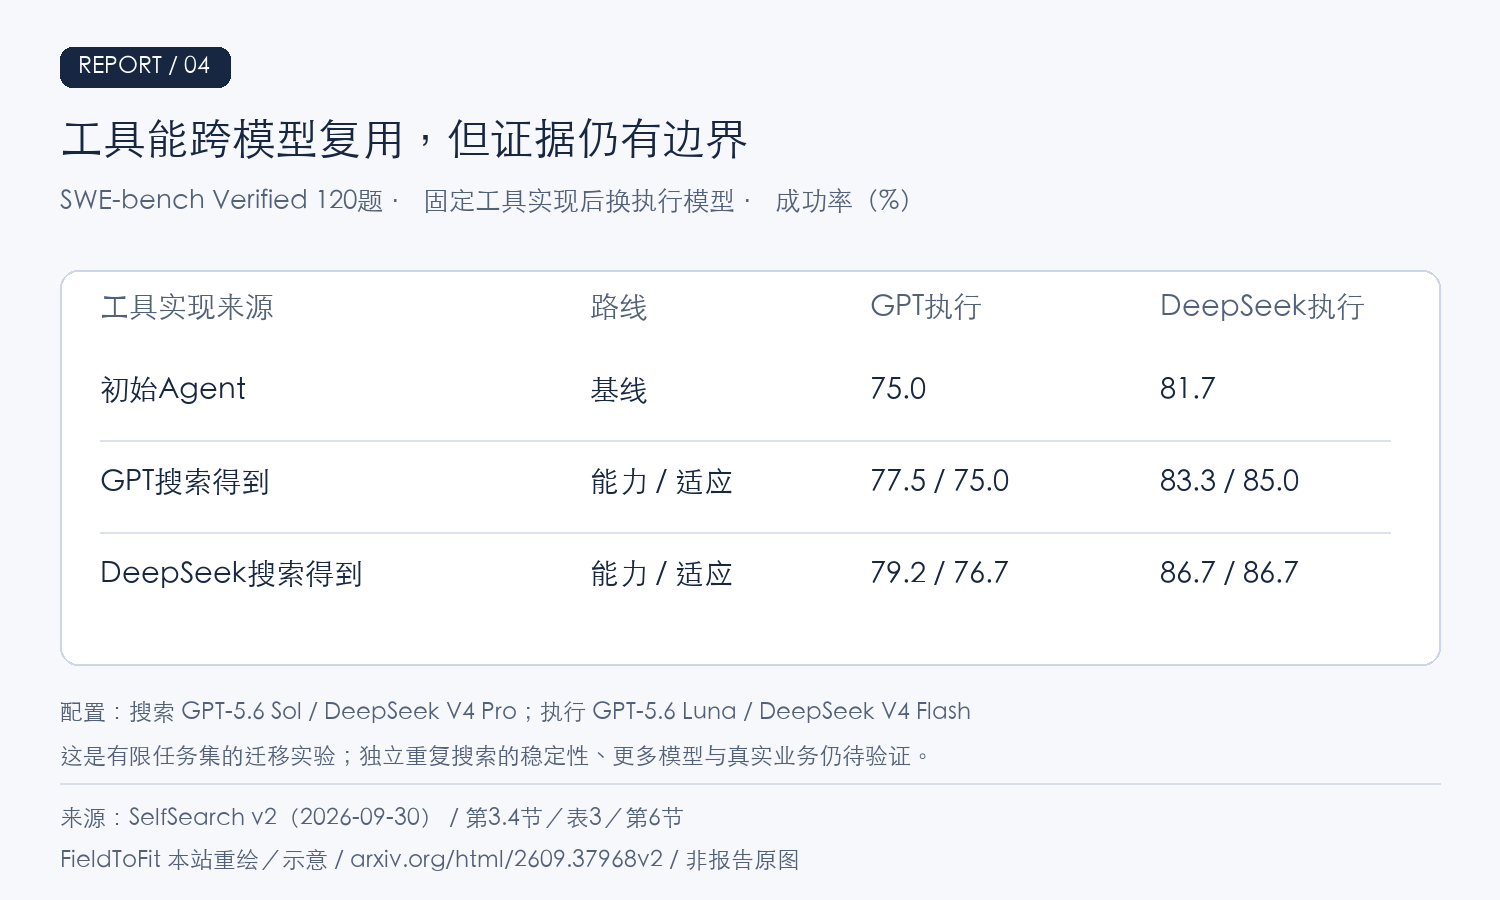
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第3.4节/表3:搜索模型与执行模型分开
适用边界:搜索在无网络的隔离容器中、固定资源边界下运行;本文整理作者实验,FieldToFit未独立复现。
SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · 第3.4节/表3:跨模型迁移;第6节:稳定性与后续研究
返回核心结论SelfSearch: Reward-Free Search for Self-Improving Agents · arXiv v2 · arXiv 2609.37968v2 · 2026-09-30 · 首次发布 2026-09-29 · 报告修订 2026-09-30 · 读取v2;未对v1逐项对比,不将v2登记为已核实的实质更新。
地图首次发布 2026-10-10T08:46:02.146079+00:00 · 地图修订 2026-10-10T08:46:02.146079+00:00