百万次重复判断,怎样降低调用费用?
重复调用的费用如何转成可复用产物的构建投入;自主封装、固定蒸馏与专用判断服务的质量—费用取舍。
让Agent自行制造可复用产物,部分任务能显著降低论文报告的API费用;但是否保住质量、胜过简单蒸馏并交付完整输出,仍需要单独验证。
仅据2026-10-06作者报告v1,未独立复现。逐条调用和Jev费用由1000条样本外推,论文费用口径不能当作包含GPU、部署、维护的完整预算。
本次变化:围绕四条路线展示完整比较,整理四个核心结论与对应论述,附原图2/3/4和原表1、重点标记及费用与质量边界。
方法、实验与证据
每条都调用大模型
- 机制
- 固定问题加一条输入,每次独立调用同一大模型;不同实例之间不复用计算。
- 条件/配置
- 逐条零样本基线只测1000条均匀样本,再外推整批费用。
- 报告结果
- Opus 5在ESCI上的样本macro-F1为0.609,预计全量模型调用费用17,273美元。
- 局限
- 这不是262万条全量逐条调用的实际账单;抽样质量与外推费用存在估计边界。
ESCI零样本macro-F1:0.609 macro-F1(0–1) · 比较基线 同模型封装产物0.499 · ESCI约262万查询—商品对;E/S/C/I四分类、macro-F1;封装产物全量评测取两轮均值,逐条调用与Jev使用1000条共同样本。
ESCI全量逐条调用预计费用:17273 USD(论文估计) · 比较基线 Opus 5封装报告费用26.28 USD · 论文报告的模型 API/token 费用口径;不能视为含 GPU、部署和维护的完整成本。逐条调用全量费用由同一批1000条样本外推;费用采用论文中的2026年9月模型价格。
Agent in a Bottle — 作者完整技术报告v1 · §1、§3.1和§3.5.1:逐条调用及费用估计
固定流程:标注后蒸馏小模型
- 机制
- GLM 5.3 Flash随机抽样标注,固定脚本训练Qwen3-0.6B和SmolLM2-360M-Instruct,再对整批推理。
- 条件/配置
- 与Agent采用相同500万加权token预算;每个学生三轮独立训练评测,按公开配方、无任务专门调参。
- 报告结果
- 两种小模型构成成本受限的基线;60轮Agent封装中31轮低于对应任务中更强的学生。
- 局限
- 相同token预算不等于相同美元或硬件成本;不能把31/60理解为对所有生产任务的失败概率。
Agent in a Bottle — 作者完整技术报告v1 · §3.5.2、§4.1及附录B:固定蒸馏对照
专用推理:Jev逐条做判断
- 机制
- Jev作为便宜的专用判断服务,每个实例仍单独调用;ESCI使用choice问题。
- 条件/配置
- 论文测试Jev 1.13.0;同一1000条零样本样本,费用按论文所列输入token价格外推。
- 报告结果
- ESCI样本macro-F1为0.531,预计全量费用104.89美元。
- 局限
- Jev是独立对照路线,不能生成自由文本,未用于MAVE;不是Agent封装方法的前身或别名。
Jev ESCI macro-F1:0.531 macro-F1(0–1) · 比较基线 Opus 5封装产物0.499 · ESCI约262万查询—商品对;E/S/C/I四分类、macro-F1;封装产物全量评测取两轮均值,逐条调用与Jev使用1000条共同样本。
Jev ESCI全量预计费用:104.89 USD(论文估计) · 比较基线 Opus 5封装报告费用26.28 USD · 论文报告的模型 API/token 费用口径;不能视为含 GPU、部署和维护的完整成本。逐条调用全量费用由同一批1000条样本外推;费用采用论文中的2026年9月模型价格。
Agent in a Bottle — 作者完整技术报告v1 · §4.2与附录E:Jev比较、版本和评测接口
本站已发布的Jev介绍(D-25) · Jev既有介绍;本图实验版本与数值仅依据作者报告§4.2
Agent先造一个可复用工具
- 机制
- Agent先看完整未标注工作量,自主选择程序、微调小模型、检索索引或混合路由;将能力封装为产物,再应用到全部实例。
- 条件/配置
- OpenCode;单张 A100 40GB、8 CPU 核、64GB RAM;每轮10小时和500万加权 token,上限同时覆盖构建与整批输出。只可调用自身模型API,不可获取任务真标签。
- 报告结果
- 把构建成本与执行调用成本分开记账;自主选择构建方式是本报告相对固定蒸馏路线的关键问题。
- 局限
- 产物执行通常不调用LLM,并不意味着执行没有计算成本;需要交付全量输出,不能把造出代码当作任务完成。
Agent in a Bottle — 作者完整技术报告v1 · §3.1公式(3)–(5)、§3.3和§3.4:封装协议与预算
单项结果:省费用,同时损失质量
- 机制
- 用同一ESCI任务对比Opus 5逐条调用、Opus 5自主封装产物和Jev判断服务。
- 条件/配置
- ESCI约262万查询—商品对;E/S/C/I四分类、macro-F1;封装产物全量评测取两轮均值,逐条调用与Jev使用1000条共同样本。论文报告的模型 API/token 费用口径;不能视为含 GPU、部署和维护的完整成本。逐条调用全量费用由同一批1000条样本外推;费用采用论文中的2026年9月模型价格。
- 报告结果
- Opus 5封装macro-F1为0.499、报告费用26.28美元;约保留逐条调用macro-F1的82%,论文报告费用约为其1/657;约保留Jev macro-F1的94%,费用约为其1/4。
- 局限
- 82%是macro-F1比值,不是准确率;657倍不是同等质量下的总体节省,更不是模型API降价。
Opus 5封装ESCI macro-F1:0.499 macro-F1(0–1) · 比较基线 Opus 5逐条调用0.609;Jev 0.531 · ESCI约262万查询—商品对;E/S/C/I四分类、macro-F1;封装产物全量评测取两轮均值,逐条调用与Jev使用1000条共同样本。
Opus 5封装ESCI报告费用:26.28 USD(论文报告) · 比较基线 逐条调用预计17,273 USD;Jev预计104.89 USD · 论文报告的模型 API/token 费用口径;不能视为含 GPU、部署和维护的完整成本。逐条调用全量费用由同一批1000条样本外推;费用采用论文中的2026年9月模型价格。
Agent in a Bottle — 作者完整技术报告v1 · §1、§4.1表1及§4.2:ESCI质量与费用
整体结果:强模型也未必会造好工具
- 机制
- Bottled统一评测10个模型、3个窄任务、每个模型任务两轮,共60轮;比较单条知识能力与受预算限制的产物能力。
- 条件/配置
- MAVE属性提取约477万对、ESCI约262万对、RAID检测约562万文档;各用F1、macro-F1、AUROC,不直接混成一个准确率。OpenCode;单张 A100 40GB、8 CPU 核、64GB RAM;每轮10小时和500万加权 token,上限同时覆盖构建与整批输出。
- 报告结果
- 48/60轮封装成绩低于对应逐条调用95%置信区间下界;31/60轮低于两个蒸馏学生中更强者;8/60轮预算耗尽且未交付要求输出。
- 局限
- 只有三种任务、每个模型任务两次封装运行,结论是作者实验结果;FieldToFit尚未独立复现。不能从个别高节省案例推广到所有Agent。
低于逐条调用95%区间的轮数:48 轮 / 共60轮 · 比较基线 对应模型在同任务上的零样本95% bootstrap区间 · 10模型×3任务×2轮;零样本1000条、2000次bootstrap
低于较强蒸馏学生的轮数:31 轮 / 共60轮 · 比较基线 对应任务中两个小模型学生的较强平均成绩 · 同500万加权token预算,两个学生各训练评测三轮
预算耗尽且缺要求输出的轮数:8 轮 / 共60轮 · 比较基线 预算内交付全量out.txt的完成合同 · 其中21轮被预算上限停止;未交付完整文件的8轮按缺失项回退评分
Agent in a Bottle — 作者完整技术报告v1 · §3.4、§4.1和§4.3:统计口径、输出失败与超预算消融
关系与依据
llm-per-instance → agent-builds-artifact
基线对比:同一模型:逐条回答与自主造工具的基线比较
§3.1与§3.5.1fixed-distillation → agent-builds-artifact
基线对比:同token预算:固定脚本对照自主决策
§3.5.2jev-inference → agent-builds-artifact
并行探索:专用判断服务与自主封装是替代路线
§4.2llm-per-instance → esci-tradeoff
基线对比:ESCI逐条调用质量与外推费用
§1jev-inference → esci-tradeoff
基线对比:ESCI Jev质量与外推费用
§4.2agent-builds-artifact → esci-tradeoff
基线对比:ESCI封装产物加入质量—费用比较
§1与§4.1表1fixed-distillation → suite-reliability
基线对比:31/60轮不及较强蒸馏学生
§4.1llm-per-instance → suite-reliability
基线对比:48/60轮低于逐条调用95%区间
§4.1agent-builds-artifact → suite-reliability
基线对比:自主封装的整体质量与交付完成度
§4.1和§4.3
这份报告的核心观点
- 会回答,不代表会构建可复用工具
零样本答题能力强,并不保证Agent能把能力封装成有效产物。
- 可复用产物能大幅降低API费用,但要同时看质量损失
费用收益很突出,质量保留程度和费用口径也同样重要。
- 自主Agent未必胜过简单的固定蒸馏流程
相同token预算下,31/60轮封装不及较强蒸馏学生。
- 给Agent更多预算,不能普遍补齐封装能力
取消预算强制停止后,许多运行仍落后于零样本质量。
1. 会回答,不代表会构建可复用工具
- 两种能力的区别。 逐条问大模型,主要检验它能否答对一道题;自主封装还要求Agent决定哪些计算可以复用、前期投入是否划算,以及能否交付整批结果。作者称后者为bottling(封装)。
- 封装产物不只有小模型。 Agent可以选择规则程序、检索索引、小模型或混合方案。论文给出完整的未标注工作量,让Agent在有限资源内自行决定实现方式。
构建投入(探索、标注、训练、验证) → 可复用产物(程序/小模型/索引/混合) → 应用到整批输入。FieldToFit据§3.1整理;构建投入与执行调用分别记录。
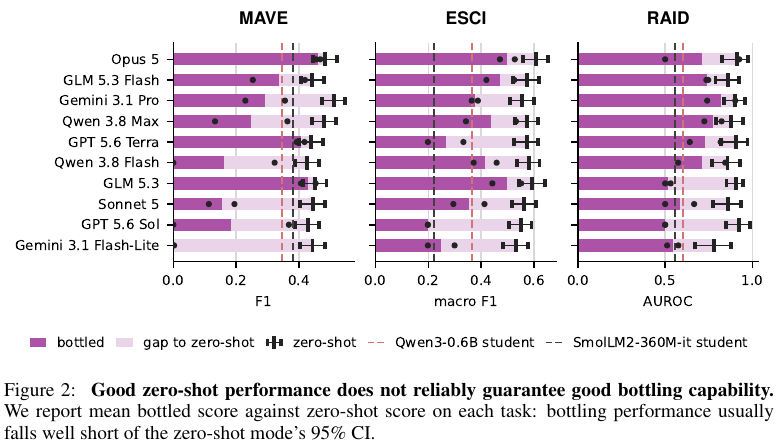 报告原图2 · PDF第6页 · v1 · Ankit Sonthalia、Haritz Puerto、Alexander Rubinstein、Martin Gubri、Seong Joon Oh;FieldToFit截取原PDF,仅裁白边,图内未改写 · CC BY 4.0
Agent in a Bottle — 原始PDF v1 · PDF第6页 · figure-2
关键证据:60轮封装中,48轮低于对应零样本95%置信区间下界。
- 看质量差距。 原图2中紫色是封装质量,浅紫是与零样本的差距,黑色区间是零样本95%置信区间。封装经常没有保住模型原有的答题能力。
- 看不同任务。 MAVE用F1,ESCI用macro-F1,RAID用AUROC。三列应分别解读,不能把不同指标直接混成一个排名。
原文定义摘录:“the same question is asked about each of them.”
§3.1:输入内容可以不同,但整个工作量反复回答的是同一个问题。译文为本站整理。
- MAVE:商品属性提取 · 477万对 · F1
- ESCI:查询—商品相关性 · 262万对 · macro-F1
- RAID:AI文本检测 · 562万篇 · AUROC
- 运行规模。 10个模型、3种任务,每个模型任务运行两次,共60轮封装。
- 资源限制。 OpenCode、单张A100 40GB、8 CPU核、64GB RAM;每轮10小时、500万加权token。未缓存输入、缓存输入、输出的权重分别为1、0.1、2;只能调用被测模型自身的API,不能读取真标签。
- 交付要求。 预算内交付完整输出;缺失预测使用不含实例信息的回退答案评分。产物执行仍消耗计算资源。
Agent in a Bottle — 作者完整技术报告v1 · §3.1–3.4、§4.1、图2
返回核心结论2. 可复用产物能大幅降低API费用,但要同时看质量损失
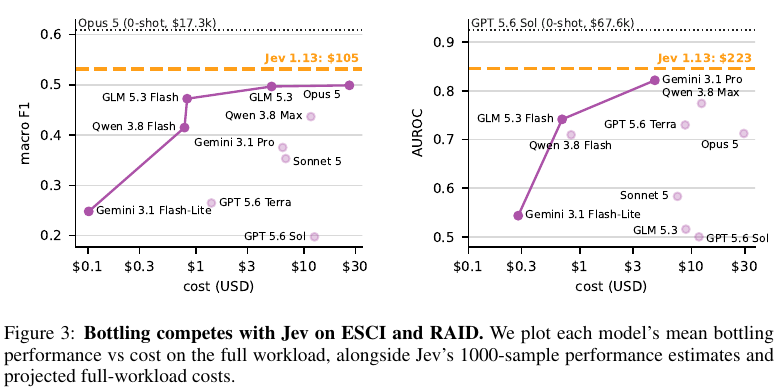 报告原图3 · PDF第9页 · v1 · Ankit Sonthalia、Haritz Puerto、Alexander Rubinstein、Martin Gubri、Seong Joon Oh;FieldToFit截取原PDF,仅裁白边,图内未改写 · CC BY 4.0
Agent in a Bottle — 原始PDF v1 · PDF第9页 · figure-3
- 与逐条大模型比较。 ESCI上,Opus 5产物的macro-F1为0.499,逐条调用为0.609,约保留其82%。报告封装费用为$26.28;逐条调用的整批外推费用为$17,273,约高657倍。
- 与Jev比较。 Jev的macro-F1为0.531,整批外推费用为$104.89;该产物约保留其94% macro-F1,论文费用约为四分之一。
- 图中的费用怎么读。 左图为ESCI、右图为RAID;横轴是对数刻度。橙色虚线是Jev,顶部点线是零样本参考;紫色连线是封装结果的Pareto前沿。
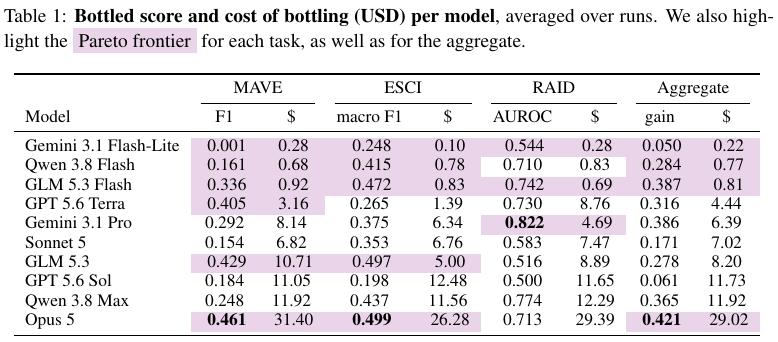 报告原表1 · PDF第7页 · v1 · Ankit Sonthalia、Haritz Puerto、Alexander Rubinstein、Martin Gubri、Seong Joon Oh;FieldToFit截取原PDF,仅裁白边,图内未改写 · CC BY 4.0
Agent in a Bottle — 原始PDF v1 · PDF第7页 · table-1
适用边界:657倍是论文API费用口径的比较,不代表同等质量下的完整生产成本收益。
- 评测范围不同。 产物质量为两次全量评测均值;逐条调用与Jev使用共同1000条样本。82%是macro-F1的比值,不是准确率。
- 成本范围有限。 费用采用论文记录的2026年9月价格,不包含完整GPU、部署和维护费用;逐条调用及Jev费用是整批外推。
Agent in a Bottle — 作者完整技术报告v1 · §1、§4.2、图3、表1、附录A/E
返回核心结论3. 自主Agent未必胜过简单的固定蒸馏流程
关键证据:31/60轮封装不及较强蒸馏学生,21/60轮同时不及两个学生。
- 对照流程很简单。 GLM 5.3 Flash随机抽样标注,再按公开配方训练Qwen3-0.6B和SmolLM2-360M-Instruct;不做自主决策,也不按任务专门调参。
- 对照也有相同的token预算。 标注使用500万加权token,每个学生做三次独立训练/评测。原图2中的两条竖虚线表示两名蒸馏学生。
- 作者要表达的判断。 把预算交给自主Agent,并不保证得到比固定蒸馏更好的结果。这两类统计有包含关系,不能相加成一个失败率。
比较条件: 相同token预算不等于相同美元或硬件成本;这里比较的是这三种任务和作者设定下的表现。
Agent in a Bottle — 作者完整技术报告v1 · §3.5.2、§4.1、图2、附录B
返回核心结论4. 给Agent更多预算,不能普遍补齐封装能力
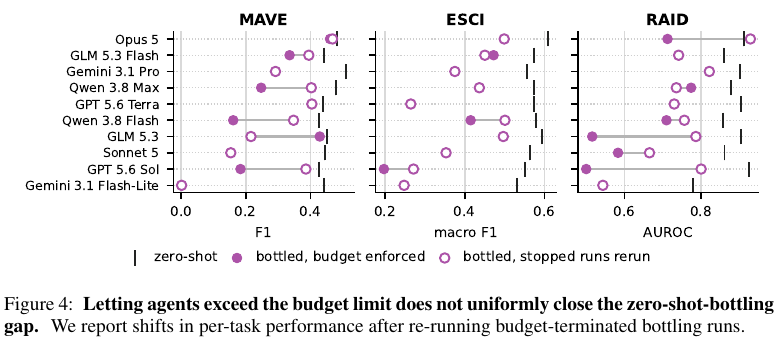 报告原图4 · PDF第9页 · v1 · Ankit Sonthalia、Haritz Puerto、Alexander Rubinstein、Martin Gubri、Seong Joon Oh;FieldToFit截取原PDF,仅裁白边,图内未改写 · CC BY 4.0
Agent in a Bottle — 原始PDF v1 · PDF第9页 · figure-4
- 作者怎样测试。 重跑21轮因预算停止的实验,取消强制停止,再替换对应原运行;低于零样本95%区间的运行从48/60变为47/60。
- 更多预算确实能帮助部分运行。 图4的实心紫点是原封装,空心紫点是重跑,黑线是零样本。部分模型明显改善,但整体差距没有消失。
- 有些失败与额度无关。 一次ESCI运行中,Gemini 3.1 Flash-Lite把工具截断显示的49条记录当成数百万条的全部,只提交49条答案便标记完成;当时还剩约495万token预算。
作者结论:除预算管理外,还要检查输入理解、方案选择与整批交付是否正确。
- 仅三种任务,每个模型任务两次封装运行;零样本区间由1000条样本、2000次bootstrap估算。
- 8轮预算耗尽且未交付要求输出,不等于所有预算停止的21轮;未交付完整文件也不等于完全没有预测。
- 均为作者实验,FieldToFit尚未独立复现。
Agent in a Bottle — 作者完整技术报告v1 · §4.3、图4
返回核心结论