Qwen-Image-PE:提示增强怎样学会设计,为什么扩写也会退步?
Qwen-Image-PE:提示增强怎样学会设计,为什么扩写也会退步?
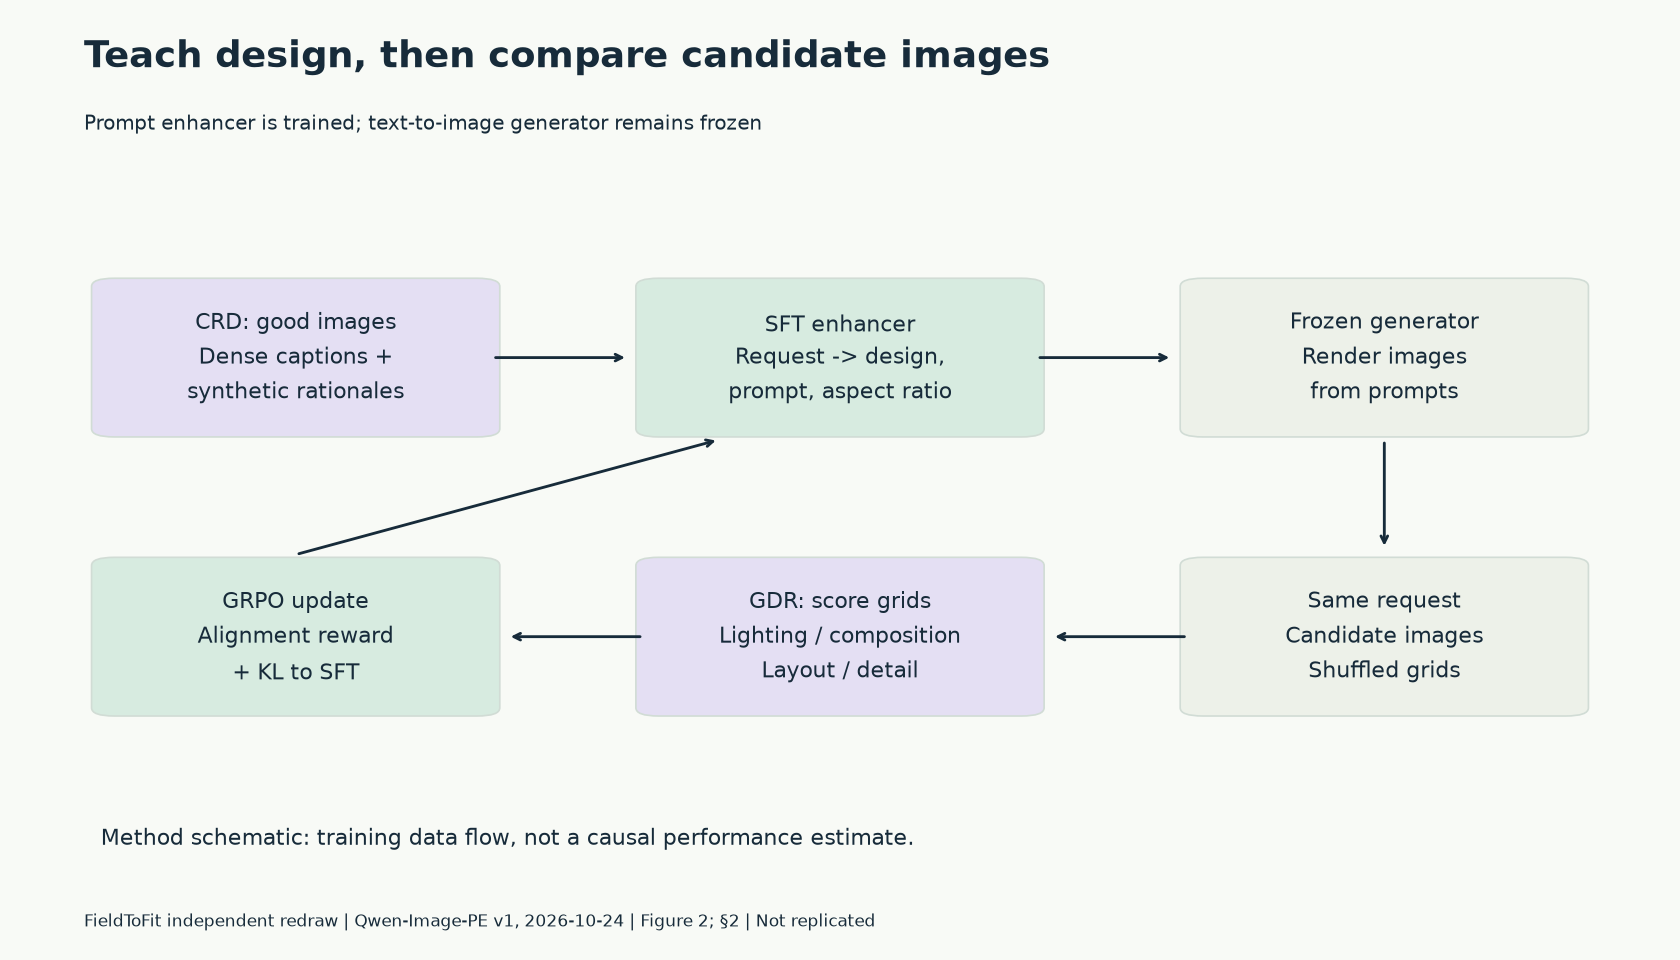
CRD把高质量图像变成密集描述监督;生成主干保持冻结,增强器学习补足灯光、构图、布局与细节。
作者评测,本站未独立复现。397B为内部模型;同主干结果、信息密度消融与跨主干迁移各有条件,不等于所有请求更好或生产成本更低。
本次变化:首次完整分析:四条结论与同号论述、三张本站重绘,保留训练、同主干分数、密度退步与迁移限制。
Qwen-Image-PE:提示增强怎样学会设计,为什么扩写也会退步?
- 先从好图反推设计,再把设计能力交给提示增强器
CRD把高质量图像变成密集描述监督;生成主干保持冻结,增强器学习补足灯光、构图、布局与细节。
- 同组图像一起比较,比逐张评分更有用,仍有评判偏差
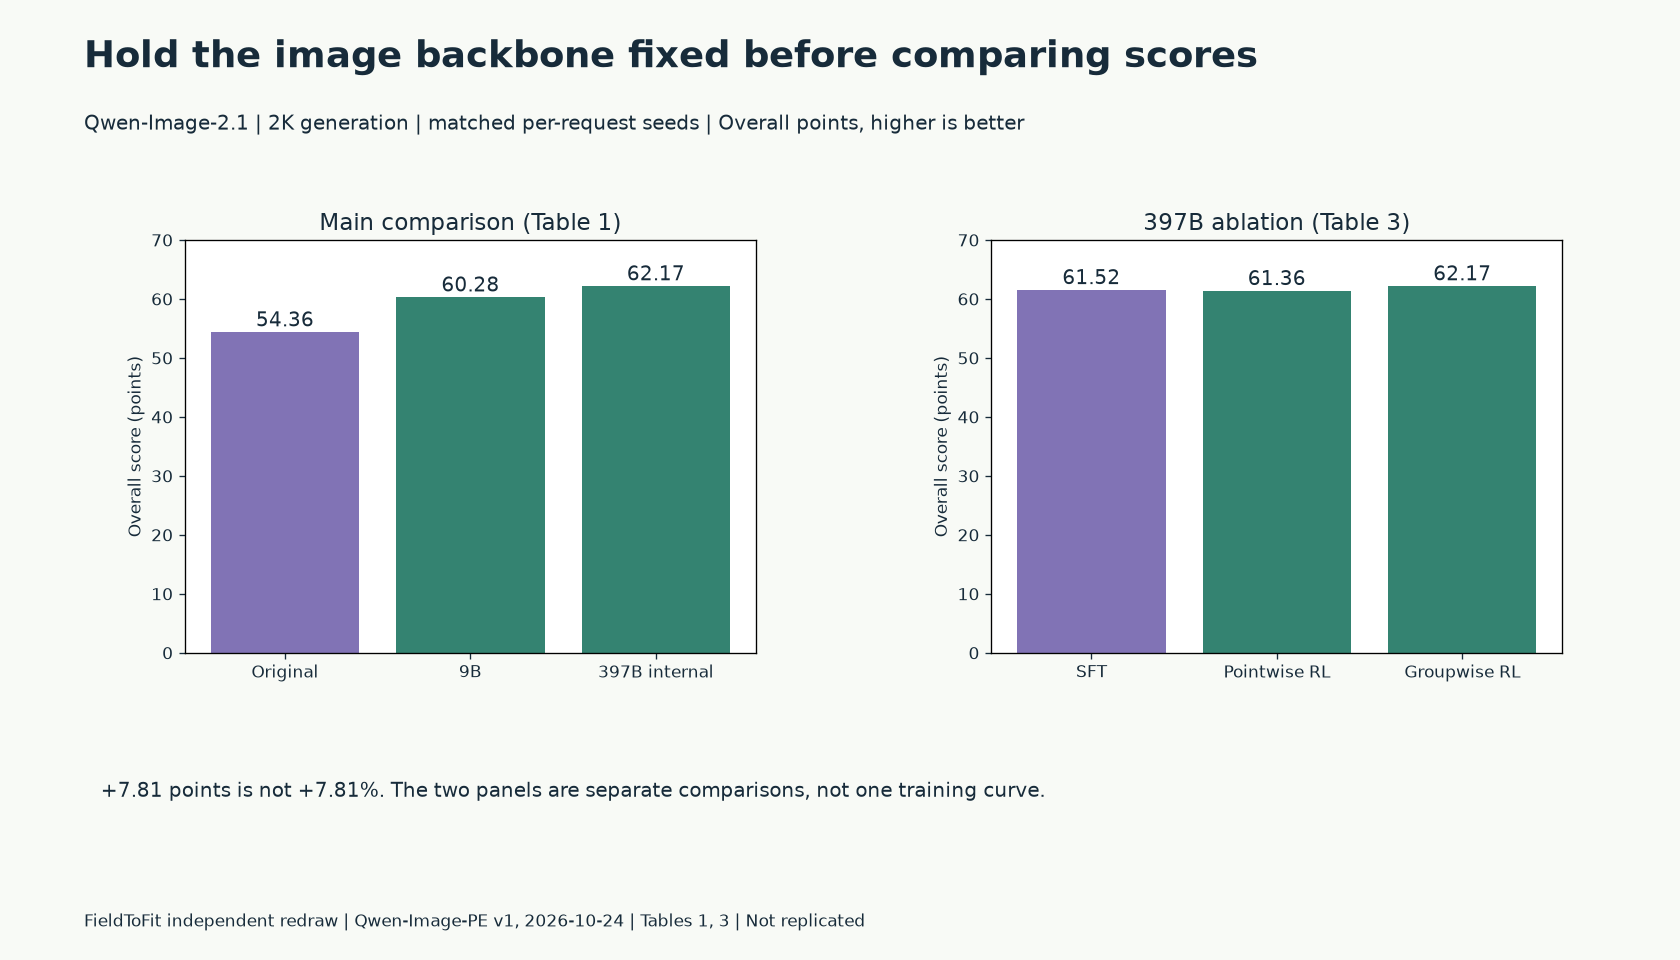
GDR用网格与多次打乱比较同请求候选,设计奖励加意图对齐;Overall比SFT高 0.65分,不能写成训练收益无限扩大。
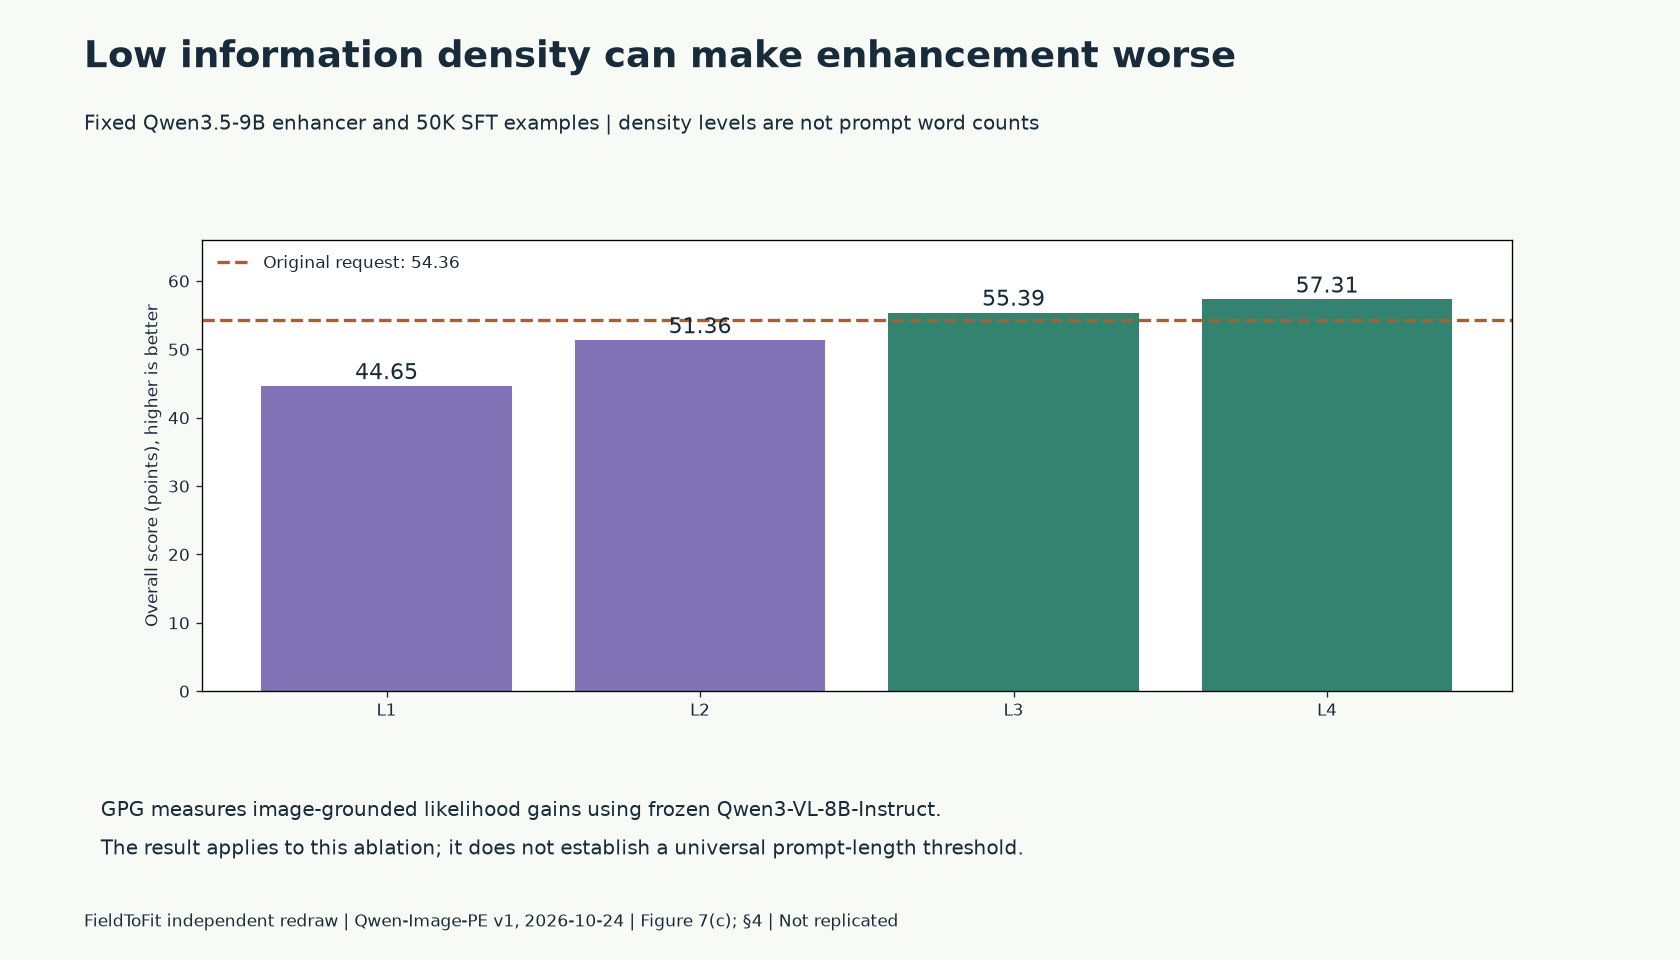
- 有效信息密度不足时,扩写可以比原请求更差
同主干 9B为 60.28、内部 397B为 62.17;低信息密度消融只有 44.65和 51.36,均低于原请求 54.36。
- 跨四个主干的迁移成立,生产采用还需验证意图与代价
两种增强器在四个测试主干均超过原请求;9B有发布入口,397B是内部模型,不能据论文许可推断权重许可。
4. 跨四个主干的迁移成立,生产采用还需验证意图与代价
表 5将增强器迁移到FLUX.2-dev、Krea 2 Turbo、HunyuanImage-2.1及FLUX 3 Image Klein,未访问这些目标主干的训练描述。每个主干内部,9B和 397B的Overall都超过原请求;在Hunyuan与FLUX 3两组也超过各自原生增强器。该设计支持可迁移视觉设计的解释,不能外推到所有模型或所有用户请求。
- FLUX.2-dev:原请求 50.52,9B增强 53.05,397B增强 54.38。
- Krea 2 Turbo:原请求 49.76,9B增强 55.06,397B增强 56.28。
- HunyuanImage-2.1:原请求 44.48,9B增强 51.04,397B增强 51.66。
- FLUX 3 Image Klein:原请求 51.07,9B增强 57.81,397B增强 59.10。
9B由Qwen3.5-9B初始化,397B由Qwen3.5-397B-A17B初始化,后者在表 1标为内部模型。论文链接 9B权重发布页,但本站未完成权重许可证、显存、吞吐和费用核验,不提供未经验证的部署门槛。论文CC BY 4.0只说明论文材料许可,本站配图为独立重绘。
作者结论:本站建议:固定图像主干、种子与请求,检查显式约束是否被扩写改写,再盲评画面、延迟和费用。创作工具应保留查看/修改增强提示和回退原请求的路径。以上是采用建议,不属于作者实验结果。
Qwen-Image-PE: Learning Visual Design for Text-to-Image Prompt Enhancement v1 · §3.1; Table 1; §5; Table 5
返回核心结论
Qwen档案