Qwen-Audio-3.1-ASR:从转写到对话结构,先选对变体再比较分数
Qwen-Audio-3.1-ASR:从转写到对话结构,先选对变体再比较分数
Flash与Next的非流式接口支持说话人结构;泛音频理解仅由Next提供,Streaming与Message都不支持这两项。
作者评测,未独立复现;能力按部署变体区分,跨来源分数、分块说话人测试与异构延迟测试均有适用边界。
本次变化:首次完整分析:四条结论与同号论述,三张本站重绘,保留变体、训练、评测与部署边界。
方法、实验与证据
同一家族有五种形态,实时转写不自动拥有全部能力
- 机制
- Flash与Next的非流式接口支持说话人结构;泛音频理解仅由Next提供,Streaming与Message都不支持这两项。
- 条件/配置
- Five deployment profiles; Table 1; ASR / SD / AU / context / hotwords / polishing.
- 报告结果
- Flash与Next的非流式接口支持说话人结构;泛音频理解仅由Next提供,Streaming与Message都不支持这两项。
- 局限
- 作者评测,未独立复现;能力按部署变体区分,跨来源分数、分块说话人测试与异构延迟测试均有适用边界。
Qwen-Audio-3.1-ASR Technical Report v1 · §1; §2.1–2.4; Table 1; §4
说话人和时间不是事后装饰,而是训练目标的一部分
- 机制
- 系统联合输出内容、说话人标签和时间边界;稀疏标签需要专门监督,80ms网格不等于 80ms实测精度。
- 条件/配置
- Six training stages; sparse speaker-token loss weighting; 80ms representation grid.
- 报告结果
- 系统联合输出内容、说话人标签和时间边界;稀疏标签需要专门监督,80ms网格不等于 80ms实测精度。
- 局限
- 作者评测,未独立复现;能力按部署变体区分,跨来源分数、分块说话人测试与异构延迟测试均有适用边界。
Qwen-Audio-3.1-ASR Technical Report v1 · §2.2; §3; §3.4
多语种与会议结果要看同口径,升级并非处处领先
- 机制
- 七语言宏平均 22.50%→15.09%与四分钟会议分块结果分别成立;CER、WER、DER和cpWER不可混成总分。
- 条件/配置
- GigaSpeechBench seven-language macro; Panel A/B split; four approximately 4-minute meeting-chunk sets.
- 报告结果
- 七语言宏平均 22.50%→15.09%与四分钟会议分块结果分别成立;CER、WER、DER和cpWER不可混成总分。
- 局限
- 作者评测,未独立复现;能力按部署变体区分,跨来源分数、分块说话人测试与异构延迟测试均有适用边界。
Qwen-Audio-3.1-ASR Technical Report v1 · §5.1 Tables 2–3; §5.8 Table 7
低延迟、润色和声音理解,各自需要独立的采用验证
- 机制
- 100ms首字延迟受异构部署条件约束;润色可读性与忠实性、声音问答与时间定位分别评估。
- 条件/配置
- 10 concurrent streams; H100 self-host vs API; internal five-point polishing ratings; accuracy and mIoU distinct.
- 报告结果
- 100ms首字延迟受异构部署条件约束;润色可读性与忠实性、声音问答与时间定位分别评估。
- 局限
- 作者评测,未独立复现;能力按部署变体区分,跨来源分数、分块说话人测试与异构延迟测试均有适用边界。
Qwen-Audio-3.1-ASR Technical Report v1 · §5.4–5.7; §5.9 Table 8
Qwen-Audio-3.1-ASR:从转写到对话结构,先选对变体再比较分数
- 同一家族有五种形态,实时转写不自动拥有全部能力
Flash与Next的非流式接口支持说话人结构;泛音频理解仅由Next提供,Streaming与Message都不支持这两项。
- 说话人和时间不是事后装饰,而是训练目标的一部分
系统联合输出内容、说话人标签和时间边界;稀疏标签需要专门监督,80ms网格不等于 80ms实测精度。
- 多语种与会议结果要看同口径,升级并非处处领先
七语言宏平均 22.50%→15.09%与四分钟会议分块结果分别成立;CER、WER、DER和cpWER不可混成总分。
- 低延迟、润色和声音理解,各自需要独立的采用验证
100ms首字延迟受异构部署条件约束;润色可读性与忠实性、声音问答与时间定位分别评估。
1. 同一家族有五种形态,实时转写不自动拥有全部能力
报告将系统目标从“把语音写成文字”扩展为识别内容、说话人及时间关系,并进一步理解环境声、音乐和声音事件。基础架构由音频编码器、适配器与语言模型解码器组成,任务指令决定输出形式;可选历史文本、目标语言和热词用于条件控制。统一架构并不意味着接口能力相同。
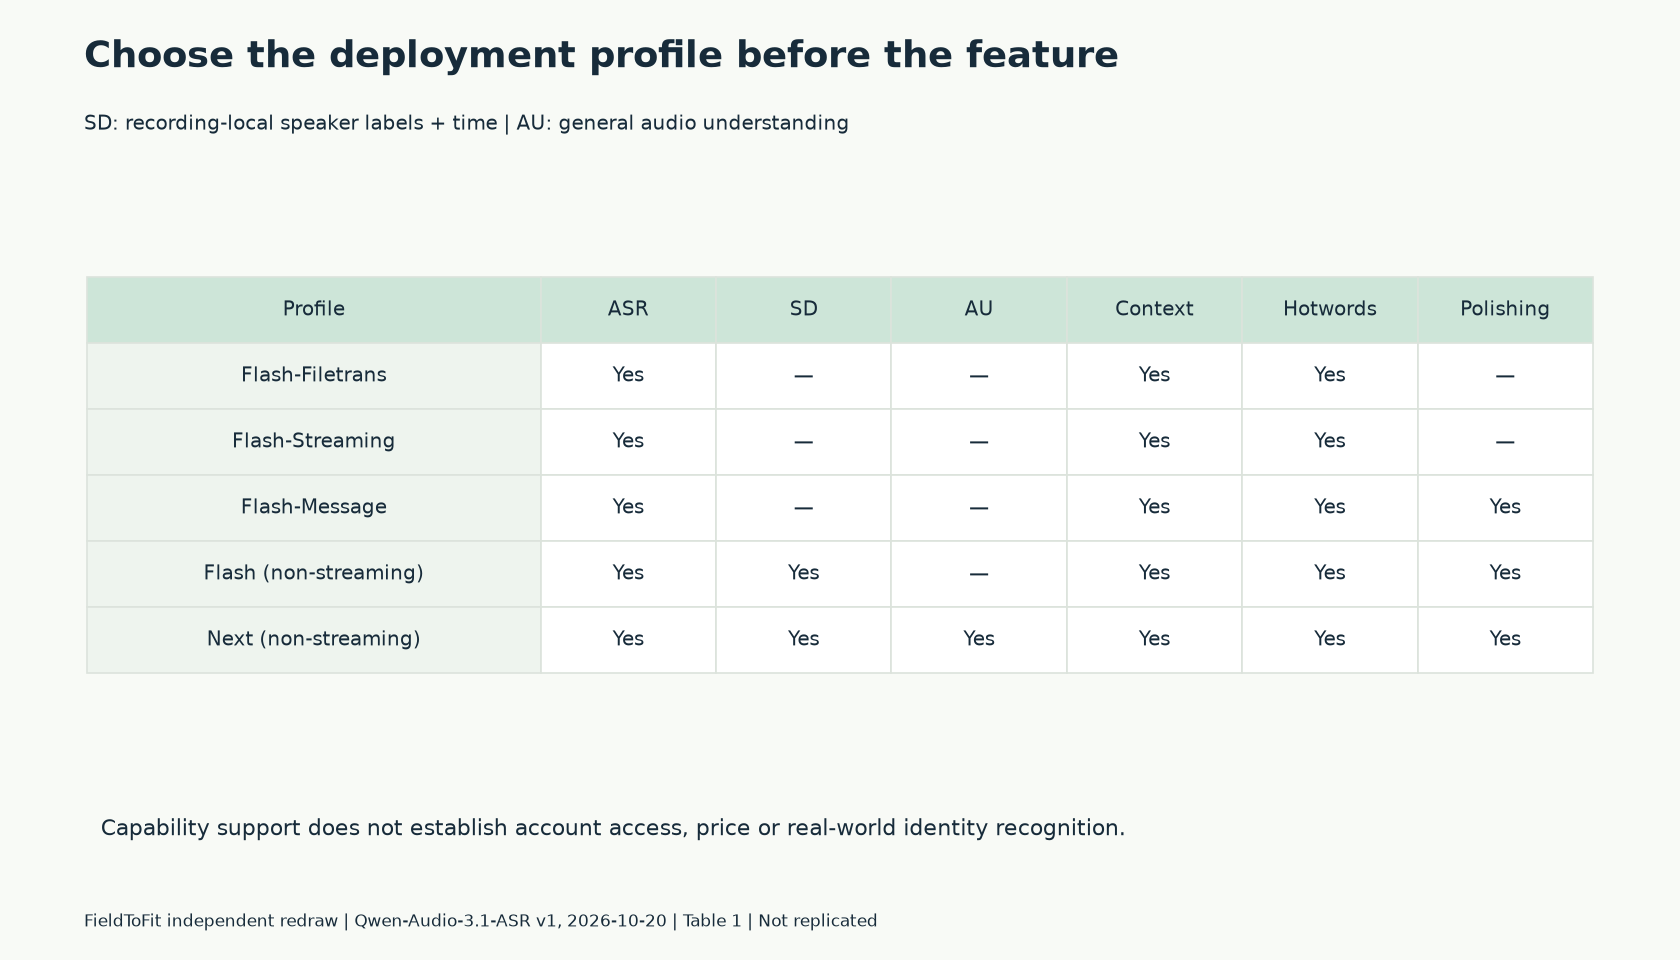 本站依据表 1独立重绘。支持矩阵描述报告中的能力,不代表账户已开放或相同定价。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts and method schematic; original artwork is not reproduced.
Qwen-Audio-3.1-ASR Technical Report v1 · §2.4 Table 1; §4
- Filetrans面向异步文件转写,Streaming面向实时转写:两者支持上下文与热词,但不支持说话人结构、泛音频理解或原生润色。
- Message面向语音输入,增加原生润色与句尾刷新;它仍然不是带说话人结构的会议转写接口。
- 非流式Flash同时提供ASR、说话人结构、上下文、热词与润色;Next在此基础上增加泛音频理解。报告保留 30种语言、16种中文方言的支持范围。
适用边界:录音内的说话人标签用于区分发言者,不代表识别真实身份;项目页是录制示例,不是本站在线推理测试。
Qwen-Audio-3.1-ASR Technical Report v1 · §1; §2.1–2.4; Table 1; §4
返回核心结论2. 说话人和时间不是事后装饰,而是训练目标的一部分
作者将说话人转写表示为一组语段:开始时间、结束时间、说话人标签及文本。不同说话人的区间可以重叠,所以只把平面文字按句切开无法保留全部对话结构。辅助CTC分支提供初步识别及粗对齐,它不等于最终说话人转写或声音事件边界。
训练分六阶段:音频编码器预训练、音频语言模型预训练、LLM冷却适配、监督微调、强化学习和多教师在线策略蒸馏。编码器先用BEST-RQ自监督,再接有监督音频文字任务;后续适配将声学证据接入Qwen MoE解码器。报告没有让读者仅靠模型家族名就确认每个部署实例的参数规模或服务配置。
说话人标签在训练token中约占 2.90%,损失贡献约 1.97%,作者将其损失权重设为 10,避免结构信号被大量转写文字淹没。时间表示调整到 80ms网格,以匹配 12.5Hz声学表示。这些是训练与表示设计;评估定位质量仍应看真实边界误差、重叠语音与说话人混淆。
作者结论:结构化输出的价值是让错误可分别检查:字词、角色和时间应分开验收,不能以一项转写错误率覆盖全部质量。
Qwen-Audio-3.1-ASR Technical Report v1 · §2.2; §3; §3.4
返回核心结论3. 多语种与会议结果要看同口径,升级并非处处领先
表 3的GigaSpeechBench七语言结果把各语言指定的CER或WER做非加权宏平均,3.0为 22.50%、3.1为 15.09%。它不是把 30种语言所有词合并后的错误率。表 2还给出升级的反例:FLEURS-en的WER由 4.17%变为 4.72%,AISHELL-1的CER由 1.03%变为 1.08%。更丰富的能力不能自动推出每个旧任务都更准。
表 2分开列官方已发表基准与统一API流程实测,前者的预处理和计分方式可能不同。跨厂商定量结论优先在Panel B内部比较;在该组 7个测试集上,Qwen在 4项最低,Fun-ASR-Flash在另外 3项最低。不应把两组拼成一个无条件排行榜。
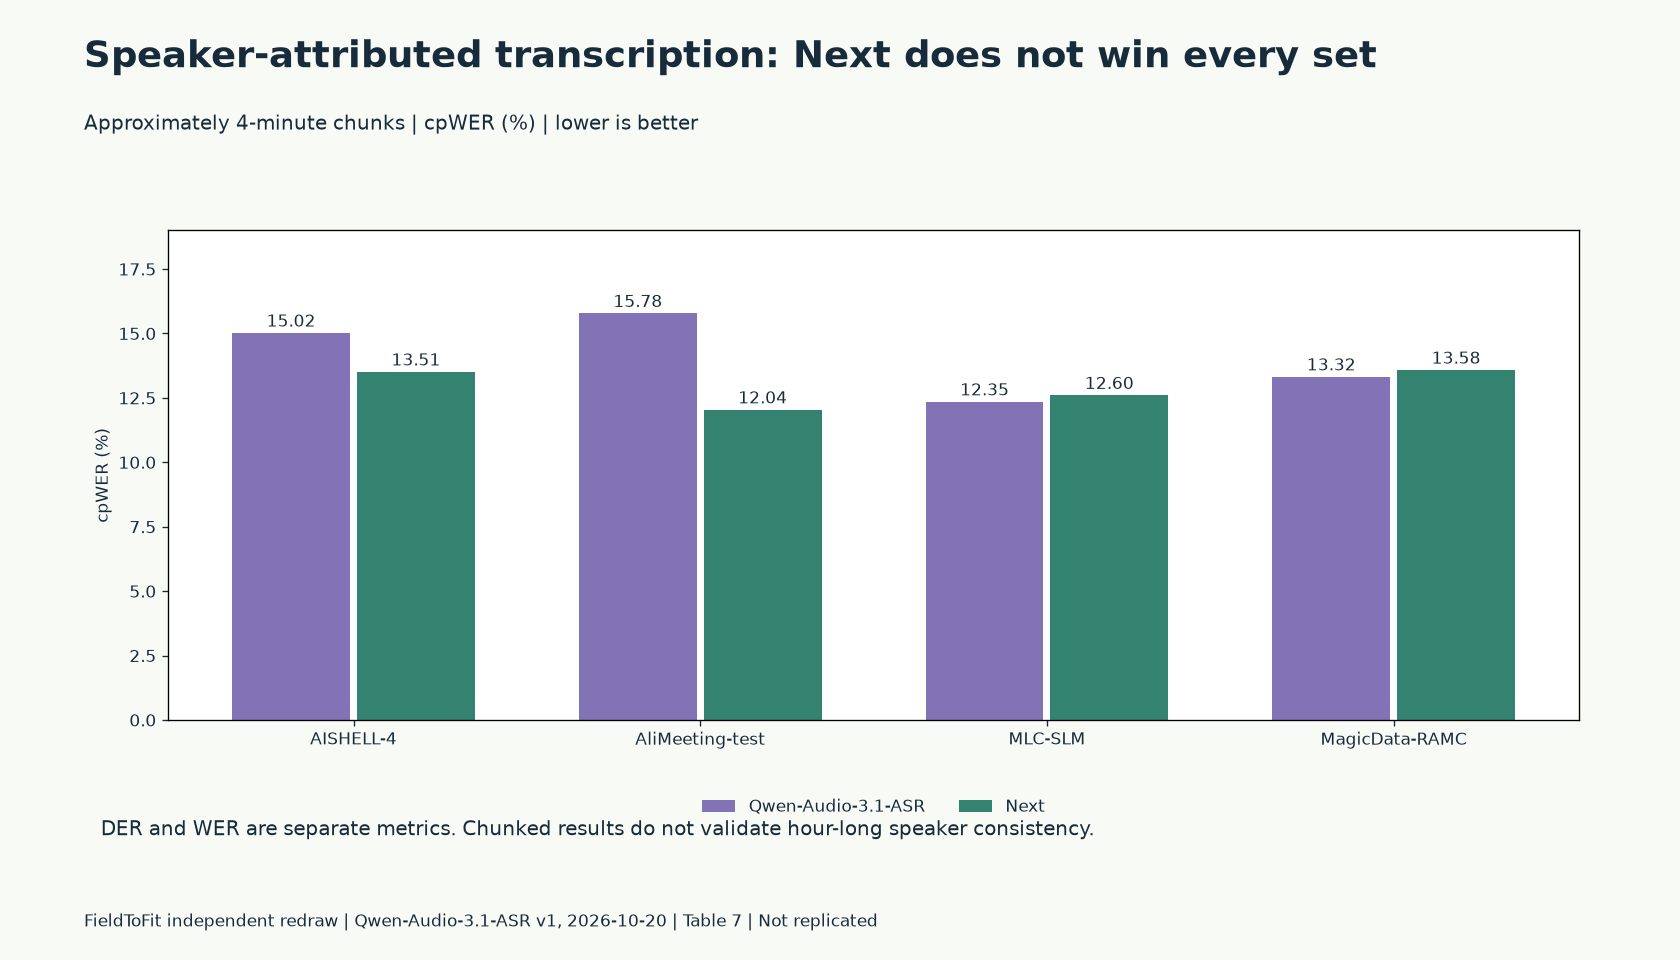 本站据表 7独立重绘;约 4分钟分块,cpWER为百分比、越低越好。未验证整小时录音的身份一致性。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts and method schematic; original artwork is not reproduced.
Qwen-Audio-3.1-ASR Technical Report v1 · §5.8 Table 7
表 7统一为约 4分钟音频块,分别报告DER(说话人分离错误)、WER(转写词错误)和cpWER(考虑角色排列后的拼接词错误)。AliMeeting-test的cpWER,基础版为 15.78%、Next为 12.04%;MagicData-RAMC则基础版 13.32%、Next 13.58%。因此Next并非每集每项更优;分块结果也不足以证明整场会议跨小时的标签一致性。
Qwen-Audio-3.1-ASR Technical Report v1 · §5.1 Tables 2–3; §5.8 Table 7
返回核心结论4. 低延迟、润色和声音理解,各自需要独立的采用验证
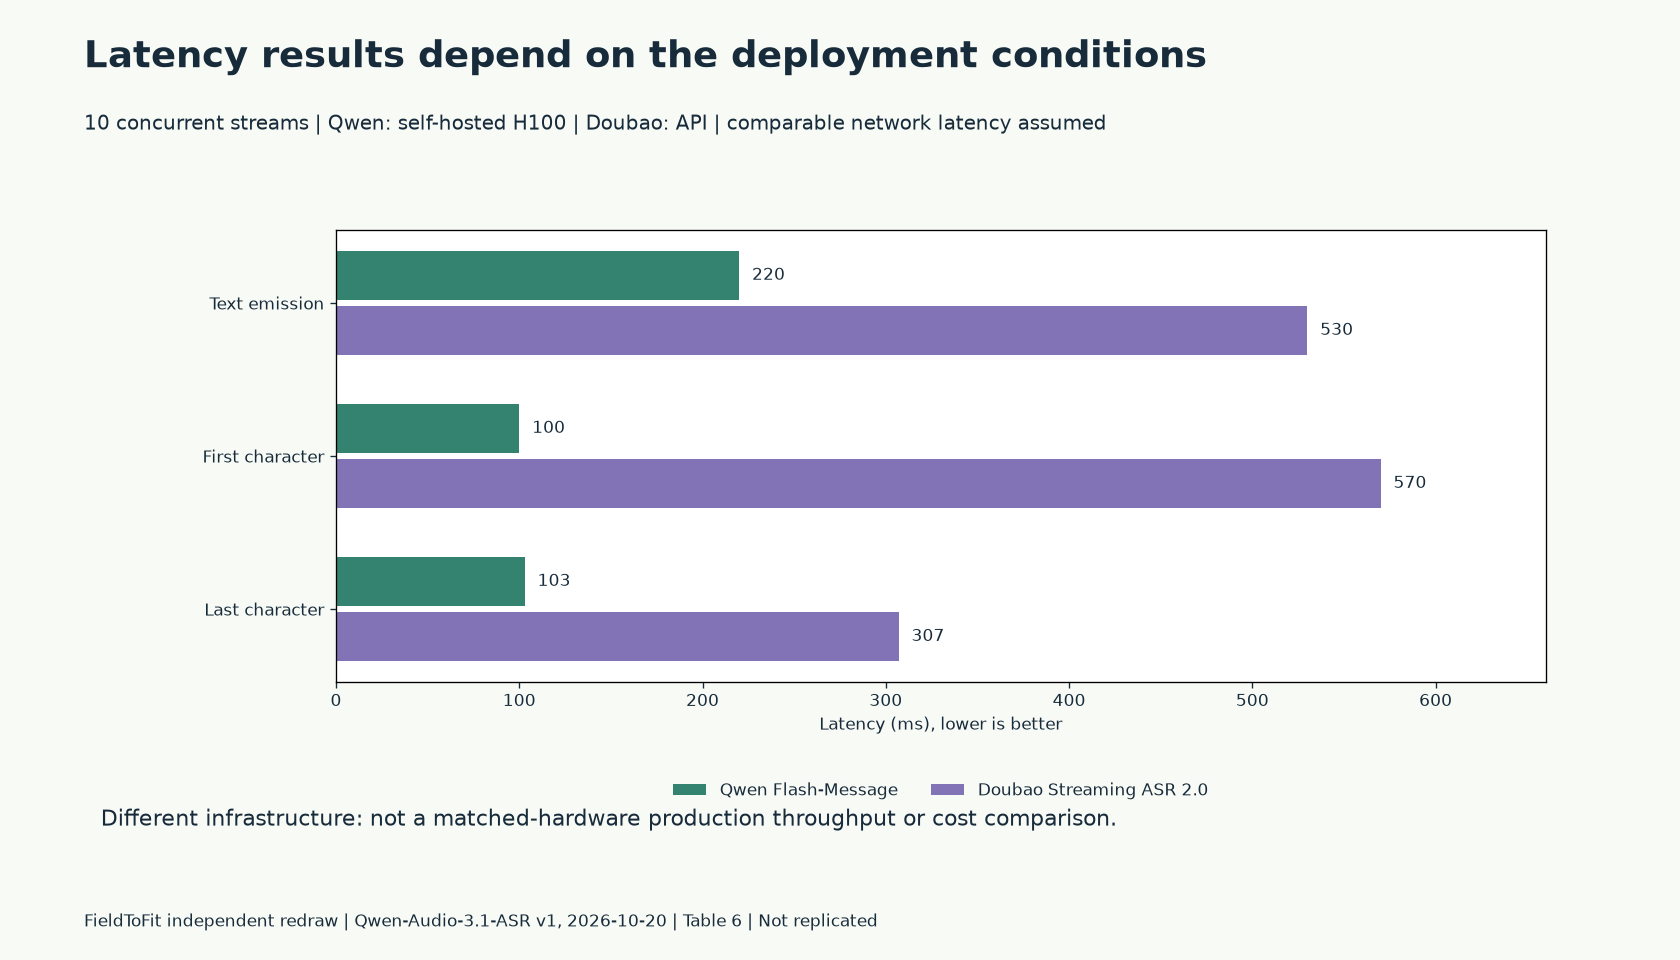 本站据表 6重绘;单位ms、越低越好。10路并发;Qwen使用H100自部署,Doubao使用API;作者假设网络延迟相当。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts and method schematic; original artwork is not reproduced.
Qwen-Audio-3.1-ASR Technical Report v1 · §5.7 Table 6
表 6报告出字延迟 220ms对 530ms、首字 100ms对 570ms、尾字 103ms对 307ms,分别对应Qwen Message与Doubao Streaming ASR 2.0。作者使用 10路并发,Qwen为NVIDIA H100自部署、豆包为API,并假设网络延迟相当。三个数值描述不同阶段,不能选择最有利的一项就宣称生产系统全面快 5.7倍;也不是相同硬件和负载下的吞吐或成本比较。
原生润色在内部五点评分中把可读性从 2.53提高到 3.44,但忠实性从原始转写 3.51变为 3.44。它是输出目标的取舍,不应默认适合法律证词或逐字引文。长上下文纠错表展示早先词语如何帮助后文识别,属于定性例子,不能替代公开测试集的整体增益。
Next泛音频理解包含描述、时间定位与问答。表 8的MMAU准确率为 81.60%,MMSU为 82.24%;后者仍低于Gemini-3.1-Pro的 85.30%。Clotho-Moment和DESED的 82.20与 66.60采用mIoU%,不能与问答准确率混比。公开基准提供任务线索,未覆盖本站的噪声环境、领域术语、隐私与账户开放条件。
Qwen-Audio-3.1-ASR Technical Report v1 · §5.4–5.7; §5.9 Table 8
返回核心结论
Qwen档案