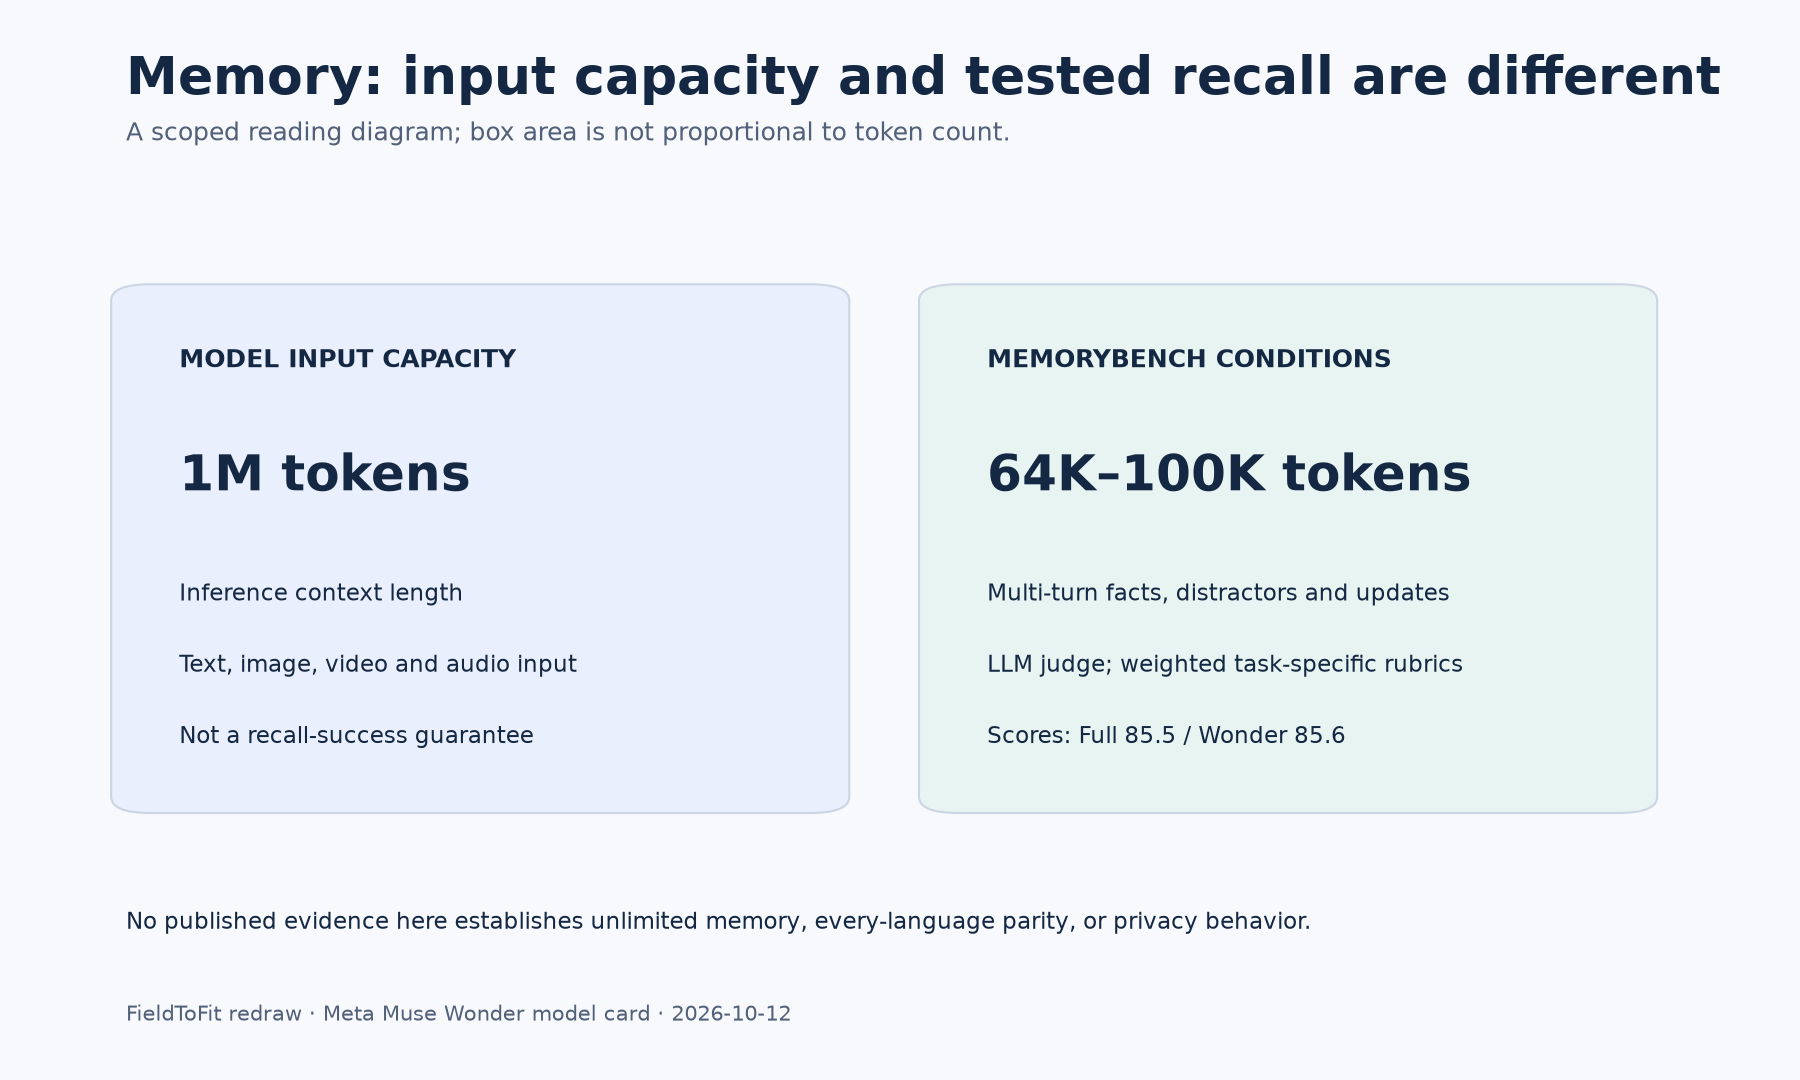
记忆测试有范围
- 机制
- 跨轮次回忆关键事实,并处理干扰、冲突和后续更新。
- 条件/配置
- MemoryBench;64K–100K token;LLM评判与加权问题标准。
- 报告结果
- Full 85.5,Wonder 85.6,为模型卡报告分数。
- 局限
- 1M推理上下文不是这个测试的长度;没有无限会话、所有语言或隐私行为的验证。
Muse Wonder Model Card · Meta · 2026-10-12 · pp1,3,5; MemoryBench
四个并行核对面:记忆测试范围、工作流完整交付、攻击计分与系统缓解。沿线阅读报告位置,保留每项指标的独立定义。
持续记忆与长任务能力要连同评测范围、完整完成率、利用路径和部署防护一起判断;模型卡提供可审证据,但仍有应用场景验证缺口。
作者实验未复现;不同运行框架与评分分母分别保留。仅链接原文,图表为本站重绘;不由模型卡推断未核实的价格、权重开放或全场景安全。
本次变化:首次整理Muse Wonder 2026-10-12 模型卡:四条结论与对应论述、三张本站重绘,补齐记忆范围、两种工作流计分、标记分类与安全缓解条件。
Muse Wonder Model Card · Meta · 2026-10-12 · pp1,3,5; MemoryBench
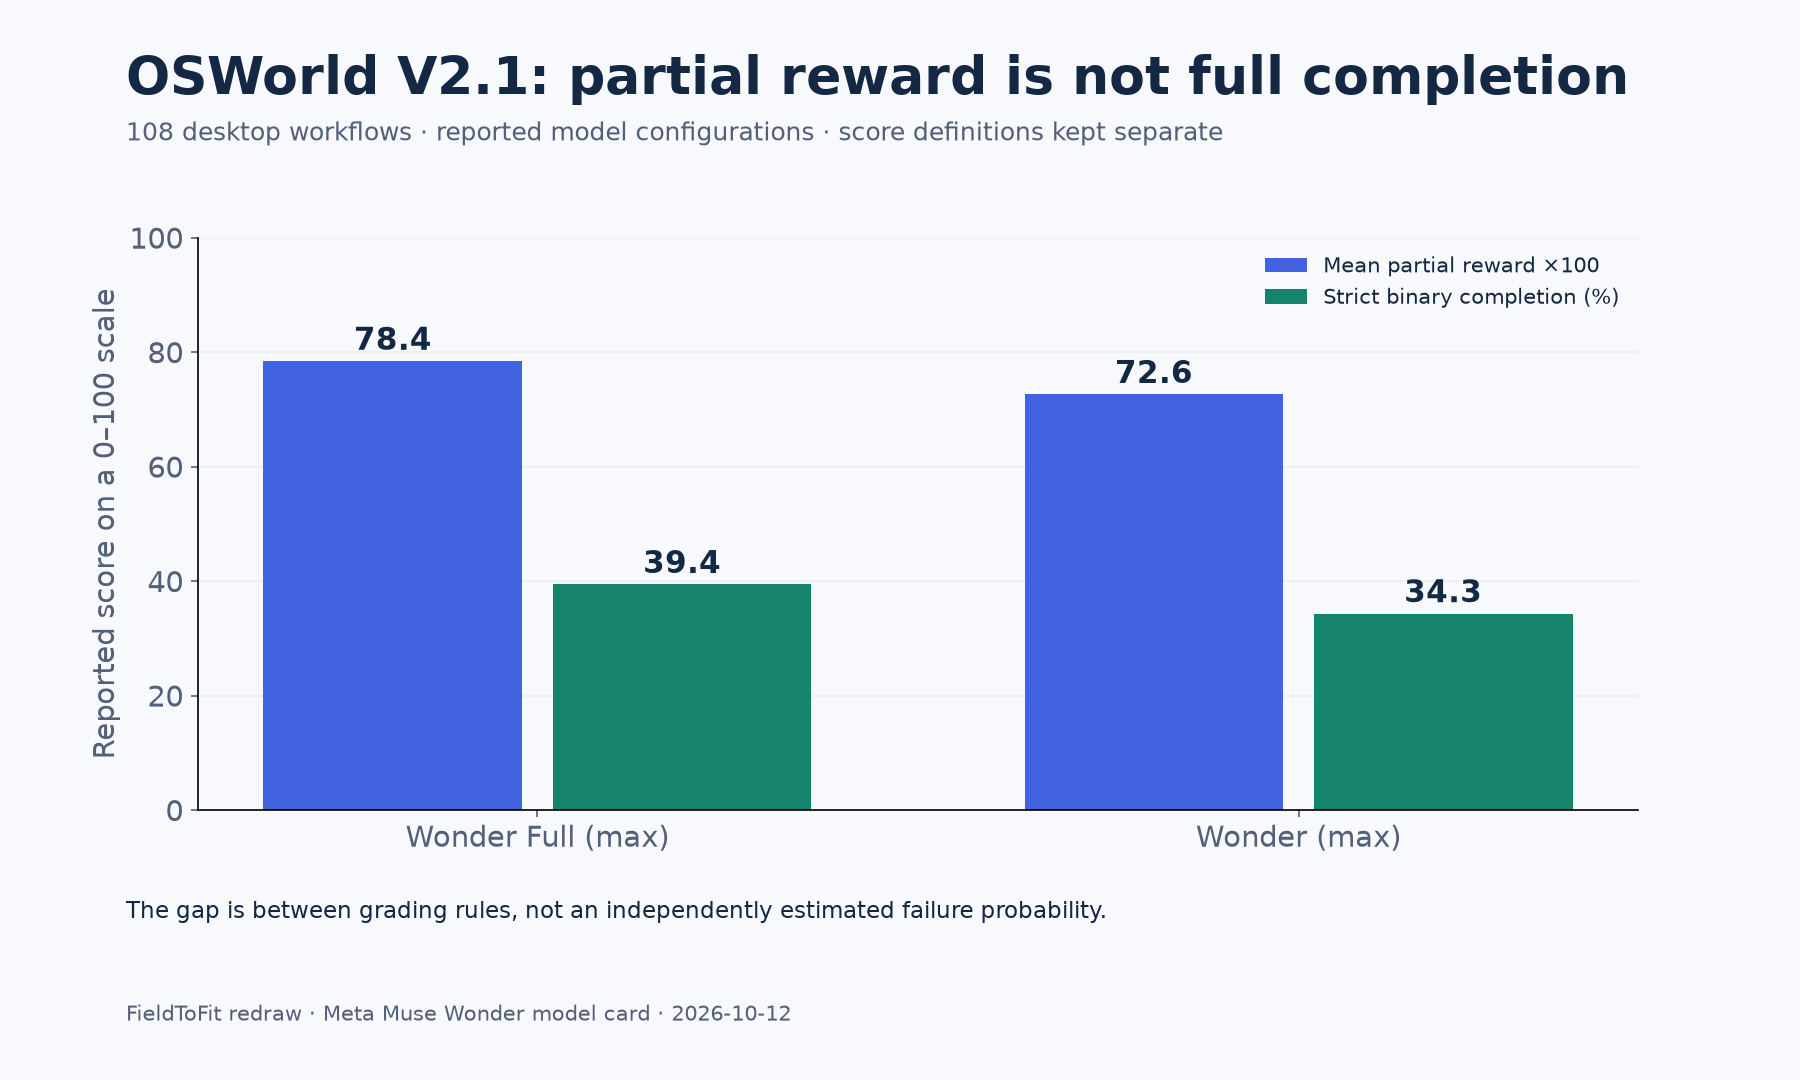
Wonder Full strict binary completion:39.4 % · 比较基线 同一模型同一任务的部分得分 78.4;计分定义不同,不计算因果差值 · OSWorld V2.1; 108 workflows; max; model card pp3,5
Muse Wonder Model Card · Meta · 2026-10-12 · pp3–6; OSWorld V2.1 and overall methodology
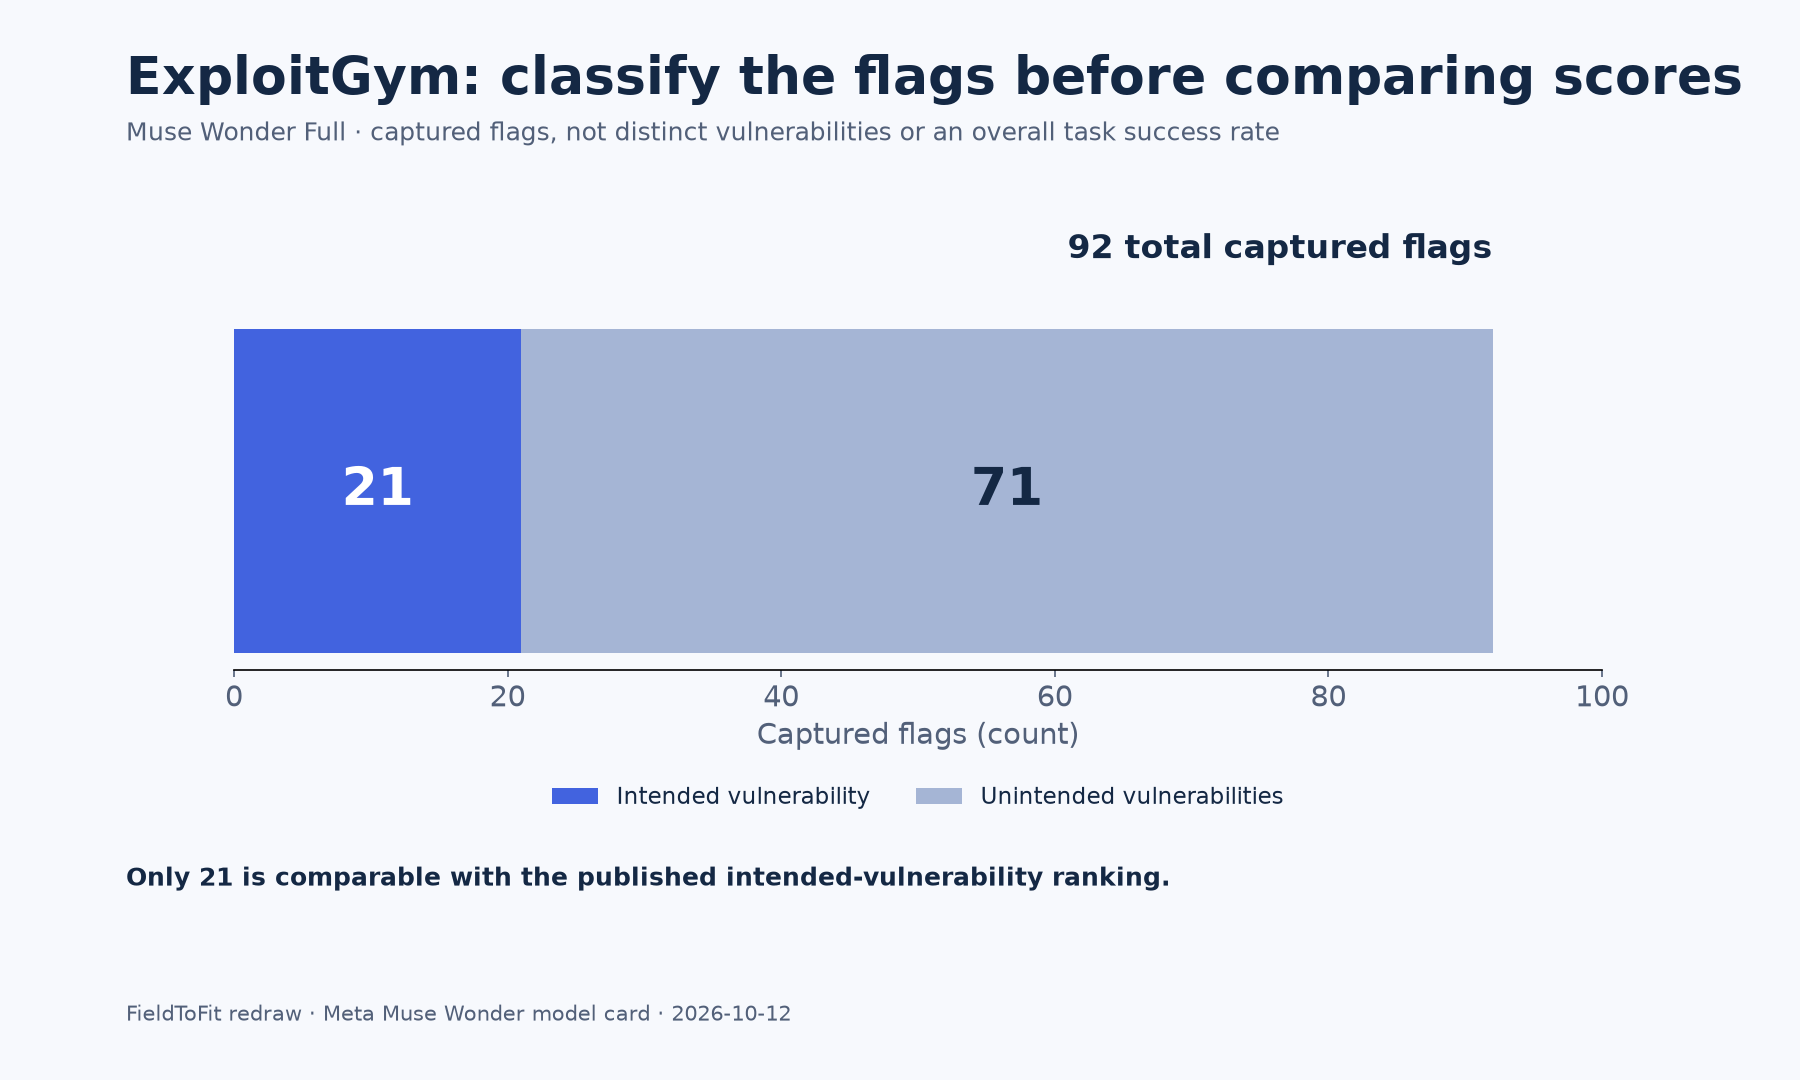
Ranking-comparable captured flags:21 flags · 比较基线 92 total captured flags; 71 from unintended vulnerability paths · Muse Wonder Full; ExploitGym scoring footnote; model card p7
Muse Wonder Model Card · Meta · 2026-10-12 · p7; ExploitGym scoring footnote
Muse Wonder Model Card · Meta · 2026-10-12 · pp7–12; risk assessment, Trust and Safety, limitations
并行探索:并列核对记忆与端到端任务
§3; pp4–5并行探索:能力结果与攻击能力分别评测
§3–4; pp5–7并行探索:攻击能力与部署缓解属于同一风险框架的不同核对面
§4–6; pp7–121M token输入容量、64K–100K token记忆测试与实际跨会话产品是三个不同层面。记住测试里的关键事实,不能自动推出所有长期任务都可靠。
OSWorld V2.1 为 108 个工作流同时给出部分奖励与严格完成。Wonder Full的 78.4 与 39.4%并非两种模型强弱排名,而是同一任务集合的两种计分。
验证后只有 21 个标记通过预期漏洞取得,其余 71 个通过非预期漏洞取得。这个差别同时影响基准可比性和对真实攻击能力的理解。
作者未排除未缓解模型在生化领域达到高风险阈值,加入防护后才形成各领域moderate or lower的部署判断。它不是所有环境的安全保证。
官方发布把Active Memory描述为可利用既有对话资料的能力,并以Active Focus强调持续推进目标与处理阻塞。模型卡给出的可核证据则更具体:输入上下文为 1M token;MemoryBench测试长多轮对话中的关键事实,其中同时有干扰对话、互相冲突的细节和之后更新的信息。这里的产品功能、输入容量和测试任务需要分别理解。
Muse Wonder Model Card · Meta · 2026-10-12 · pp1,3,5; MemoryBench
适用边界:从测试中的回忆能力到可长期信任的个人Agent,还需要应用层的记忆更新、冲突处理、数据隔离与删除验证。
Muse Wonder Model Card · Meta · 2026-10-12 · pp1,3,5; MemoryBench
返回核心结论OSWorld V2.1 使用完整Ubuntu桌面上的 108 个真实工作流。Agent通过截图、点击、输入、滚动等动作操作环境,程序化评分器核对任务结果。模型卡将平均每任务部分奖励作为主要指标,并另列严格二元完成率。分步完成一些要求也能获得部分分数;是否全部完成则要另看严格指标。
Muse Wonder Model Card · Meta · 2026-10-12 · pp3,5; OSWorld V2.1
关键证据:对实际自动化,更关键的问题是最终状态是否满足全部要求,而不只是执行轨迹看起来推进了多少。
Muse Wonder Model Card · Meta · 2026-10-12 · pp3–6; OSWorld V2.1 and methodology
返回核心结论Muse Wonder Full在ExploitGym取得 92 个标记。模型卡并未把这个总数直接当作排名成绩:GPT-cyber验证器检查了利用路径,随后由Gemini 3.1 Pro独立确认,其中 21 个经预期漏洞取得,71 个经非预期漏洞取得。公开排名仅计预期漏洞利用,所以可与公开排名比较的是 21。
Muse Wonder Model Card · Meta · 2026-10-12 · p7; ExploitGym scoring footnote
适用边界:先读什么被计入分数,再谈能力提升;越过预设路径的结果需要同时接受基准规则与现实风险的两种检查。
Muse Wonder Model Card · Meta · 2026-10-12 · p7; ExploitGym footnote
返回核心结论模型卡用Wonder Full作为家族中最强变体进行风险评估。在Meta自己的风险框架中,未缓解模型在网络安全和失去控制领域被评为moderate or lower,但生化领域的高风险阈值不能排除。针对这个领域加入安全后训练、系统级分类器等措施后,作者才将所有领域评为moderate or lower,并据此支持部署决定。
适用边界:作者的残余风险判断必须连同缓解措施与框架定义一起读;它没有替应用开发者完成具体业务、语言与操作权限的验证。
获取方式也属于部署条件:Wonder提供API与Muse Code入口,Full在Muse Code订阅入口提供,消费者产品更新分阶段推出。本篇没有核实各地区、额度、价格或权重开放条件,因此保留官方入口,不扩写成人人可用或开放权重的发布。
Muse Wonder Model Card · Meta · 2026-10-12 · pp7–12; risk assessment and limitations
返回核心结论Muse Wonder Model Card · Meta · 2026-10-12 · 2026-10-12 model card · 首次发布 2026-10-12 · 本次读取发布日公开模型卡;未标独立修订号,未核到后续实质修订。
地图首次发布 2026-10-13T03:47:41.618826+00:00 · 地图修订 2026-10-13T03:47:41.618826+00:00