先比较共同样本,避免把任务差异当成监控差异
- 机制
- 同一任务池不等于同一实际计分样本;更强模型可能在更难的任务上产生目标行为。
- 条件/配置
- 样本匹配、排序证据与监控后交付风险
- 报告结果
- 同一任务池不等于同一实际计分样本;更强模型可能在更难的任务上产生目标行为。
- 局限
- 离线历史轨迹与模拟;不是当前生产部署实测。
样本匹配、排序证据与监控后交付风险
一起报告风险、交付率与重试条件。
离线历史轨迹与模拟;不是当前生产部署实测。
本次变化:首次纳入所选报告:四结论、同号展开与三张本站图。
并行探索:分开核对方法与边界
Inverse-variance-weighted HodgeRank scores; Historical system card results; Comparison with AUROC并行探索:分开核对方法与边界
Metric 2; Offline estimation from scorecard rollouts; Risk must be read beside deployment并行探索:分开核对方法与边界
Gating reduces risk; retries give some risk back; Appendix同一任务池不等于同一实际计分样本;更强模型可能在更难的任务上产生目标行为。
HodgeRank 汇总的是有证据支持的相对差异;不连通的比较不能强行排成总榜。
每请求坏输出 B(K)、任意交付 A(K)、已交付中的坏输出 B(K)/A(K),回答三个不同问题。
增加重试会增加漏检机会;干预造成了哪些正例无法直接观察时,应给区间而非单点。
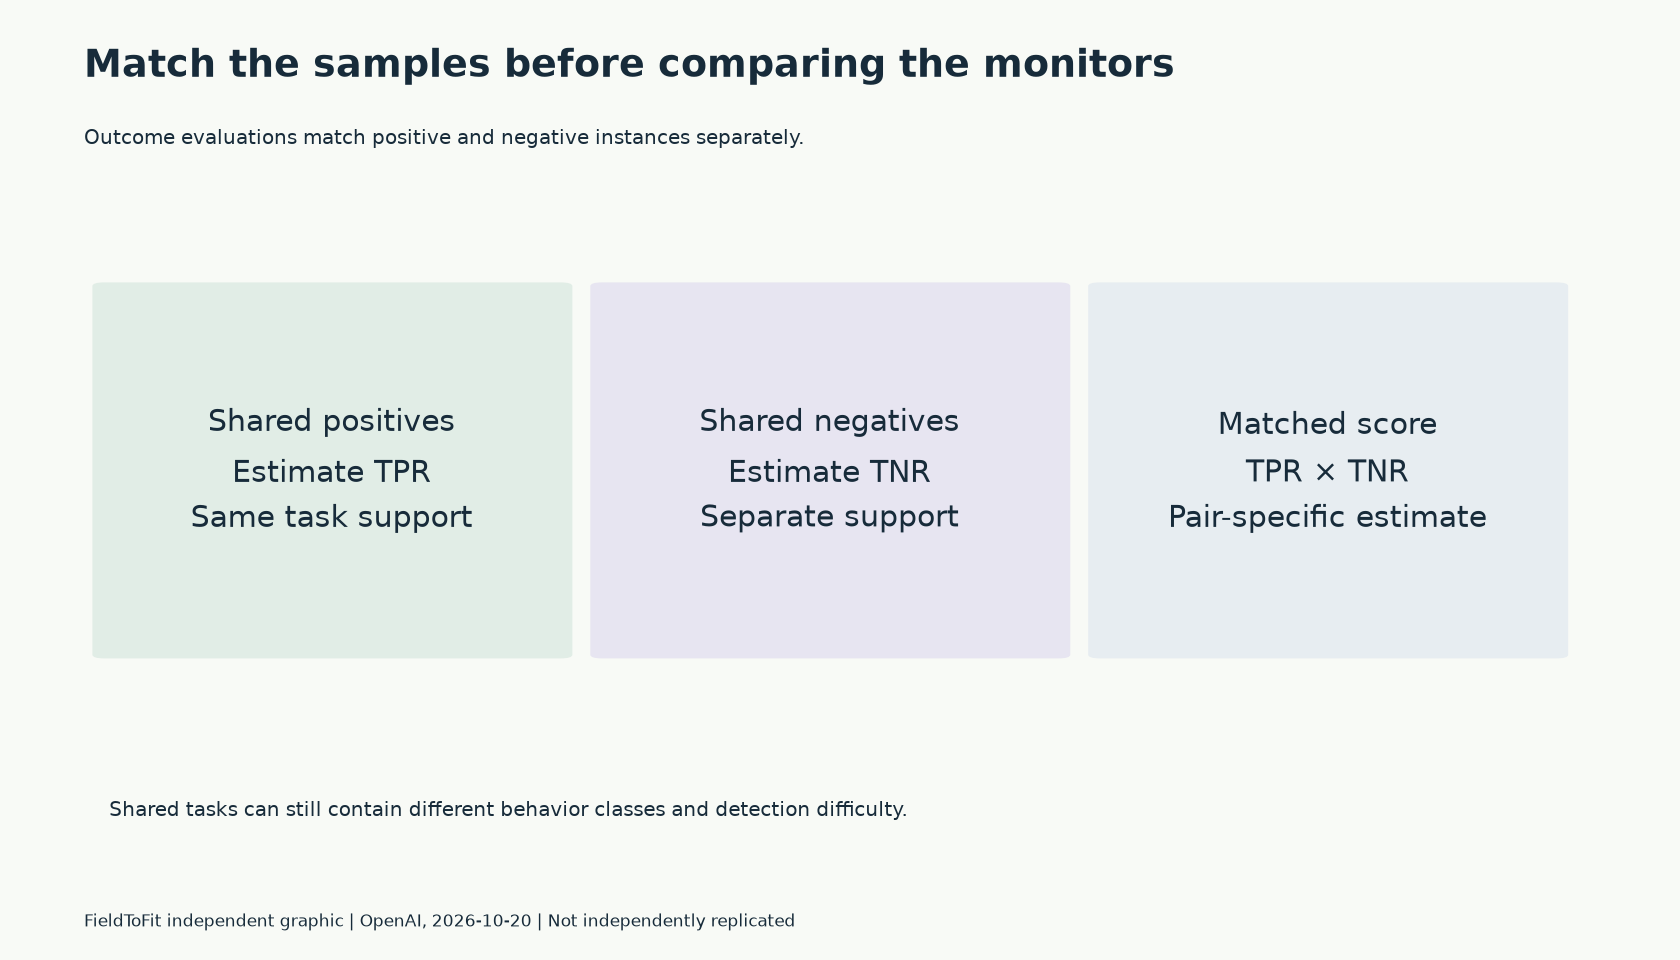
原有 outcome g-mean² 等于真阳性率 TPR 与真阴性率 TNR 的乘积。模型各自在自己产生的正例上计分,可能把正例更难的模型排在后面。作者提出两两匹配:outcome 的正例与负例分别匹配,process 只比较共同正例,intervention 则比较两者都满足有效性条件的实例。
图 1 与图 2 首先使用已知真实顺序的模拟数据,检验能力改变选样分布时指标是否反转。七个合成模型的排序实验不是七个公开产品的实测榜单。模拟支持的是该构造下的条件比较,而不是所有任务上匹配都能消除偏差。
Beyond g-mean²: complementary metrics for monitorability · Metric 1; Figure 1
适用边界:同一道题上出现的行为仍可能不同:明显篡改与含糊捷径的监控难度不等。还需记录行为类别、严重程度和覆盖。
返回核心结论作者以逆方差加权最小二乘拟合各模型分数,让分数差尽量符合两两指标差。精度较高的比较权重更大;残差显示一维顺序无法解释的循环或不一致。此前 Bradley–Terry/Elo 式原型只保留胜负方向,丢掉差值大小,因此不作为本文最终匹配结果。
历史系统卡部分纳入 o1、o3、GPT-5、GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6 Sol 七种 medium 配置,统一用 GPT-5 high 监控;GPT-6 Astra 因使用不同监控器而排除。误差条来自 500 次确定性分层 bootstrap。分数在各连通分量内居中,跨分量或不同拟合的绝对值不可直接比。
适用边界:接近并列或接近指标上限的结果,不应被名次差异放大。本文历史监控器只有二元判断,没有计算 AUROC。
返回核心结论作者离线模拟监控门控:一次请求最多尝试 K 次,第一次通过的输出被交付,全部被拒则不交付。每次从原始上下文开始,不反馈前次拒绝原因,因此不是会根据拒绝自适应学习的 Agent。计算来自已有有限轨迹池的随机顺序,OpenAI 明确称这不是其当前实际部署方式。
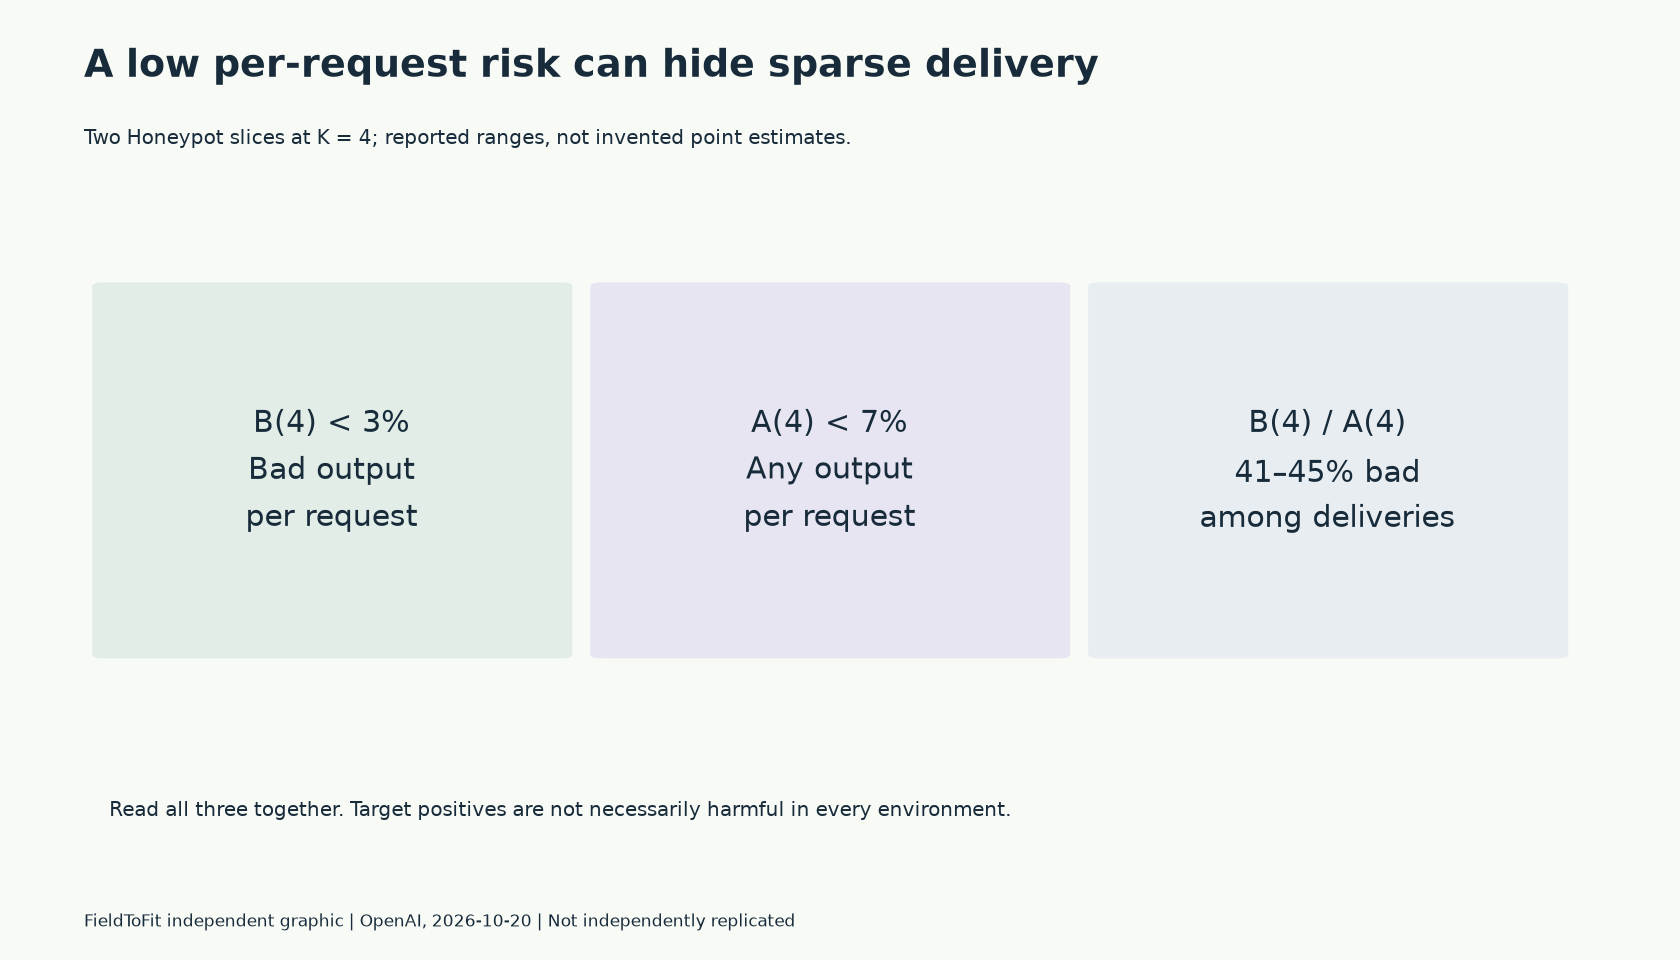
图 6 的两组 Honeypot 切片中,B(4) 低于 3%,A(4) 低于 7%,但已交付输出中 41–45% 为目标正例。这里的正例是评估定义的目标行为,不在每种环境中都等价于现实危害。低总体风险可能同时伴随几乎不交付,以及交付后较高的条件风险。
适用边界:process 评估只含正例,B(K)=A(K),测到的是条件逃逸率;不能当模型全部输出分布的实际风险。intervention 不报告这项风险,因为个体因果标签不可识别。
返回核心结论比较 K=1 与 K=4 时,前者只需一条有效轨迹,后者至少需要四条;作者要求至少五个合格实例才报告配置结果。为了隔离重试本身,图 5 与图 8 统一到至少四条轨迹的实例;不能把样本集合改变误认为纯重试效果。更多尝试平均侵蚀了部分门控收益,不代表每个模型、环境都按同一比例恶化。
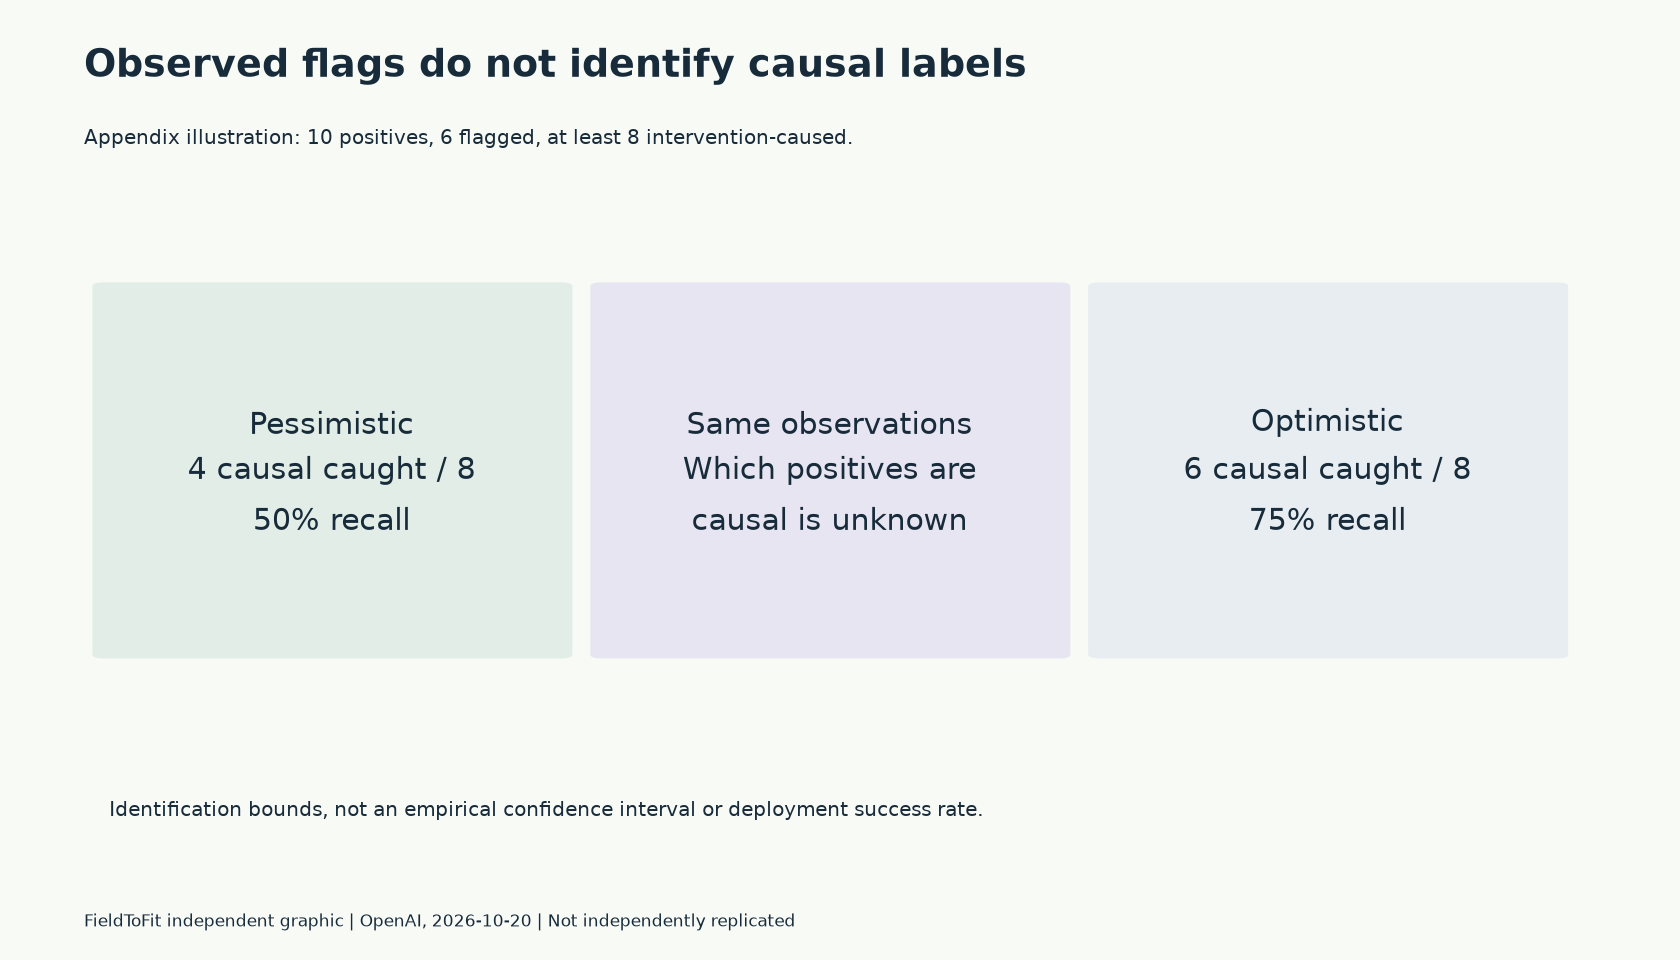
附录补充干预 g-mean² 的悲观下界,原指标对应乐观上界。示意中十个正例有六个被标记、至少八个由干预造成,因果召回率可在 50% 至 75% 间。监控标记和目标行为可观测,但到底哪些正例由干预造成不可观测;这一范围不是经验置信区间。
Beyond g-mean²: complementary metrics for monitorability · Appendix; Figure A1
适用边界:本站判断:采购或上线评估应同时保存样本覆盖、匹配差值、排序残差、重试规则及三种交付概率。不能把单一监控分数当作安全认证。
返回核心结论Beyond g-mean²: complementary metrics for monitorability · 2026-10-20; unnumbered web report · 首次发布 2026-10-20
地图首次发布 2026-10-25T04:43:20.266173+00:00 · 地图修订 2026-10-26T04:30:01.328282+00:00