MKA:多模态 Agent 怎样交付专业文件?

MKA:多模态 Agent 怎样交付专业文件?

把交付质量、每任务成本和直接看图能力分开测,才能看出同一套任务上不同模型的取舍。

正式任务集未公开,模型每题运行一次,自动判分单次。费用为论文按标价和缓存估算。本站未复现。

本次变化:首次发布。根据表 3–5 整理四条结论、对应论述及三张本站重绘。

方法、实验与证据

用成品评分,检验多份视觉材料能否转成可用交付

机制
200 项任务覆盖 10 个行业。评分按专家设定的交付要求加权。
条件/配置
同一 Stirrup v0.2.1 框架,配置及分母见对应论述。
报告结果
200 项任务覆盖 10 个行业。评分按专家设定的交付要求加权。
局限
正式任务集未公开,模型每题运行一次,自动判分单次。费用为论文按标价和缓存估算。本站未复现。

Google DeepMind · MKA technical paper · pp. 1–10 · Benchmark design and evaluation setup

质量点估计领先,差距仍有统计不确定性

机制
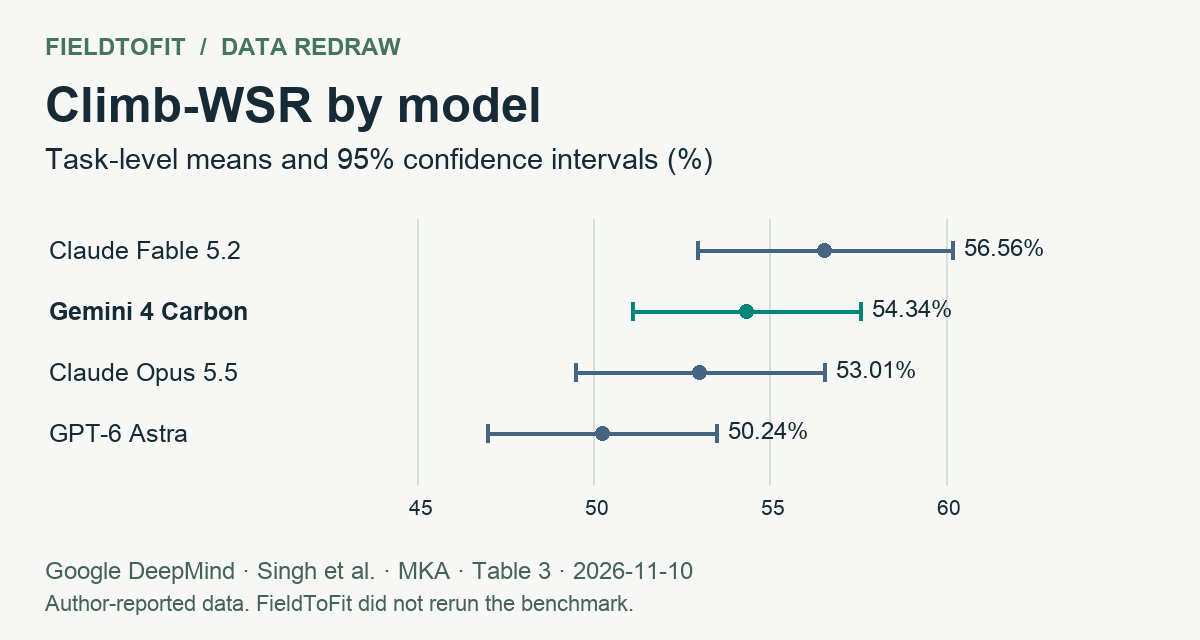
Fable 5.2 的难项得分为 56.56%,Carbon 为 54.34%。
条件/配置
同一 Stirrup v0.2.1 框架,配置及分母见对应论述。
报告结果
Fable 5.2 的难项得分为 56.56%,Carbon 为 54.34%。
局限
正式任务集未公开,模型每题运行一次,自动判分单次。费用为论文按标价和缓存估算。本站未复现。

Gemini 4 Carbon Climb-WSR:54.34 % · 比较基线 Claude Fable 5.2: 56.56% · 200 项任务的加权难项均值。

Google DeepMind · MKA technical paper · p. 11 · Table 3 and paired comparison

相近的难项得分对应不同的任务费用

机制
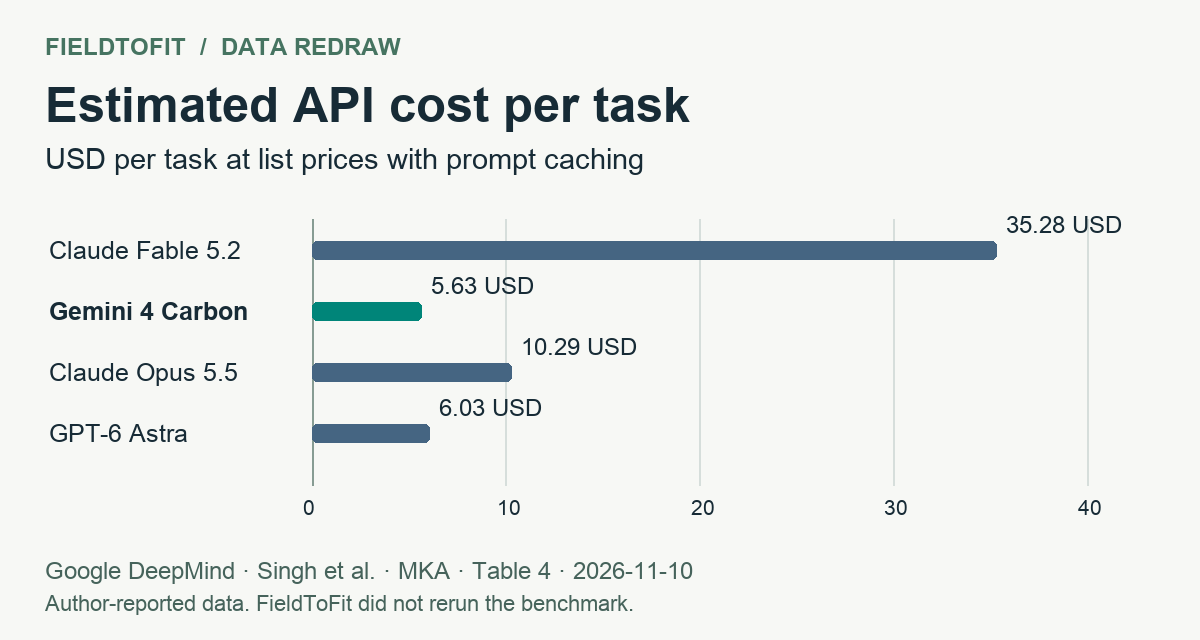
含提示缓存的标价估算中,Fable 5.2 为每任务 35.28 美元,Carbon 为 5.63 美元。
条件/配置
同一 Stirrup v0.2.1 框架,配置及分母见对应论述。
报告结果
含提示缓存的标价估算中,Fable 5.2 为每任务 35.28 美元,Carbon 为 5.63 美元。
局限
正式任务集未公开,模型每题运行一次,自动判分单次。费用为论文按标价和缓存估算。本站未复现。

Gemini 4 Carbon API cost:5.63 USD/task · 比较基线 Claude Fable 5.2: 35.28 USD/task · 按标价和提示缓存估算。

Google DeepMind · MKA technical paper · pp. 11–12 · Table 4 and efficiency comparison

移除直接看图能力后,MKA 难项降分且轮次增加

机制
Carbon 的 MKA 难项下降 5.94 个百分点,轮次增至 1.28 倍。
条件/配置
同一 Stirrup v0.2.1 框架,配置及分母见对应论述。
报告结果
Carbon 的 MKA 难项下降 5.94 个百分点,轮次增至 1.28 倍。
局限
正式任务集未公开,模型每题运行一次,自动判分单次。费用为论文按标价和缓存估算。本站未复现。

Gemini 4 Carbon without view_image:-5.94 percentage points · 比较基线 Gemini 4 Carbon with view_image · MKA 难项得分的消融差。

Google DeepMind · MKA technical paper · pp. 13–14 · Section 4.3 and Table 5

关系与依据

MKA:多模态 Agent 怎样交付专业文件?

  1. 用成品评分,检验多份视觉材料能否转成可用交付

    200 项任务覆盖 10 个行业。评分按专家设定的交付要求加权。

  2. 质量点估计领先,差距仍有统计不确定性

    Fable 5.2 的难项得分为 56.56%,Carbon 为 54.34%。

  3. 相近的难项得分对应不同的任务费用

    含提示缓存的标价估算中,Fable 5.2 为每任务 35.28 美元,Carbon 为 5.63 美元。

  4. 移除直接看图能力后,MKA 难项降分且轮次增加

    Carbon 的 MKA 难项下降 5.94 个百分点,轮次增至 1.28 倍。
1. 用成品评分,检验多份视觉材料能否转成可用交付

任务要求在 CAD 图纸、地图或图表等多份材料中提取证据,并提交可独立使用的文件。四款模型使用同一 Stirrup v0.2.1 运行框架,每题最多 250 轮。正式集 200 题,另有 10 个公开展示任务。

总体 WSR 是交付要求的加权满足比例。Climb-WSR 聚焦旧模型尚未饱和的难项。自动评分器在作者抽样研究中的逐条判断与领域专家一致率为 96.2%。

Google DeepMind · MKA technical paper · pp. 1–10 · Benchmark design and evaluation setup

返回核心结论

2. 质量点估计领先,差距仍有统计不确定性

论文报告的任务均值和 95% 置信区间见表 3。Fable 5.2 对 Carbon 的配对难项差为 2.22 个百分点,95% 置信区间为 −0.94 至 +5.49 个百分点,覆盖零。

四款模型的难项得分及置信区间,本站重绘。
本站重绘:表 3 的 Climb-WSR 任务均值及 95% 置信区间。 · 本站重绘。原始数据:Google DeepMind,Singh 等。 · Graphics © FieldToFit. Independent redraw of author-reported facts; original report graphics are not reproduced.

Google DeepMind · MKA technical paper · p. 11 · Table 3

Google DeepMind · MKA technical paper · p. 11 · Table 3 and paired comparison

返回核心结论

3. 相近的难项得分对应不同的任务费用

表 4 按各供应商标价和提示缓存读写计算。Fable 5.2 和 Carbon 平均用量分别为 40.48M 与 7.05M token,平均轮数分别为 128.8 和 46.6。成本依赖任务、计费和缓存条件。

四款模型每任务估算 API 费用,本站重绘。
本站重绘:表 4 的每任务平均 API 费用,单位美元,含提示缓存。 · 本站重绘。原始数据:Google DeepMind,Singh 等。 · Graphics © FieldToFit. Independent redraw of author-reported facts; original report graphics are not reproduced.

Google DeepMind · MKA technical paper · p. 11 · Table 4

Google DeepMind · MKA technical paper · pp. 11–12 · Table 4 and efficiency comparison

返回核心结论

4. 移除直接看图能力后,MKA 难项降分且轮次增加

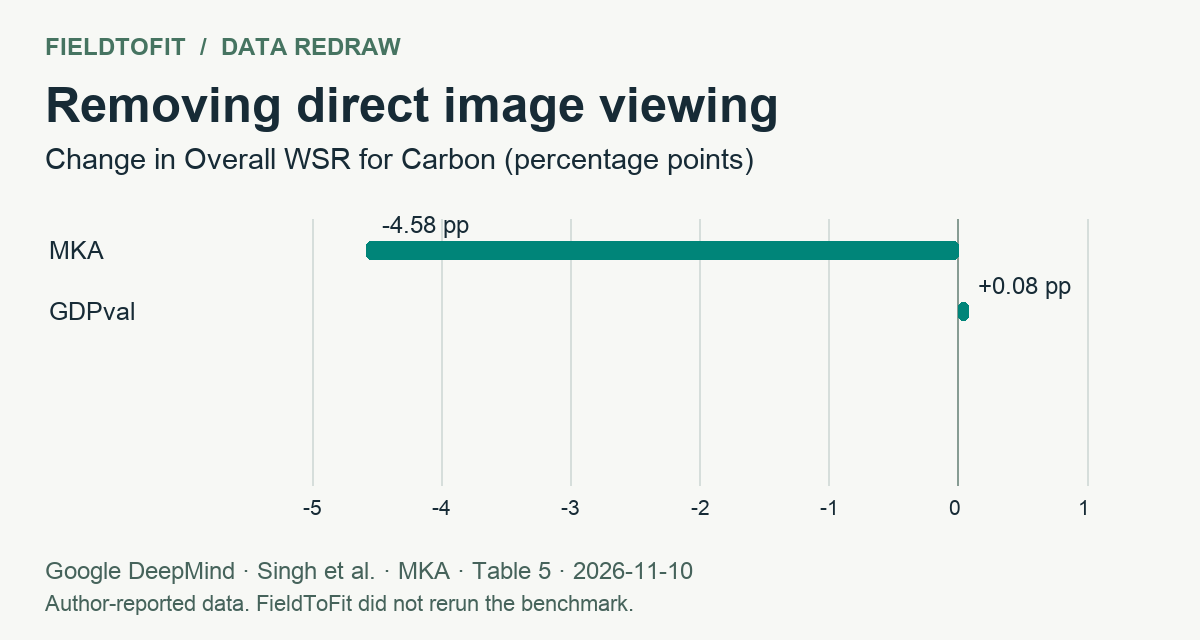
仅 Carbon 参与消融。移除 view_image 后,MKA 总体 WSR 下降 4.58 个百分点,GDPval 总体 WSR 变化 +0.08 个百分点且不显著。两个总体指标可并列阅读,难项变化应单独看。

移除直接看图后两套任务总体分的变化,本站重绘。
本站重绘:表 5 的 Overall WSR 变化,单位为百分点。 · 本站重绘。原始数据:Google DeepMind,Singh 等。 · Graphics © FieldToFit. Independent redraw of author-reported facts; original report graphics are not reproduced.

Google DeepMind · MKA technical paper · p. 13 · Table 5

Google DeepMind · MKA technical paper · pp. 13–14 · Section 4.3 and Table 5

返回核心结论

报告与日期

Google DeepMind · MKA technical paper · 2026-11-10 · 首次发布 2026-11-10

地图首次发布 2026-11-11T08:47:59.810071+00:00 · 地图修订 2026-11-11T08:47:59.810071+00:00