计算、环境、评分共同扩展
- 机制
- 在同一混合任务训练中扩大批量与吞吐,增加任务/harness 多样性,并投入更多评分计算。
- 条件/配置
- Pro 与 Flash;GRPO,异步 partial rollout;每批 1,568 个 prompt,各 16 条轨迹,约 25K 轨迹。
- 报告结果
- DeepSWE v1.1 训练曲线 avg@3:Pro 58.4 → 72.6;Flash 48.7 → 65.7。
- 局限
- 训练曲线是合成系统的结果,不能单独归因给某一组件;不与最终检查点表混合。
混合任务 RL:计算/环境/评分共同扩展 → 稳定路由与细粒度奖励 → MOPD2 能力融合。连线表示报告中明确纳入的训练步骤,非单项因果收益。
长任务 Agent 的提升来自训练系统的联合设计:更丰富的可验证经验、更细的解法评价、稳定的 MoE 执行,以及在学生生成上进行多教师监督。
作者实验未复现;训练曲线与最终成绩分开,RL 费用不等于完整成本或 API 报价;方法示意无性能比例。
本次变化:首次深读 2026-10-08 MiMo-V2.6 v1:四条结论及同号论述、四张原创重绘/示意,保留评分、路由、蒸馏和实验边界。
方法继承/纳入:混合任务 RL 纳入更细的组内评分;评分扩展是训练路线的一部分
§4.1; §4.3方法继承/纳入:大规模 RL 使用冻结路由器保持专家负载
§5.1; §5.4并行探索:评分质量与专家负载是并行工程问题,不是相互带来性能增益的证据
§4.3; §5.4方法继承/纳入:混合 RL 后接多前缀、多教师蒸馏
§5.6; Figure 13更长、更大的训练批次只是其中一环。任务与 harness 多样性、验证质量、评分预算和异步调度共同决定模型能学到什么。
GRS 与 GAR 分别用离线标准、在线比较区分解法质量;行为惩罚则另行约束冗长与无效动作。三者不能混写成一个万能评分器。
路由漂移会让专家越来越不均衡。冻结路由器在作者对照中保持负载稳定,但微批次尖峰、内存和调度仍可能中断训练。
学生继续生成,教师在同一历史与学生前序 token 上给监督;教师轨迹或 SFT 数据提供历史前缀,帮助处理难验证领域与长轨迹偏移。
MiMo-V2.6 是一组多模态 MoE 模型。报告写 Pro 总参数 1.02T、激活 42B,Flash 总参数 310B、激活 15B;Flash 模型卡此前使用 309B,本篇保留报告口径,未推造两者差异的原因。模型先经历预训练与 agent-centric 中期训练,再进入混合任务 RL 和后续蒸馏。
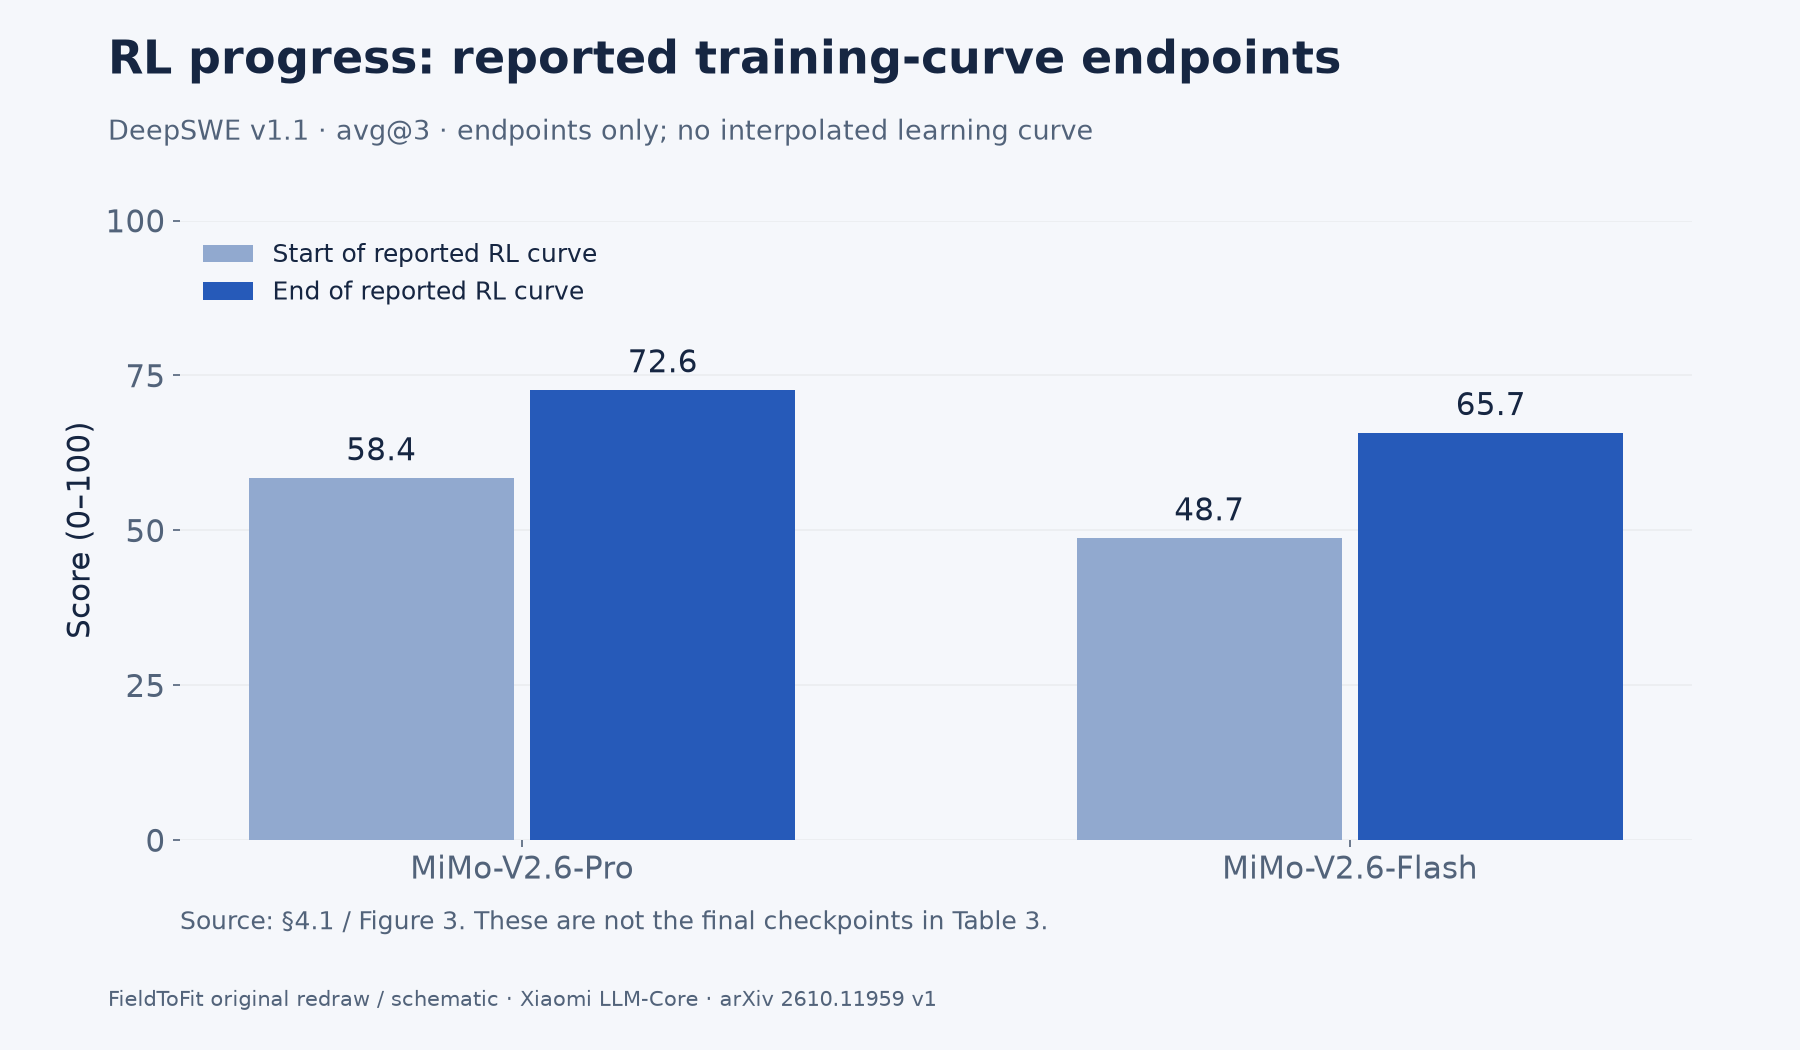
适用边界:作者报告 Pro/Flash 的 RL 后训练费用为 $2.6M/$0.9M;这不包含完整预训练成本,也不是 API 售价。图 1是训练过程的 avg@3;表 3的最终模型 DeepSWE 分数为 71.9/67.9,必须保留各自阶段与评测口径。
关联已审动态 D-26 · MiMo-V2.6 模型与训练路线 · 本站已有事件;保留原事件日期
关联已审动态 D-109 · MiMo-V2.6 MOPD 检查点 · 本站检查点补录;与本篇技术深读区分
返回核心结论二值测试擅长判断任务是否通过,却可能把合理修复、过度改动与碰巧过关的实现赋予相同奖励。报告的重点是让评分器查看代码、运行证据与行为轨迹,再为组内的质量差异提供可训练信号。
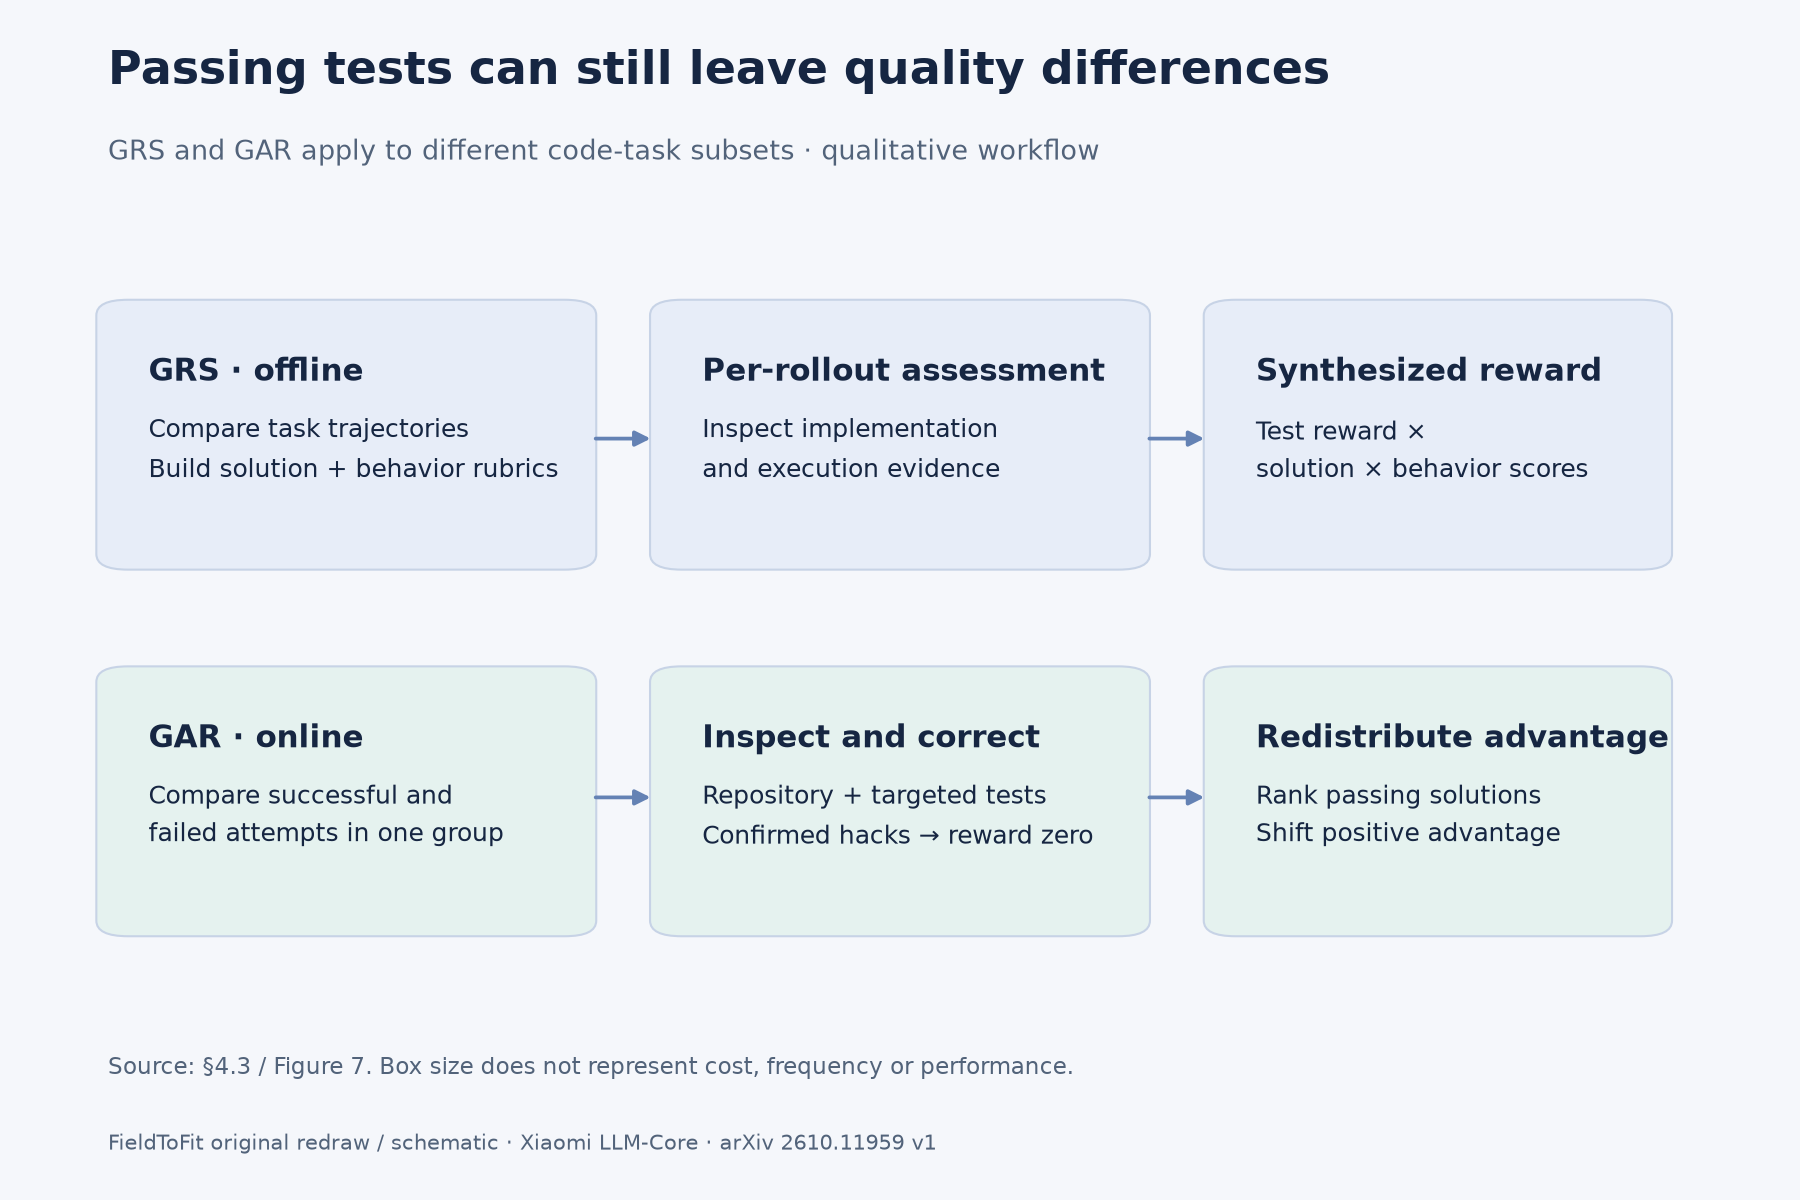
关键证据:原图 8的 GAR 对照是 Flash、代码任务、batch 128;作者报告通过率与 token/轮数表现更优。本篇不从未标注图形反推精确增益,不把这个局部对照扩成整个模型家族的因果证明。
奖励质量也依赖环境是否可信。报告同时描述环境准备、对抗检查和训练中审计;“检测到的 reward hacking 较少”只描述检测结果,不能证明不存在未检出的作弊。
返回核心结论在 Pro 第 9层的 384 个专家上,作者比较路由器可训练与冻结的两次 RL 运行。可训练路由器在前 20 步出现负载塌缩;作者只恢复路由参数、保留其他权重时,负载接近初始水平,benchmark 表现未变。这支持路由漂移是该次塌缩原因的判断。
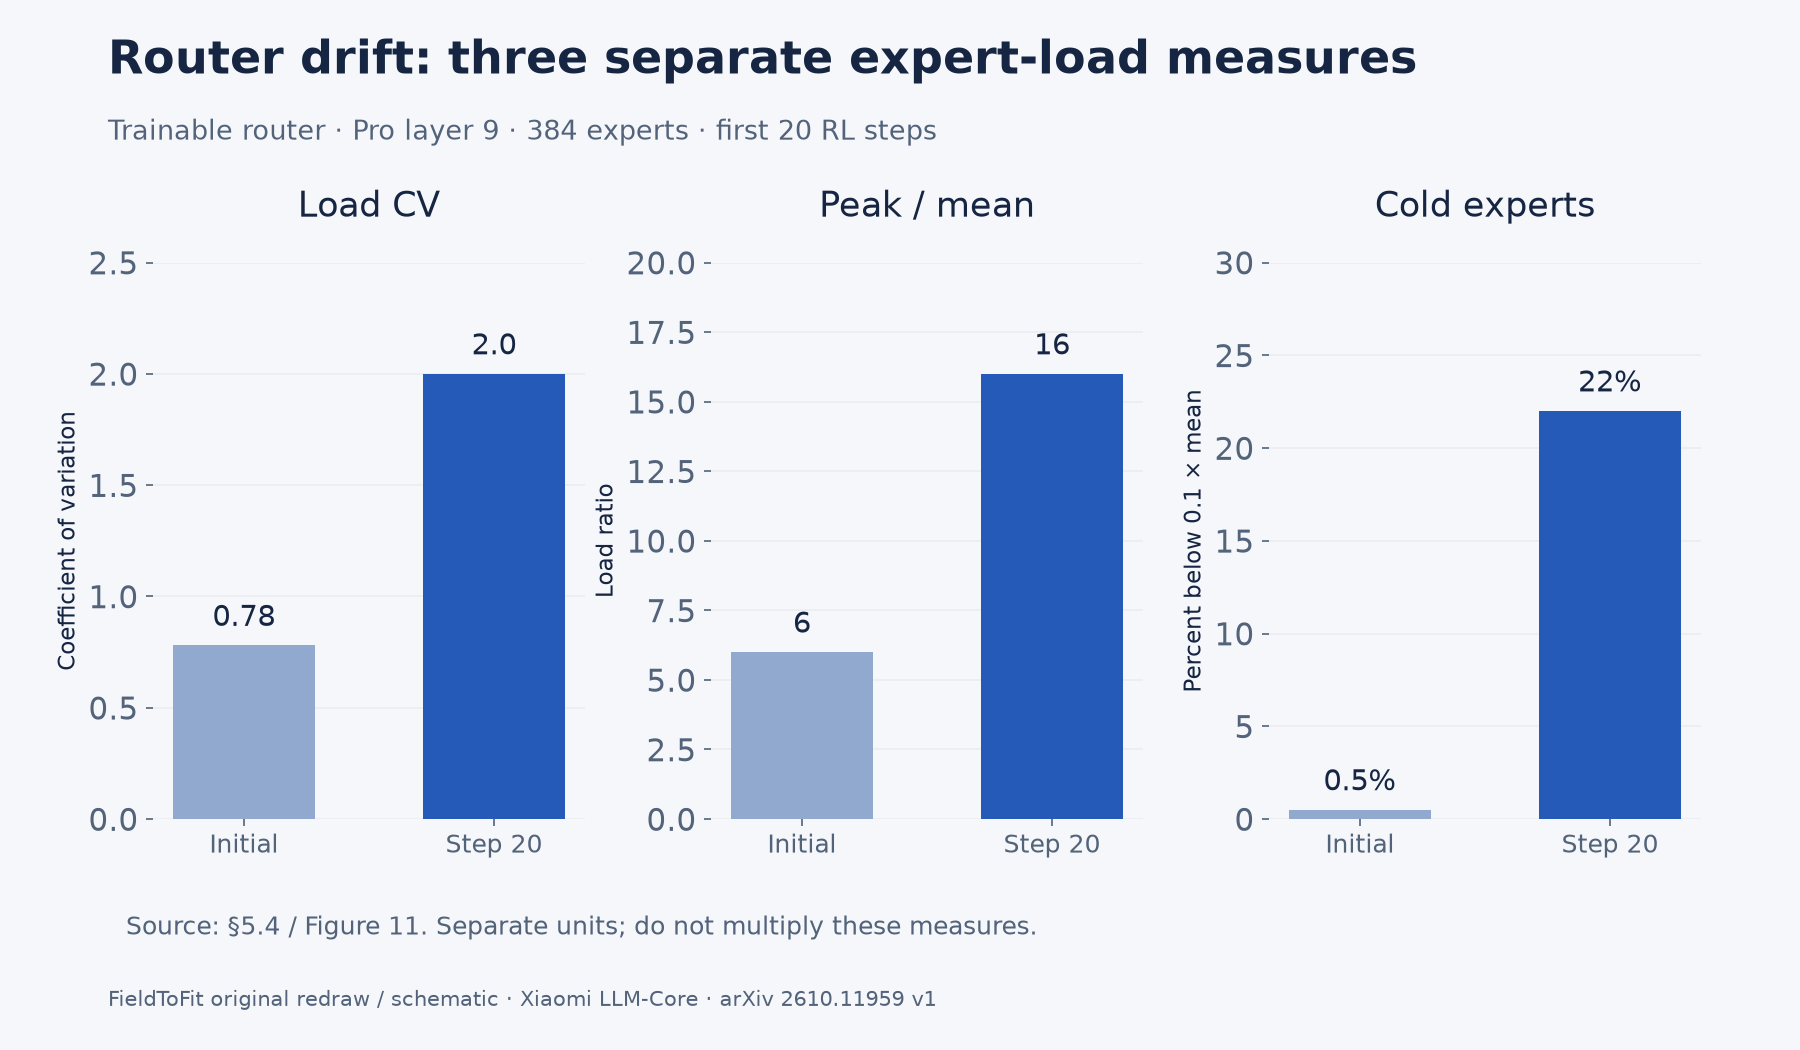
适用边界:冻结路由器是报告中的稳定化手段;它不是显存问题、异步采样或基础设施可靠性的总解决方案。
返回核心结论mixed RL 擅长利用可以可靠验证的任务,但长程游戏开发、科研或具身场景未必容易设计奖励。MOPD2 接在 mixed RL 之后,按领域使用不同教师,把可验证和难验证领域的能力融合;其中 SFT 教师来自高质量合成示范。
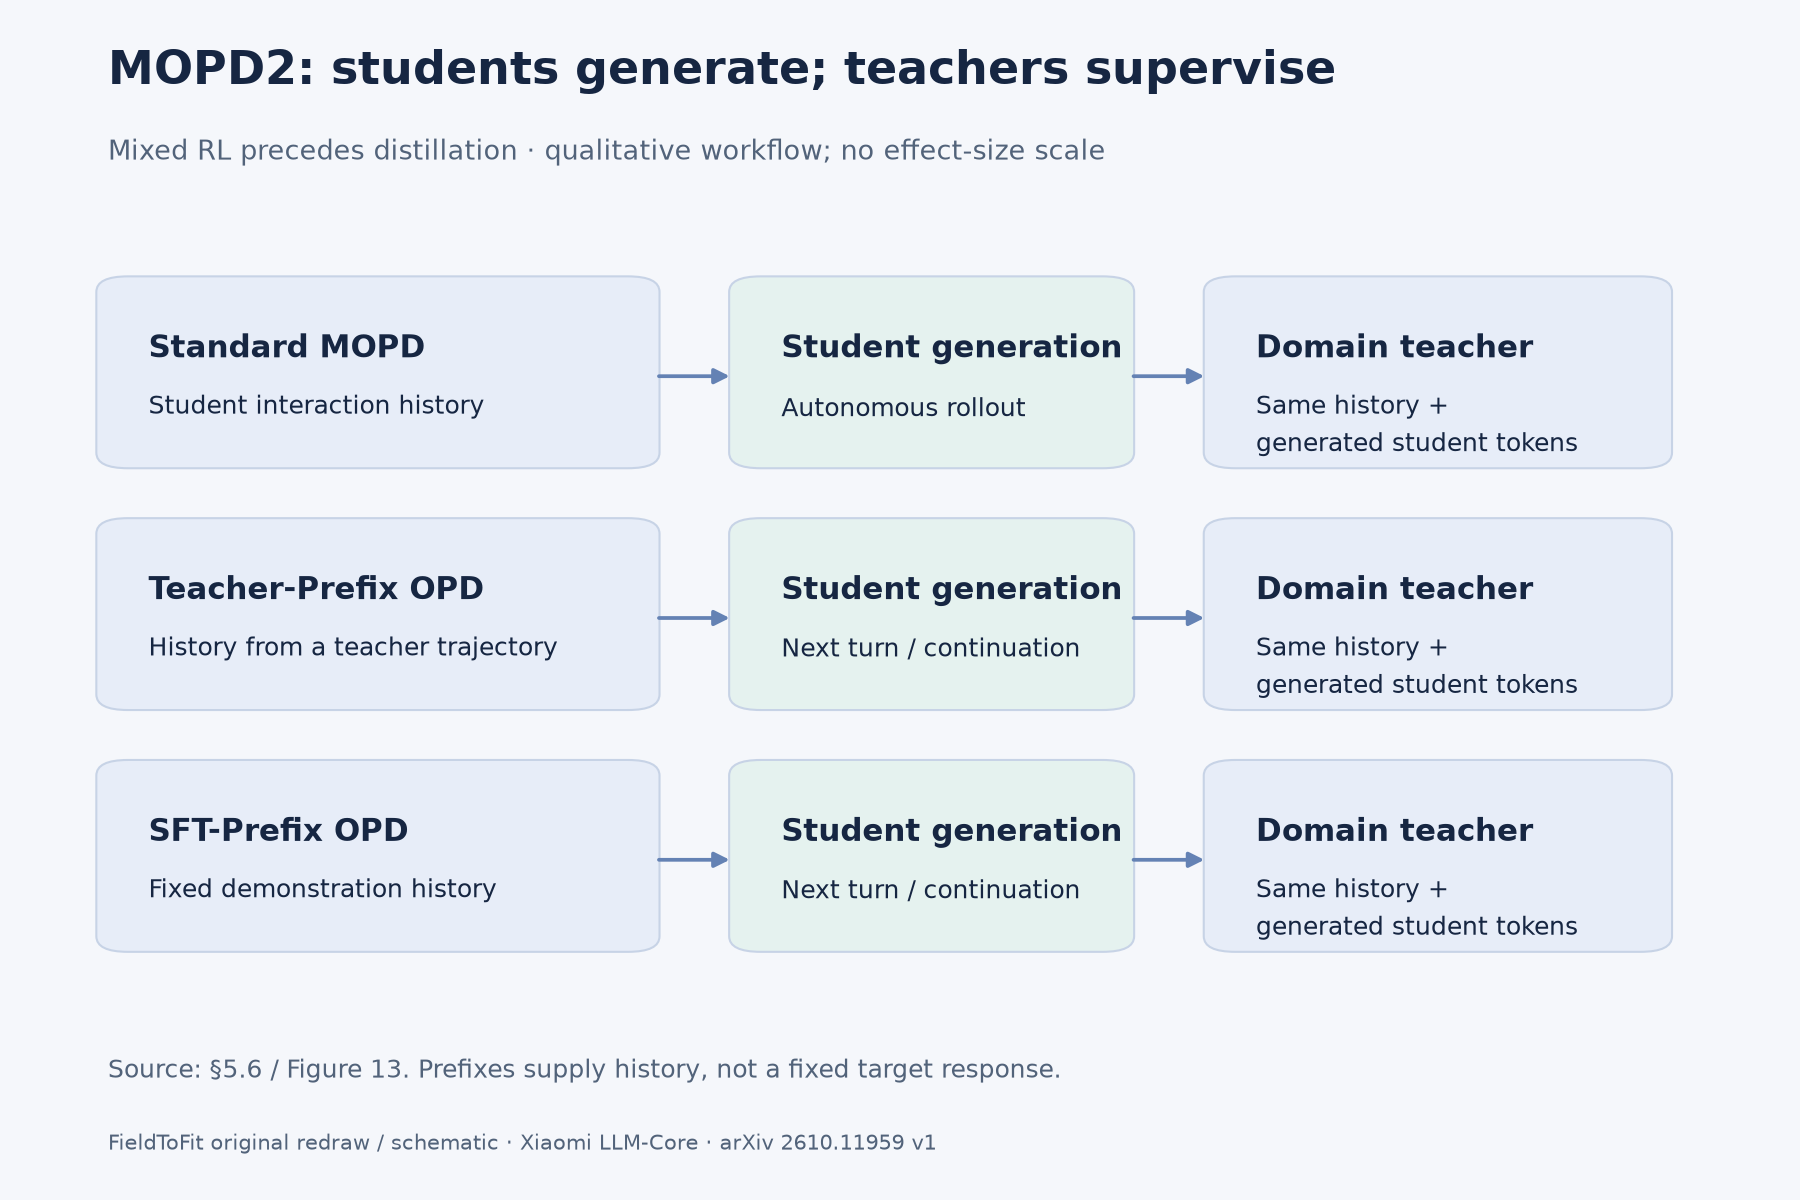
适用边界:表 3是最终模型跨 benchmark 的成绩,包含不同评测设置和部分内部任务;不能独立归因给 MOPD2。§7 的 9B 开源实验还区分各领域的单独 RL 与多 harness 代码实验,不能据此宣称一个 9B 检查点同时覆盖所有能力。
这条路线把“自我改进”具体化为受环境、评分与教师监督约束的训练迭代。报告展示持续扩展 RL 的潜力与可研究的工程栈,没有证明模型已经获得无需人类目标、算力预算或验证器的无限递归改进。
返回核心结论MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement · Xiaomi LLM-Core · arXiv 2610.11959 v1 · arXiv 2610.11959 v1 · 首次发布 2026-10-08 · 固定读取 v1;未核实后续实质修订。本站写作日期不作为报告修订日期。
地图首次发布 2026-10-12T03:52:48.197322+00:00 · 地图修订 2026-10-12T03:52:48.197322+00:00