底座规模与训练配置
- 机制
- 稀疏MoE底座,原生视觉预训练。
- 条件/配置
- 2.8T总参数、80B激活、50T训练token;16k GB200、38 天。
- 报告结果
- 预训练已完成,仍在后训练。
- 局限
- 不是已核实的公开权重或通用API交付。
Frontier Pre-training at Microsoft AI · official PDF · pp1–3; How MAI-Base-2 Compares
数据曝光、等质量计算量和万卡系统如何共同决定预训练结果
配方效率要连同可比较的实验条件和真实系统代价判断;少用FLOPs的能力,不自动等于最终训练账单更低。
作者结果未复现;部分基准私有、部分对照已后训练;模型仍在后训练。原文图表仅链接,本站图形为事实示意而非实验曲线。
本次变化:首次整理所选MAI-Base-2 技术文,提供四结论、同号论述、三张原创事实图,并区分BPB拟合效率、实际训练计算、MFU和goodput。
Frontier Pre-training at Microsoft AI · official PDF · pp1–3; How MAI-Base-2 Compares
Frontier Pre-training at Microsoft AI · official PDF · pp3–4; Robust scaling ladders; Figure 2
Matched-BPB pre-training FLOPs efficiency lower bound:4.2 ratio · 比较基线 DeepSeek-V4-Pro-Base reported training FLOPs · Four independently fitted held-out tasks; range 4.2–12.3; known final endpoint included; not actual total cost
Frontier Pre-training at Microsoft AI · official PDF · pp7–9; Scaling MoE; Figure 6
Frontier Pre-training at Microsoft AI · official PDF · pp11–12; Scaling Data; Figure 10
Frontier Pre-training at Microsoft AI · official PDF · pp1–3; What’s next pp12–13
并行探索:并行核对训练证据
pp3–4; Robust scaling ladders; Figure 2并行探索:并行核对训练证据
pp5–7; Scaling laws for hyperparameters; Figure 4并行探索:并行核对训练证据
pp4–5; Isolating modeling efficiency from compute; Figure 3并行探索:并行核对训练证据
pp7–9; Scaling MoE; Figure 6并行探索:并行核对训练证据
p2; pp9–11; Scaling Muon and Activation gradient clipping并行探索:并行核对训练证据
pp11–12; Scaling Data; Figure 10并行探索:并行核对训练证据
pp1–3; What’s next pp12–13预测大训练前,先让小实验的数据曝光与正则化条件可比较。
先固定质量目标,再问训练配方需要多少计算。
计算上更稀疏的选择,也可能输给通信、碎片和尾部等待。
语料规模、基准结论和未来产品入口不能互相替代。
把小模型训练得更久,并不一定模拟了大模型的处境。若小实验每次看到新数据,而最终训练要重复同一来源,小实验可能偏爱到了大规模才过拟合的配置。source scaling主动缩小小实验的独特样本池,同时保持各来源重复次数及TPP;它控制的是实验条件,不只是数据总量。
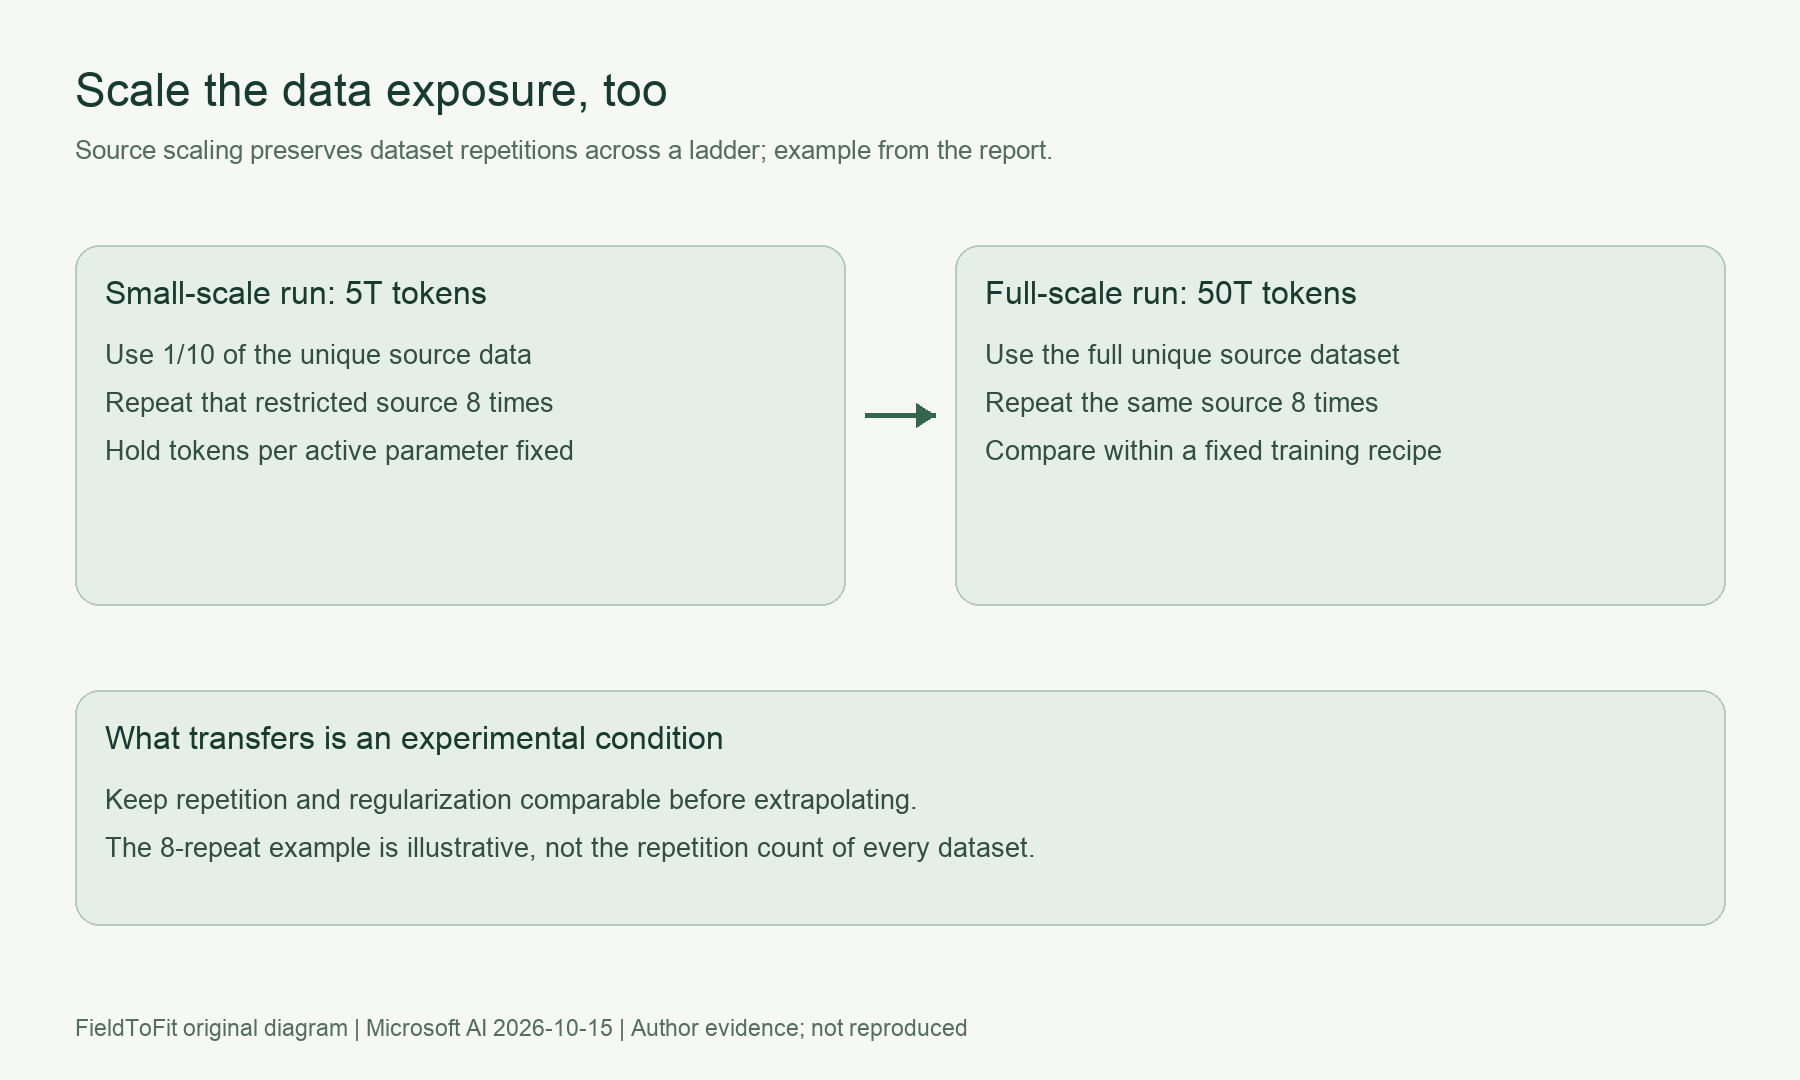
Frontier Pre-training at Microsoft AI · official PDF · p4; Figure 2 and source scaling example
适用边界:示例中的重复次数与经验超参数关系都有条件,不能当作通用训练默认值。
Frontier Pre-training at Microsoft AI · official PDF · pp3–7; Figures 2 and 4
返回核心结论作者没有用最终两台不同大小模型的总训练计算直接宣布节省,而是在代码、问答、STEM和数学四项保留集上分别拟合BPB与训练FLOPs。以DeepSeek-V4-Pro-Base的BPB为目标,估计微软阶梯达到相同质量需要多少FLOPs,再与基线训练计算比较。BPB按字节度量,有助于跨tokenizer比较,但仍是指定文本保留集指标。
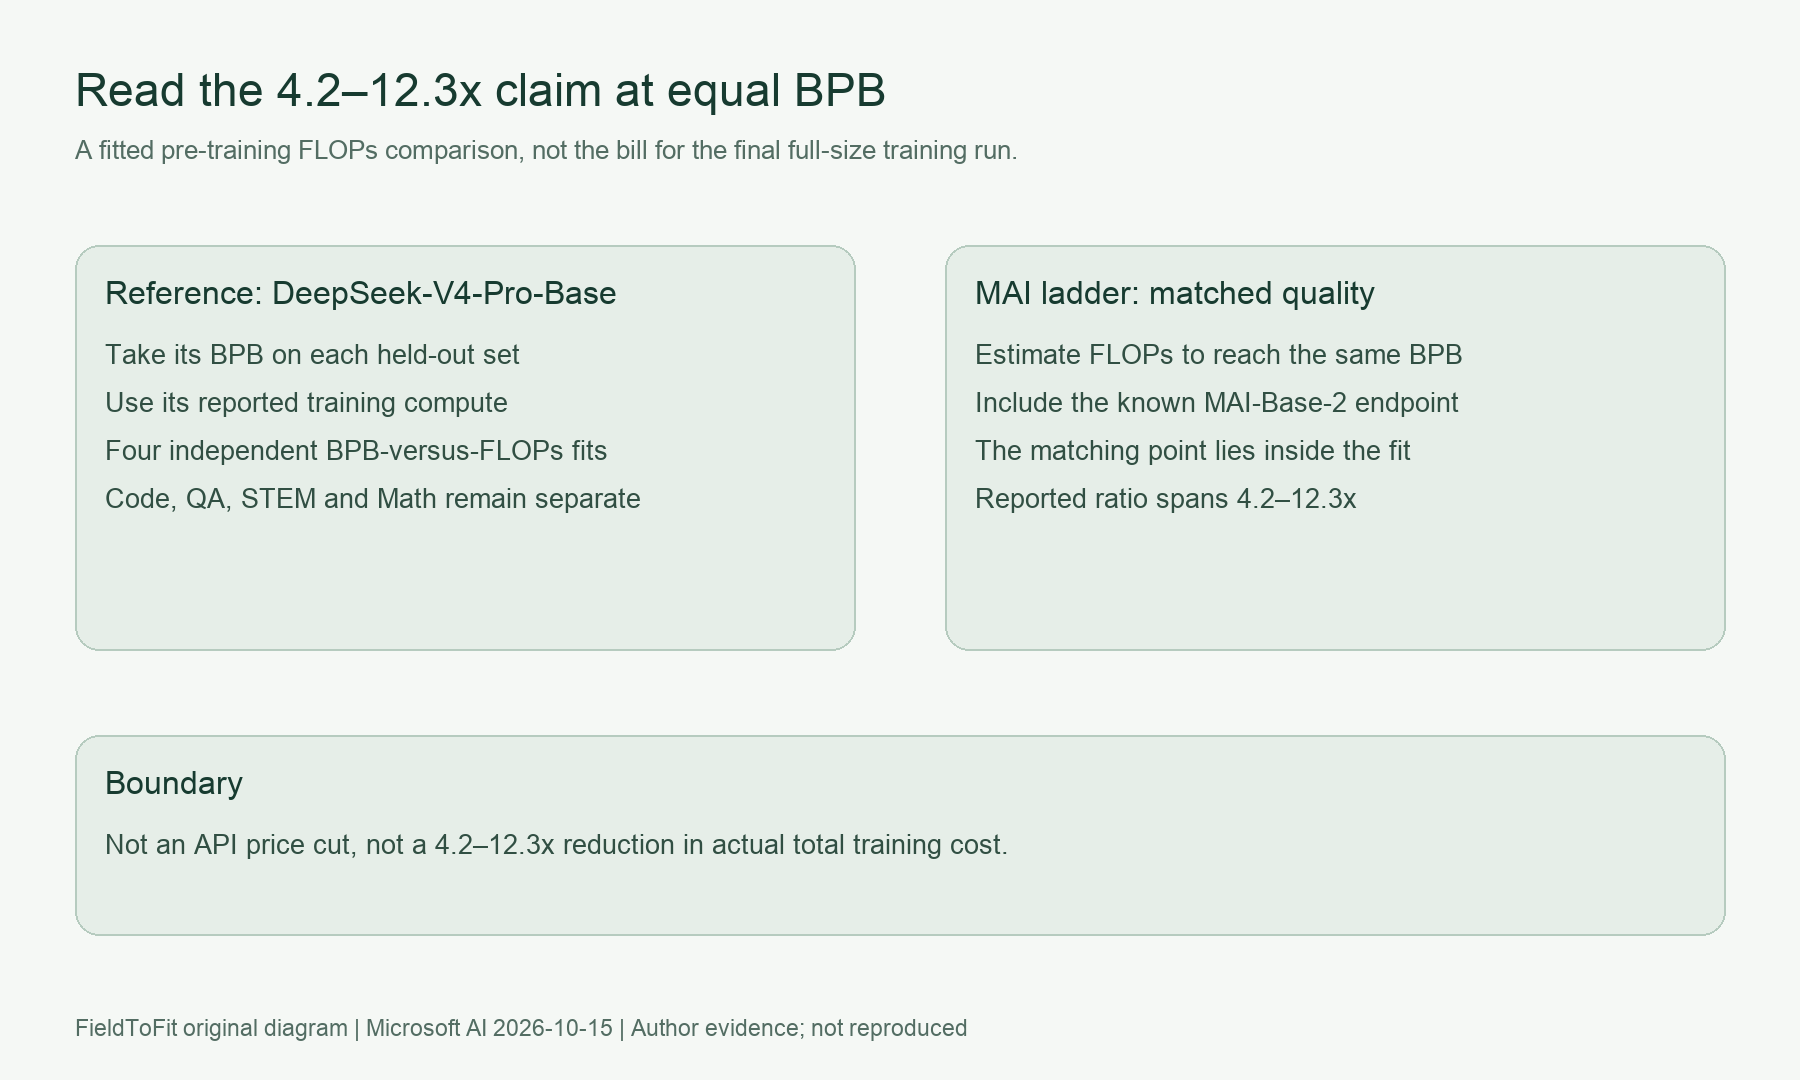
Frontier Pre-training at Microsoft AI · official PDF · pp4–5; Figure 3
关键证据:这里的可审结论是“同一保留集质量目标下的估计训练计算更少”,不是最终模型总成本更低。
返回核心结论微软称全层MoE此前在FLOPs上占优,却因实现开销在实际时间上不如隔层布局。新版把专家分组,为每个专家设固定token容量,用额外轮次处理溢出,并允许同组使用空闲容量;少分配内存可能意味着更多轮次,不是消除代价。通信与计算重叠、设备端元数据和批量归约减少了每专家开销。
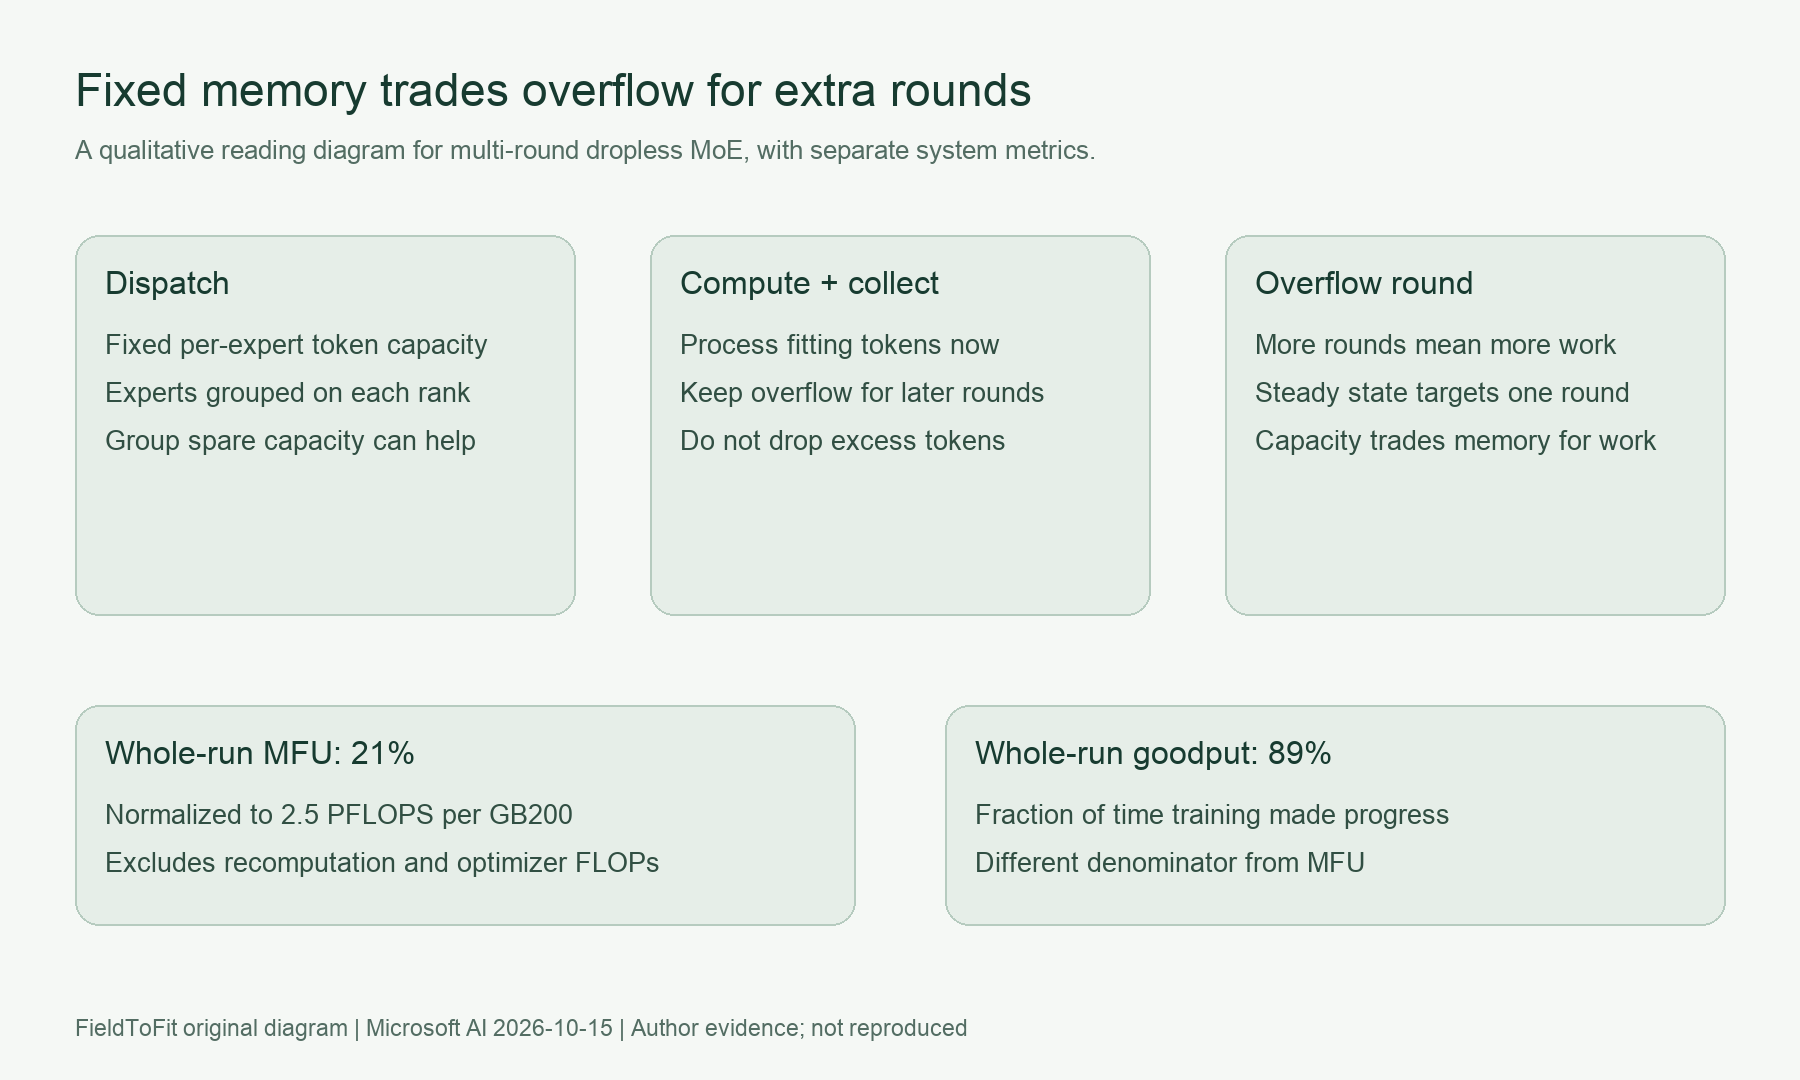
Frontier Pre-training at Microsoft AI · official PDF · p2; pp8–10; Figure 6
Frontier Pre-training at Microsoft AI · official PDF · pp7–11; Figures 5–9
返回核心结论MAI-Base-2 以无编码器VLM方式原生预训练视觉。作者称独特训练token比上代约增 36%,视觉语料含 4.5T独特token,重复后视觉数据占 50T混合的 18%。独特样本量、重复曝光量和混合占比分母不同,本文保留各自单位,不反推未公布的数据明细。
适用边界:FieldToFit判断:这是一份有方法和工程细节的训练报告;可帮助判断实验设计,尚不能替代独立复现、应用评测或取得模型的实际条件。
返回核心结论Frontier Pre-training at Microsoft AI · official PDF · Lab Notes 2026-10-15; unnumbered · 首次发布 2026-10-15 · 网页明确日期,PDF入口参数不冒充编号修订;本站首次整理不是上游修订。
地图首次发布 2026-10-17T03:17:49.268525+00:00 · 地图修订 2026-10-17T03:17:49.268525+00:00