两种任务,两种通过口径
- 机制
- 一项从零构建兼容数据库,另一项迁移已有 COBOL 程序。
- 条件/配置
- MultiLangBench 覆盖 20 种语言;迁移目标为 C++、Java、Kotlin、Python、Rust。
- 报告结果
- 分别比较测试通过率和全部测试通过的迁移成功率。
- 局限
- 不可合并成一个生产可靠性分数。
构建新功能 → 保持旧行为 → 核算成本与测试边界
先区分两种通过口径,再按自己的语言、业务规则和验证成本选择迁移路线。
模型作者报告的实验,非本站复现或生产可靠性承诺。研究网页与公开 README 已读,测试子集、重复次数和完整成本配置尚未核齐。
本次变化:首次整理 2026-10-19 官方研究网页:四结论、同号展开及三张独立重绘,保留方法、指标单位、推理条件和证据缺口。
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 1: Building SQLite from scratch
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 1: per-language results
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 2: Migrating a COBOL codebase
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Sections 1 and 2: estimated API cost
OpenAI MultiLangBench 官方开源仓库 · README: Test Suite / Usage / Grading
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 1: release of evaluation setup and test suite
并行探索:同一研究的独立证据层
Section 1: Building SQLite from scratch并行探索:同一研究的独立证据层
Section 1: per-language results并行探索:同一研究的独立证据层
Section 2: Migrating a COBOL codebase并行探索:同一研究的独立证据层
Sections 1 and 2: estimated API cost并行探索:同一研究的独立证据层
README: Test Suite / Usage / GradingSection 1: release of evaluation setup and test suite最大推理强度下,20 种语言平均测试通过率升至 87.4%,COBOL 仍落后于其他所列语言。
隐藏测试要求可观察输出逐字节一致,全部通过才算成功;低强度 86.6%与更高强度 97.9%分别表达。
数据库以美元/样本计,迁移以旧模型成本为 100 比较;它们都不是 API 价目表。
仓库默认 272 项与约 24k 转换测试须区分,论文各结果具体子集尚未确认;本站未复现。
OpenAI 把初始数据库和 SQL 作为共同接口,让模型用指定语言从零构建 SQLite 兼容引擎,再由参考实现检查修改后的数据库内容。这要求模型维护状态、处理错误并增补功能;测量的是长编码会话中构建了多少可通过测试的功能。
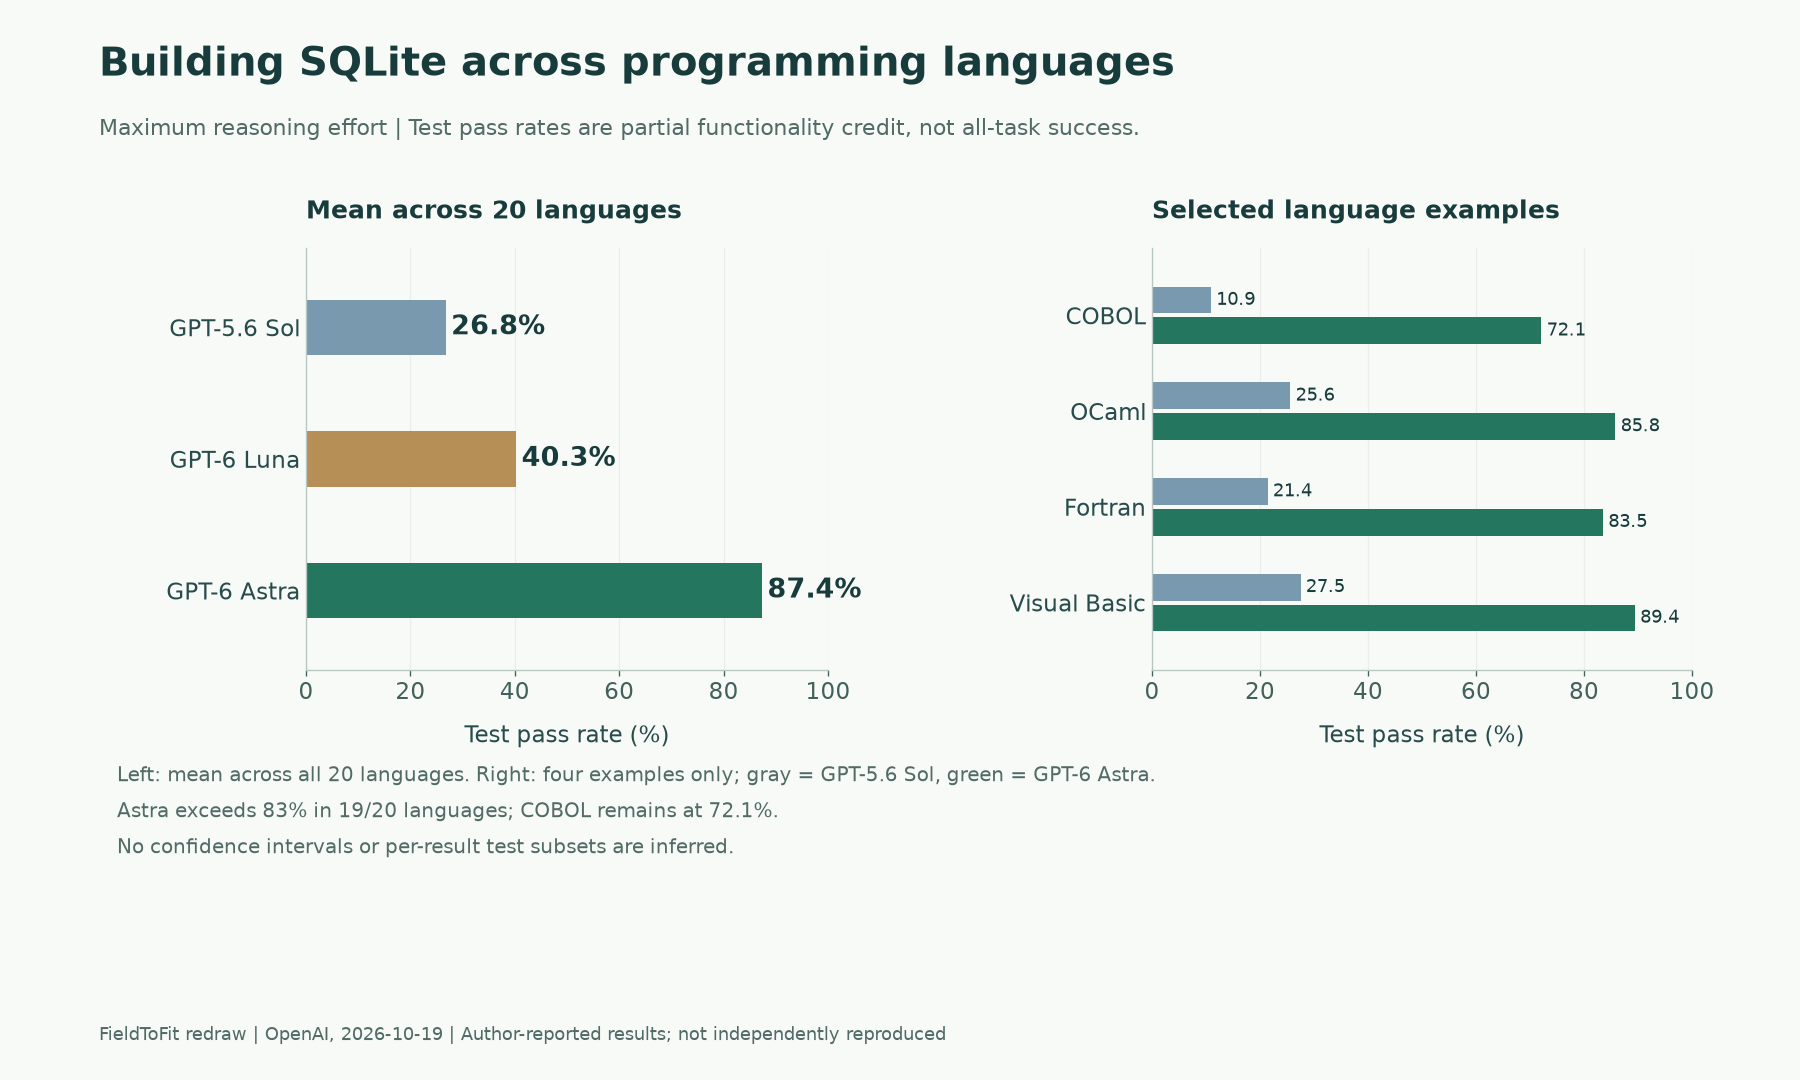
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 1: mean and per-language test pass rates
适用边界:证据边界:结果由模型作者报告,本站未独立重跑;正文未给出逐语言误差区间,不能把小差异解释成已证实的统计优势。
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 1
返回核心结论第二项任务将 COBOL 程序迁移到 C++、Java、Kotlin、Python 或 Rust。作者强调语言语义可能承载既有业务规则:例如未明确请求舍入时,COBOL 定点算术会丢弃多余小数位;迁移后改为舍入,即使程序能跑,也可能改变结果。
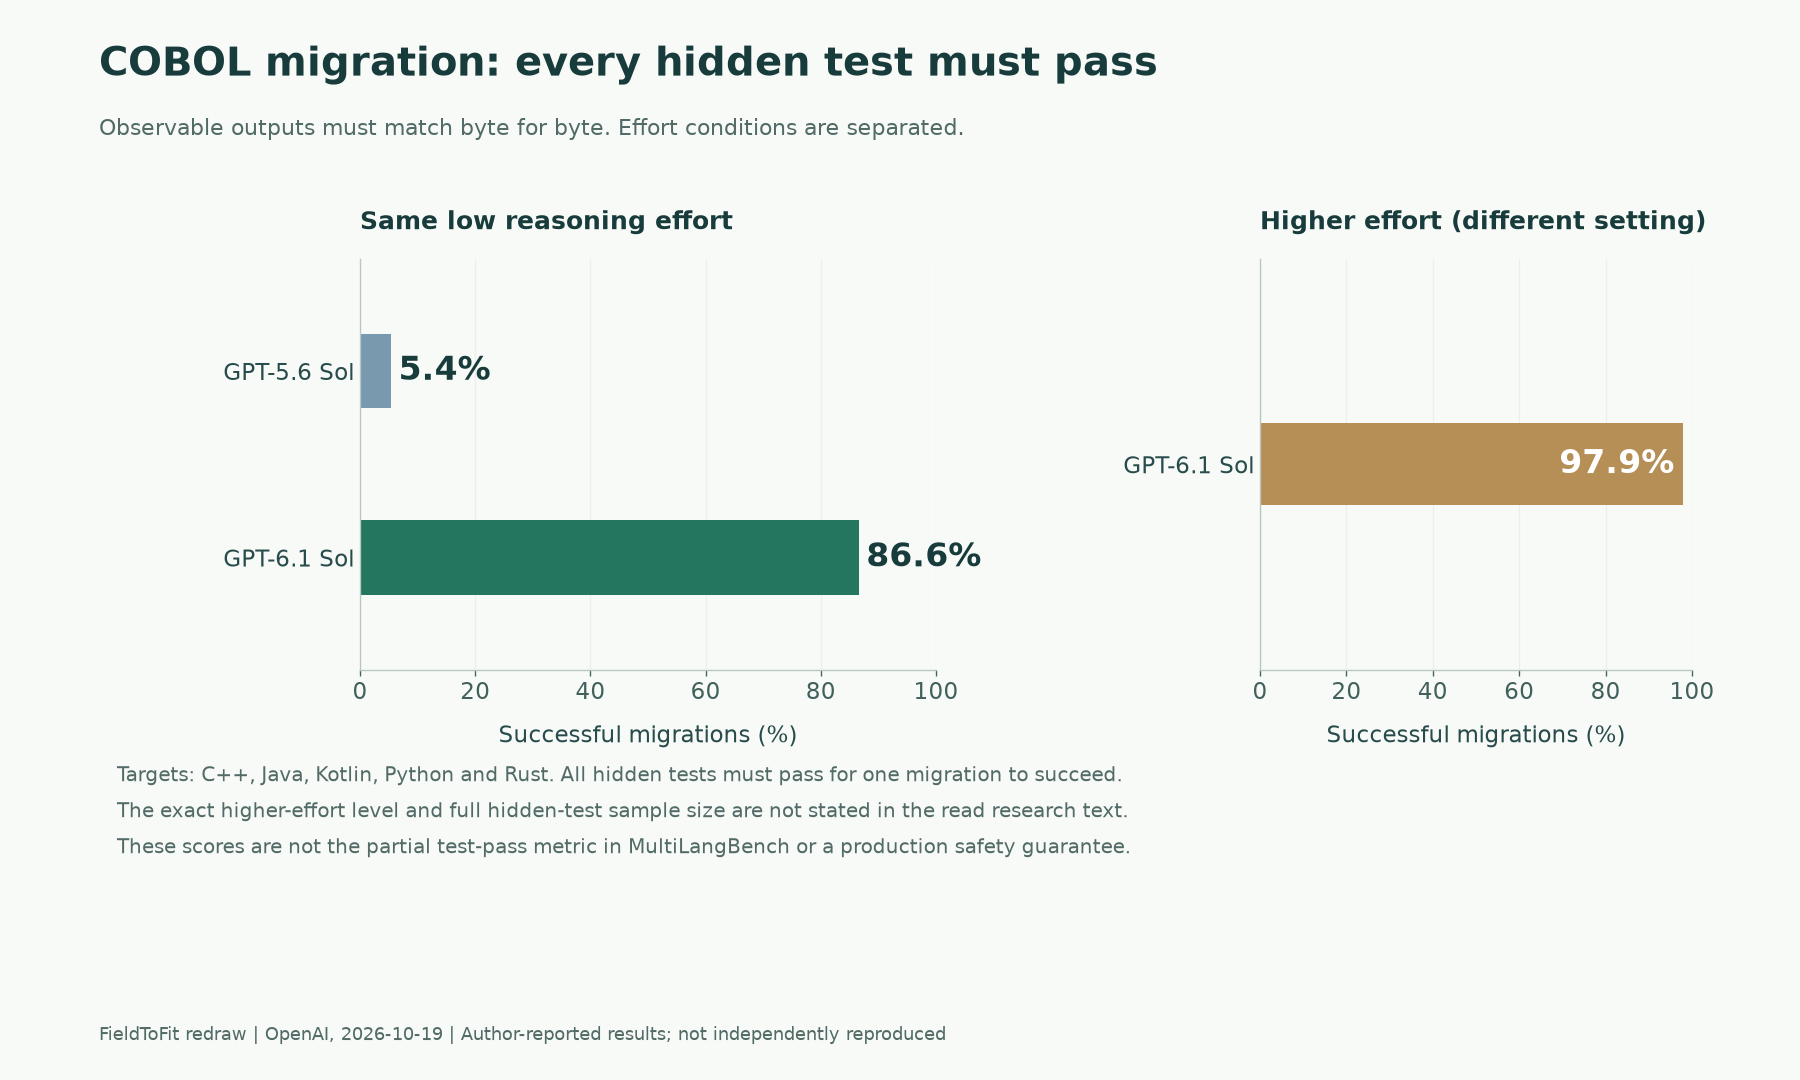
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 2: accuracy at low and higher reasoning effort
相同低推理强度下,GPT-6.1 Sol 为 86.6%,GPT-5.6 Sol 为 5.4%;新模型在更高强度达到 97.9%。前一个数据库评测可获得部分功能分,这里却须全部测试通过,两者分数不能横向当成同一指标。
适用边界:上线边界:隐藏测试覆盖以外的依赖、数据、权限和业务规则仍须专家核对。97.9%不是生产系统零风险迁移的保证。
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Section 2
返回核心结论作者估算 MultiLangBench 中 GPT-6 Luna 平均每样本 0.77 美元,GPT-5.6 Sol 为 3.48 美元,约低 78%。这同时伴随测试通过率从 26.8%升至 40.3%,仍远低于 Astra 的 87.4%;不能只用更便宜推导任务已经足够可靠。
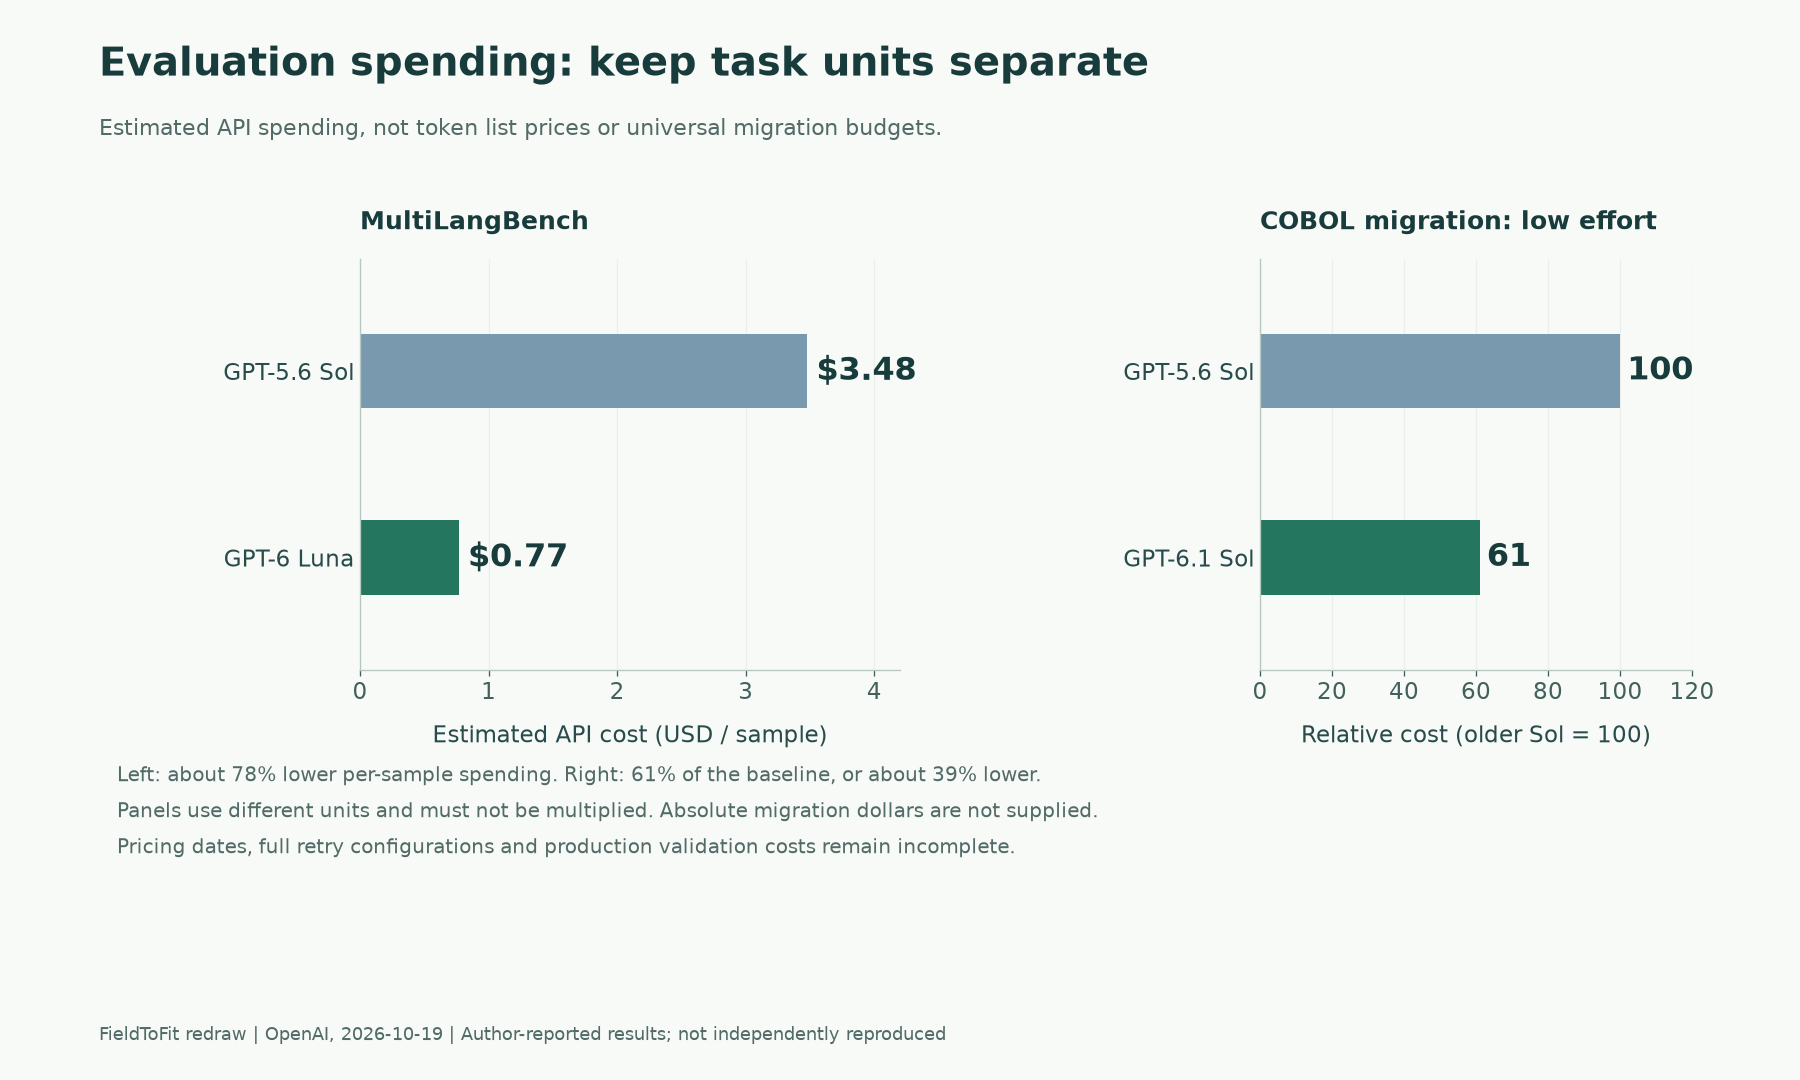
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Sections 1 and 2: estimated API cost
迁移评测中新 Sol 低强度的成本为旧 Sol 的 61%,即约低 39%,同时迁移成功率更高。文章未充分披露每项成本的计价日期、全部提示与重试配置,读者仍需在自己的流程中计入验证、失败重跑和人工复核。
关键证据:本站建议:先固定任务、推理强度、验证规则和预算,再比较成功完成一次任务的总费用;不要从每样本结果反推通用百万 token 价格。
OpenAI 低资源编程语言研究公告(10月 19日来源日期) · Sections 1 and 2: cost
返回核心结论公开仓库说明:约 51k 条 SQLite 原始 TCL 测试中,约 24k 条转换到共同接口;默认使用哈希以 00、01、02 开头的 272 条测试,也可运行完整转换集来提高高分区的精度。README 采用 SQLite 3.40.1 参考语义,单测试超时 60 秒。
适用边界:证据分层:作者实验结果、公开仓库协议和本站采用建议分别记录。实验进步支持进一步试验,不代替真实系统的回归测试、审计和回滚。
OpenAI MultiLangBench 官方开源仓库 · README: Test Suite / Usage / Grading
返回核心结论OpenAI 低资源编程语言研究公告(10月 19日来源日期) · 2026-10-19; unnumbered official web research · 首次发布 2026-10-19 · 上游网页无编号;本次为本站首次整理,不制造上游实质修订。
地图首次发布 2026-10-20T04:22:28.211155+00:00 · 地图修订 2026-10-22T02:54:35.439021+00:00