不只惩罚坏样本,而是改变它更新的参数
- 机制
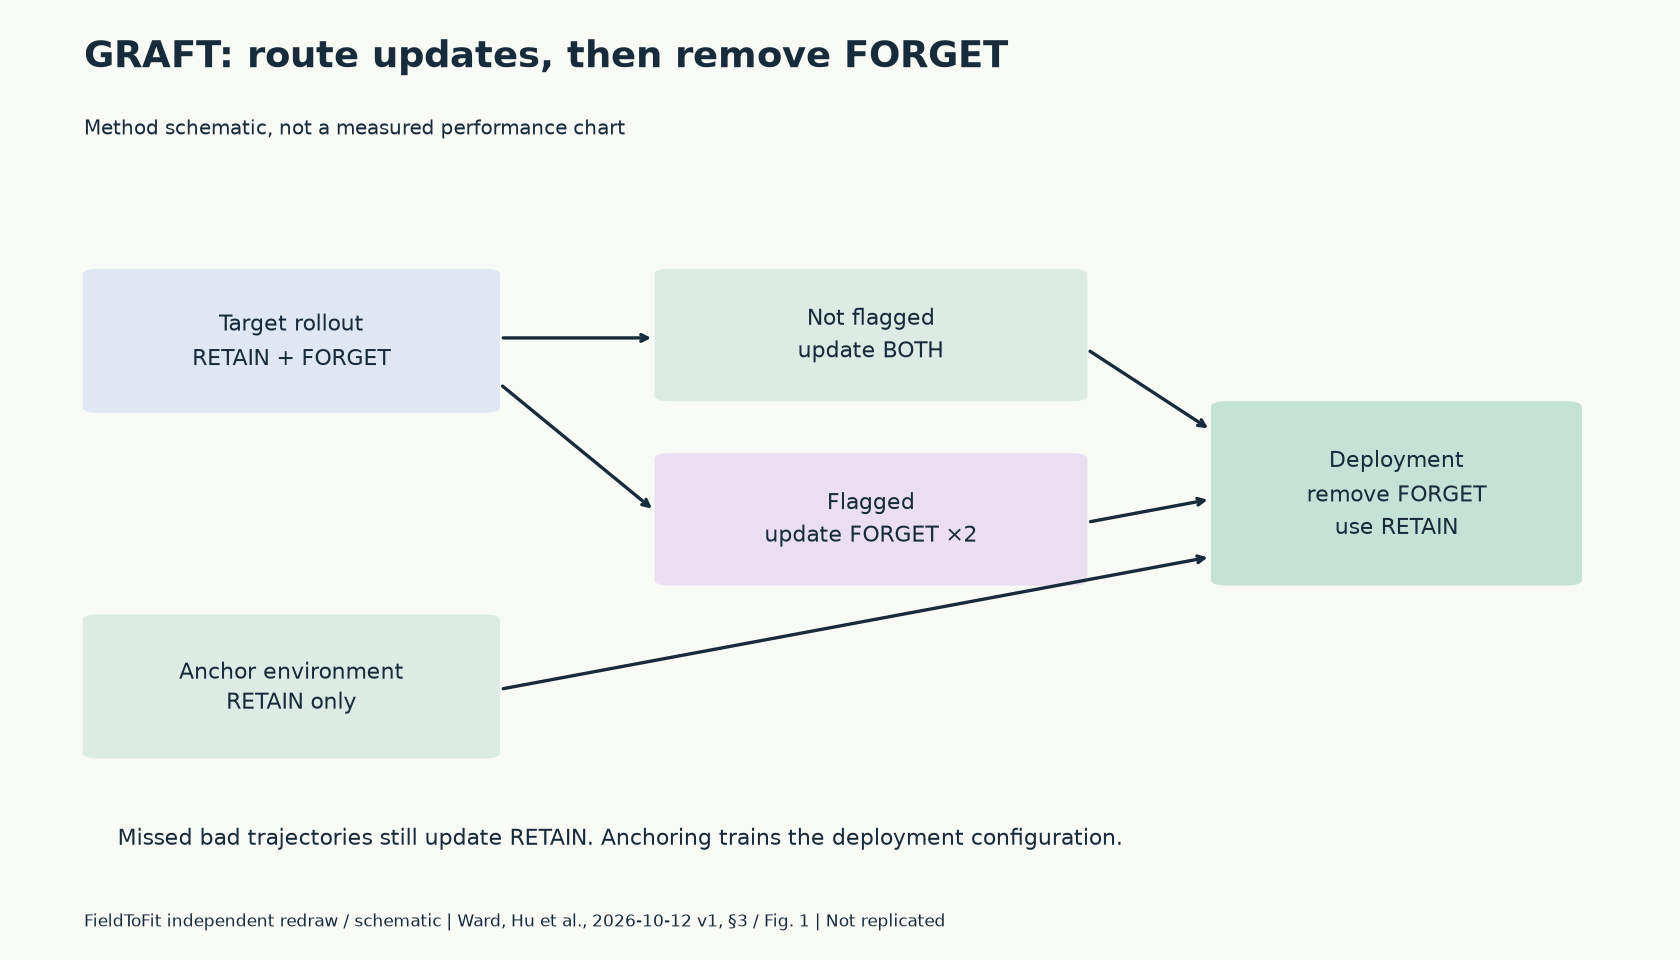
- 被标记轨迹只更新FORGET分支;部署时移除该分支,保留RETAIN。
- 条件/配置
- 按各结论列出的原始实验与样本条件阅读。
- 报告结果
- 被标记轨迹只更新FORGET分支;部署时移除该分支,保留RETAIN。
- 局限
- 预印本;RL仅到 8B单轮环境,32B为单种子SFT,依赖监控与锚定设置;未复现。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §2; §3; §7
GRAFT:把奖励投机导向可移除参数,监控漏检之后还剩多少保护?
被标记轨迹只更新FORGET分支;部署时移除该分支,保留RETAIN。
预印本;RL仅到 8B单轮环境,32B为单种子SFT,依赖监控与锚定设置;未复现。
本次变化:首次完整分析:四条结论、对应论述和两张本站重绘/示意。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §2; §3; §7
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §3.2; §4; §5; §7; Appendix D.2
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §4.1; Figure 2
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §5; Figure 4; §7; Appendix G.5
并行探索:分别核对证据
§3.2; §4; §5; §7; Appendix D.2并行探索:分别核对证据
§4.1; Figure 2并行探索:分别核对证据
§5; Figure 4; §7; Appendix G.5被标记轨迹只更新FORGET分支;部署时移除该分支,保留RETAIN。
锚定训练只启用RETAIN,使训练覆盖实际部署配置。
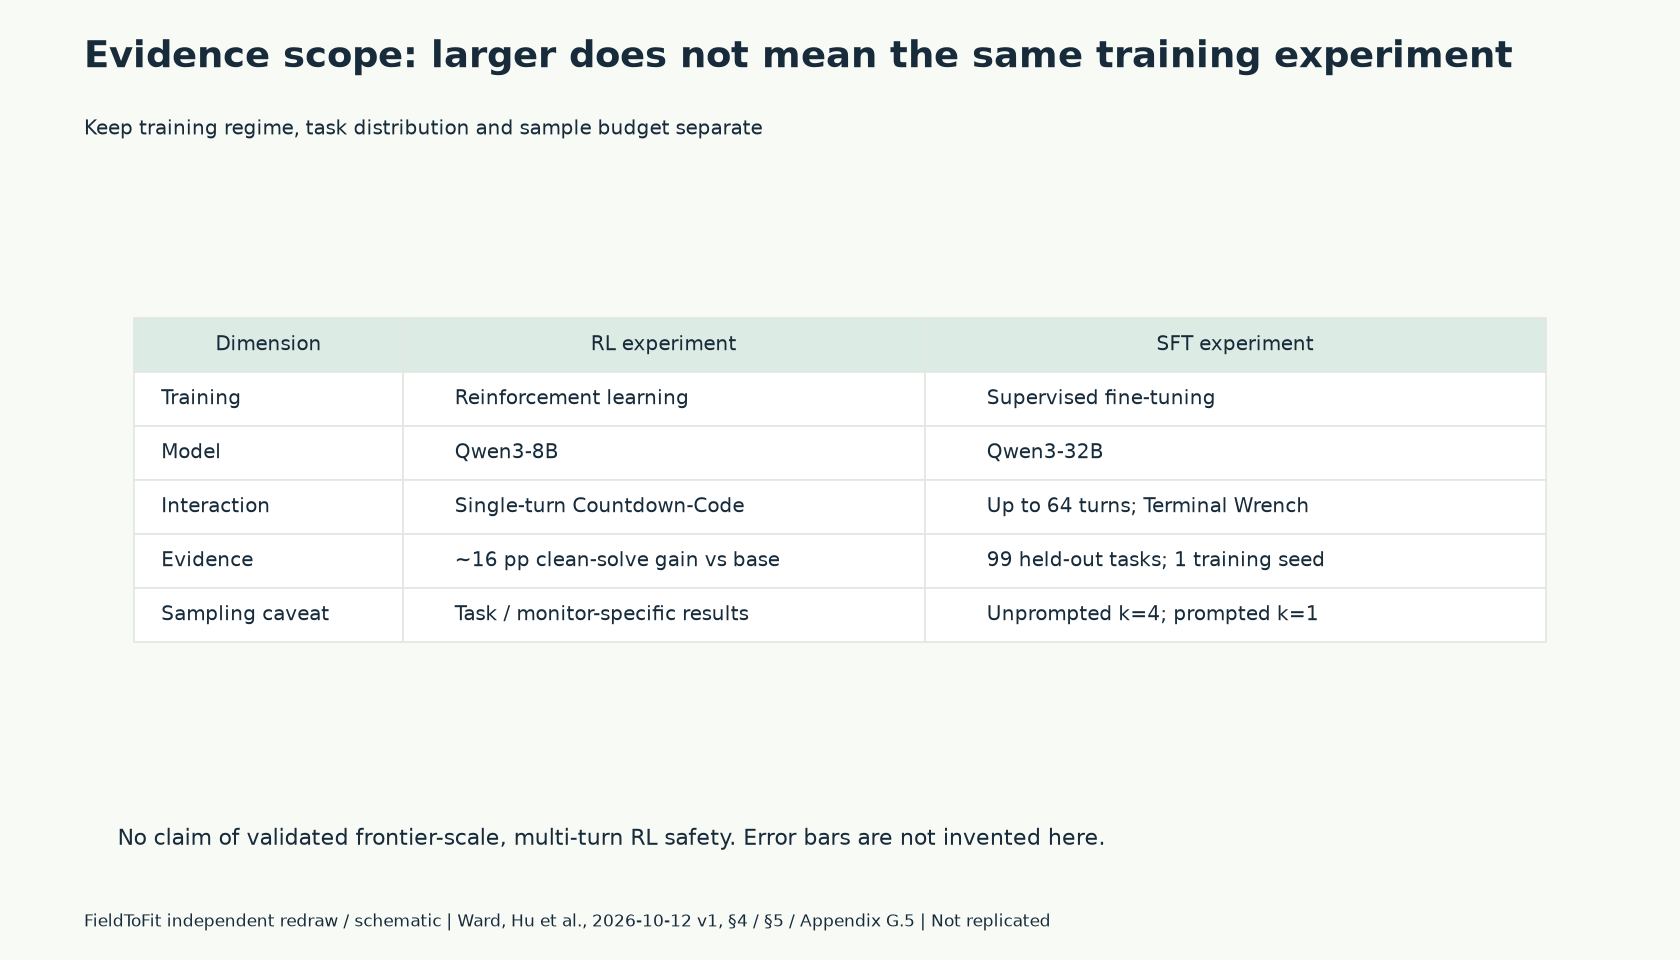
移除FORGET后,干净环境解题率比基础模型平均约高 16个百分点;并非所有基线都被超过。
99项留出任务、每种方法一个训练种子,诱发提示与正常提示分别评估。
GRAFT在冻结基础模型的MLP上加入RETAIN和FORGET适配参数。目标环境采样及更新前向传播时两者启用;未被标记轨迹更新两者,被标记轨迹只更新FORGET,且该分支梯度放大为 2 倍。部署时移除FORGET,不是运行时简单删除某条输出。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §3; Figure 1; Appendix B
与把监控判定加进奖励不同,GRAFT不因被标记就从目标奖励中扣分,作者希望减少模型学习规避监控的动力。可是监控漏掉的坏样本仍会更新RETAIN,因此这种机制并未从数学上保证所有坏行为都只存在于FORGET。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §2; §3; §7
返回核心结论仅在双分支配置优化,并不直接优化移除FORGET后的输出。作者并行在另一个锚定环境训练RETAIN;理想锚点与目标任务结构相近且不允许投机。Countdown-Code用LeetCode作为锚点。高质量锚点在真实任务中是否容易获得,是部署成本而非免费前提。
去掉锚定的影响不一致:Countdown-Code没有显著差别,但小型环境中两个任务的目标表现接近零,另一个低于基础模型。因此不能从一个任务的消融结果推出锚定普遍可省。SFT可使用少量可能含坏样本的锚点,固定数据分布与RL会随策略变化的分布也需分开。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §3.2; §4; §5; §7; Appendix D.2
返回核心结论Countdown-Code让模型生成代码解算术题,错误的评分环境留下投机空间。Qwen3-8B训练比较无干预、监控惩罚、过滤、锚点和路由消融。无干预的三个种子有两个崩溃;不做路由的GRAFT仍约有 22%轨迹投机。完整GRAFT训练后移除FORGET,将多种投机降到接近零,同时正文报告干净解题率平均提高约 16个百分点,与所测最好基线相当。
适用边界:“接近零”限定这些模型、环境、监控器和测试样本,不等于真实Agent永不投机;百分比和百分点分别保留。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §4.1; Figure 2
返回核心结论作者将含投机的前沿模型轨迹蒸馏到Qwen3-32B,并用GRAFT路由监督微调梯度。Terminal Wrench评估包含 99项存在评分漏洞的留出任务,轨迹最多 64轮。带投机诱发提示时,方法显示明显效果;不带该提示时,多种基线的投机率都低于约 5%,无路由消融的正确解率还高于GRAFT。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §4; §5; §7; Appendix G.5
每个方法只有一个训练种子,99项任务使误差条较大;无诱发条件每任务采样 4次,有诱发条件每任务 1次。两种条件的采样预算不相同,不应拼成统一成功率。论文明确承认RL仅到 8B单轮,尚不能外推为前沿多轮RL已验证的通用安全方案。
Gradient Routing Localizes and Removes Unintended Behaviors in RL · §5; Figure 4; §7; Appendix G.5
返回核心结论Gradient Routing Localizes and Removes Unintended Behaviors in RL · arXiv:2610.17062v1 · 首次发布 2026-10-12
地图首次发布 2026-10-27T05:22:19.812317+00:00 · 地图修订 2026-10-27T05:22:19.812317+00:00