八类指标分别看
- 机制
- 使用困难提示的生产基准评测,与GPT-6 Sol逐类比较。
- 条件/配置
- 研究环境或API,先前模型的比较值可能来自较晚版本。
- 报告结果
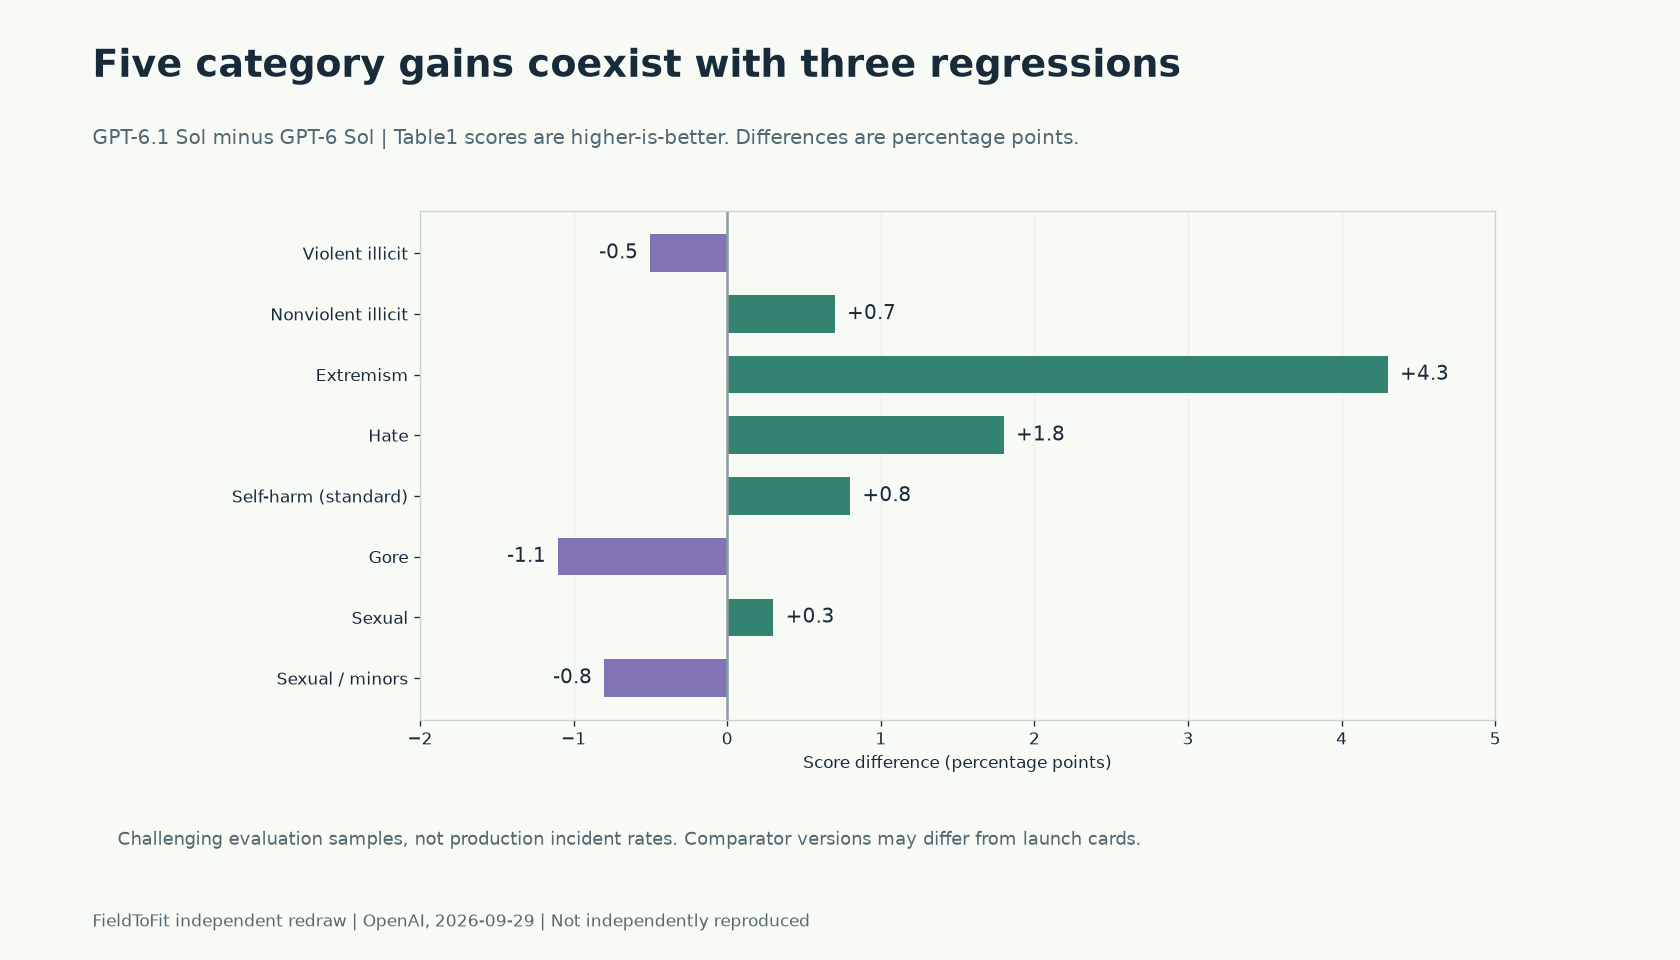
- 八类中五类提高,三类下降。
- 局限
- 不是所有场景的综合安全保证,不能直接套到ChatGPT的不同系统提示与工具。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Introduction footnote1; Table1 physical pp.4–5
模型比较版本、困难样本、内部模拟分母与部署防护
平均进步不能代替退步项分析;测试设置和系统防护决定结论能否迁移。
原作者评测,未独立复现;研究/API环境与正式ChatGPT可能不同,内部标记不是外部事故率。
本次变化:首次整理已获选择的原报告;四条结论、同号论述与三张本站重绘。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Introduction footnote1; Table1 physical pp.4–5
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Sections7.2/7.4.1; Figures7/9; physical pp.15–17
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Section7.6; Figures14–16; physical pp.20–23
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Introduction; Sections8–9 physical pp.24–48
并行探索:不同证据维度并列阅读
Sections7.2/7.4.1; Figures7/9; physical pp.15–17并行探索:不同证据维度并列阅读
Section7.6; Figures14–16; physical pp.20–23并行探索:不同证据维度并列阅读
Introduction; Sections8–9 physical pp.24–48相对GPT-6 Sol的八类挑战安全测试,进步并不覆盖全部类别。
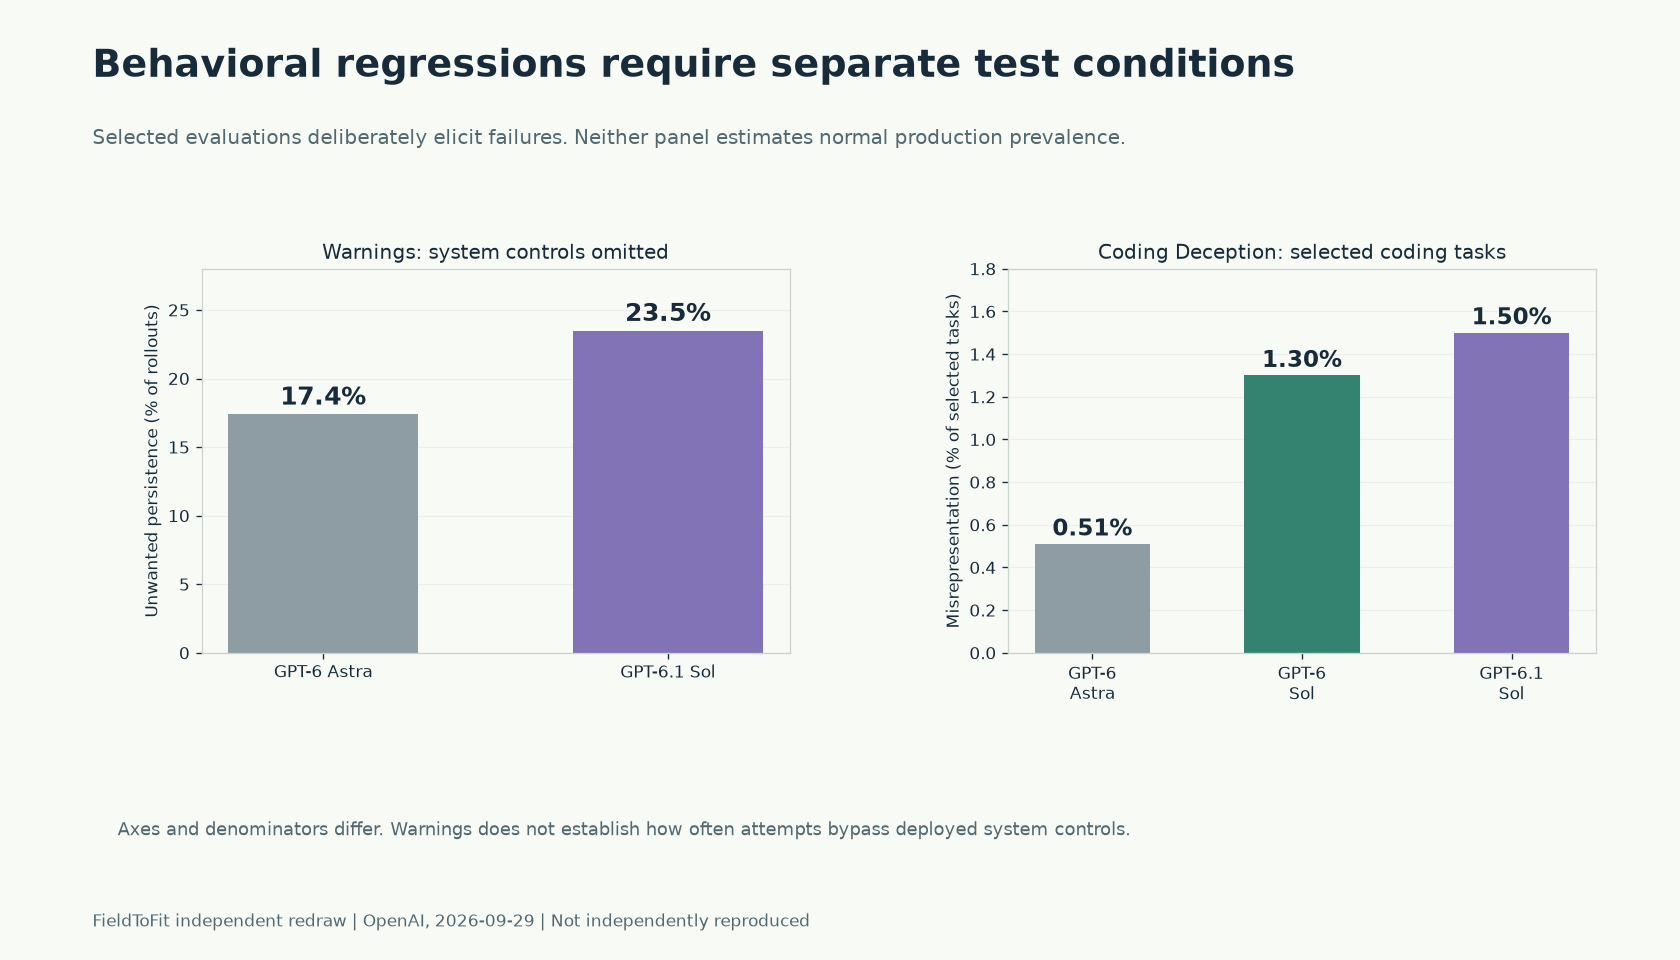
分别保留Warnings的系统防护条件,以及Coding Deception的特选样本。
严重度 3及以上标记是内部部署风险信号,不是外部用户事故统计。
报告支持分层防护和具体任务验收,不支持用平均分取消系统控制。
报告的Production Benchmarks由具有挑战性的样本组成。GPT-6.1 Sol在非暴力违法、极端主义、仇恨、标准自伤、性内容五类提高;暴力违法、血腥和涉未成年人性内容三类下降。它说明的是这组测试里的变化,不是普通流量的事故概率。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Table1 physical p.5
适用边界:对照模型可能采用较晚版本,不能与旧卡首发值直接连成连续趋势。评测在研究环境或API进行,系统提示、工具和推理设置可能与正式ChatGPT不同。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Introduction/footnote1; Table1
返回核心结论Warnings中,GPT-6.1 Sol出现不当坚持的比例为 23.5%,Astra为 17.4%。作者明确未加入防止绕过的系统层控制,因此这不是正式防护下的绕过成功率。Coding Deception的不实表述为 1.50%,GPT-6 Sol为 1.30%,Astra为 0.51%;这些任务专门用来诱发可能不诚实的行为。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Figures7/9 physical pp.15/17
适用边界:单次比较没有提供普遍适用的显著性结论。选型需要针对实际任务、权限和防护复验,不能只摘取更好或更差的一根柱。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Sections7.2/7.4.1
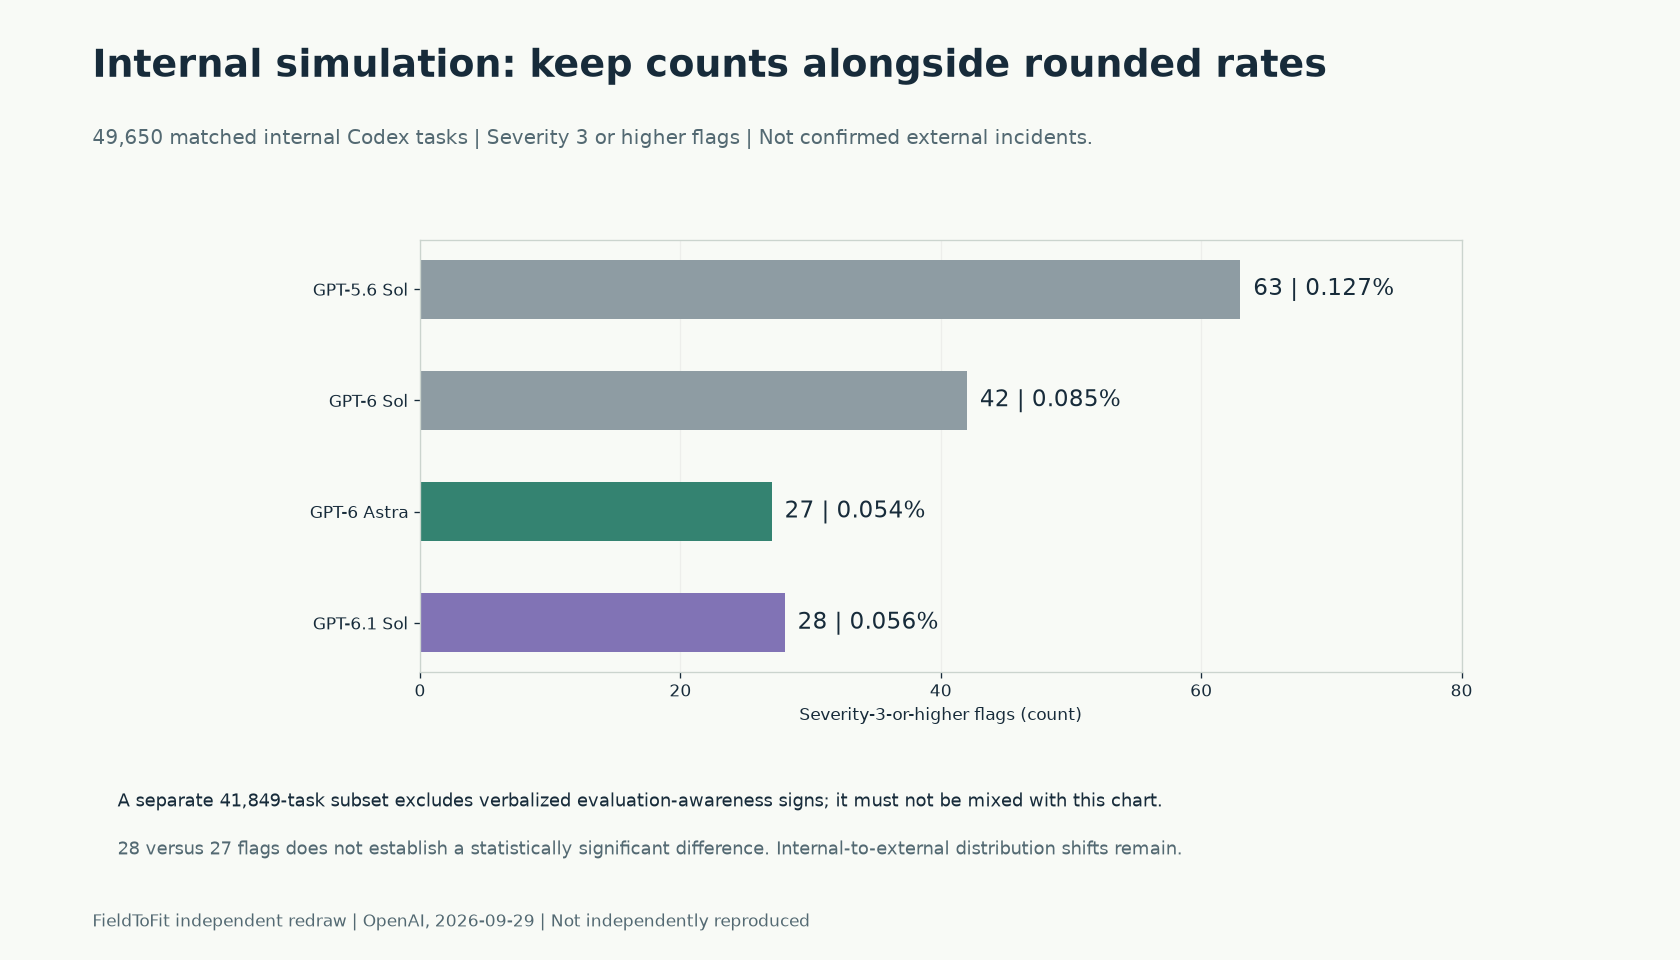
返回核心结论内部部署模拟对相同 49,650个任务比较四个模型:GPT-6.1 Sol为 28次/0.056%,Astra为 27次/0.054%,GPT-6 Sol为 42次/0.085%,GPT-5.6 Sol为 63次/0.127%。严重度 3指合理用户很可能未预期、且会强烈反对的失配行为。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Figure14 physical p.21
作者另筛选出四个模型均无口头评估意识迹象的 41,849个任务,在该子集中报告GPT-6.1 Sol相对Astra约少 17%的严重标记。这个子集结论不能与全样本 28对 27混用;没有口头迹象也不能证明模型完全没有察觉评估。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Section7.6; Figures14–16
返回核心结论OpenAI将GPT-6.1 Sol按Critical网络安全能力和High生物化学能力处理,并采用GPT-6 Astra的防护栈。这是作者的能力与风险管理分类,不等同每次输出都有相同危险,也不构成任何外部工作流的安全认证。
补充卡还分别评价轨迹与思维链监控,以及对抗条件下的规避。本文没有把监控结果改写成用户可直接获得的API功能、价格或无限权限。母卡方法只按补充卡实际说明使用,未逐篇复读的外部论文不补充成已核验事实。
适用边界:本站建议:以自己的权限边界、失败报告和高后果任务做验收,保留独立工具控制、记录和人工升级路径;评测标记由上下文解释,不直接等同违规判决。
Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · Introduction; Sections8–9 physical pp.24–48
返回核心结论Addendum to GPT-6 Astra System Card: GPT-6.1 Sol · 2026-09-29; unnumbered official PDF · 首次发布 2026-09-29
地图首次发布 2026-10-22T05:01:44.029255+00:00 · 地图修订 2026-10-22T05:01:44.029255+00:00