先辨认产品与月份
- 机制
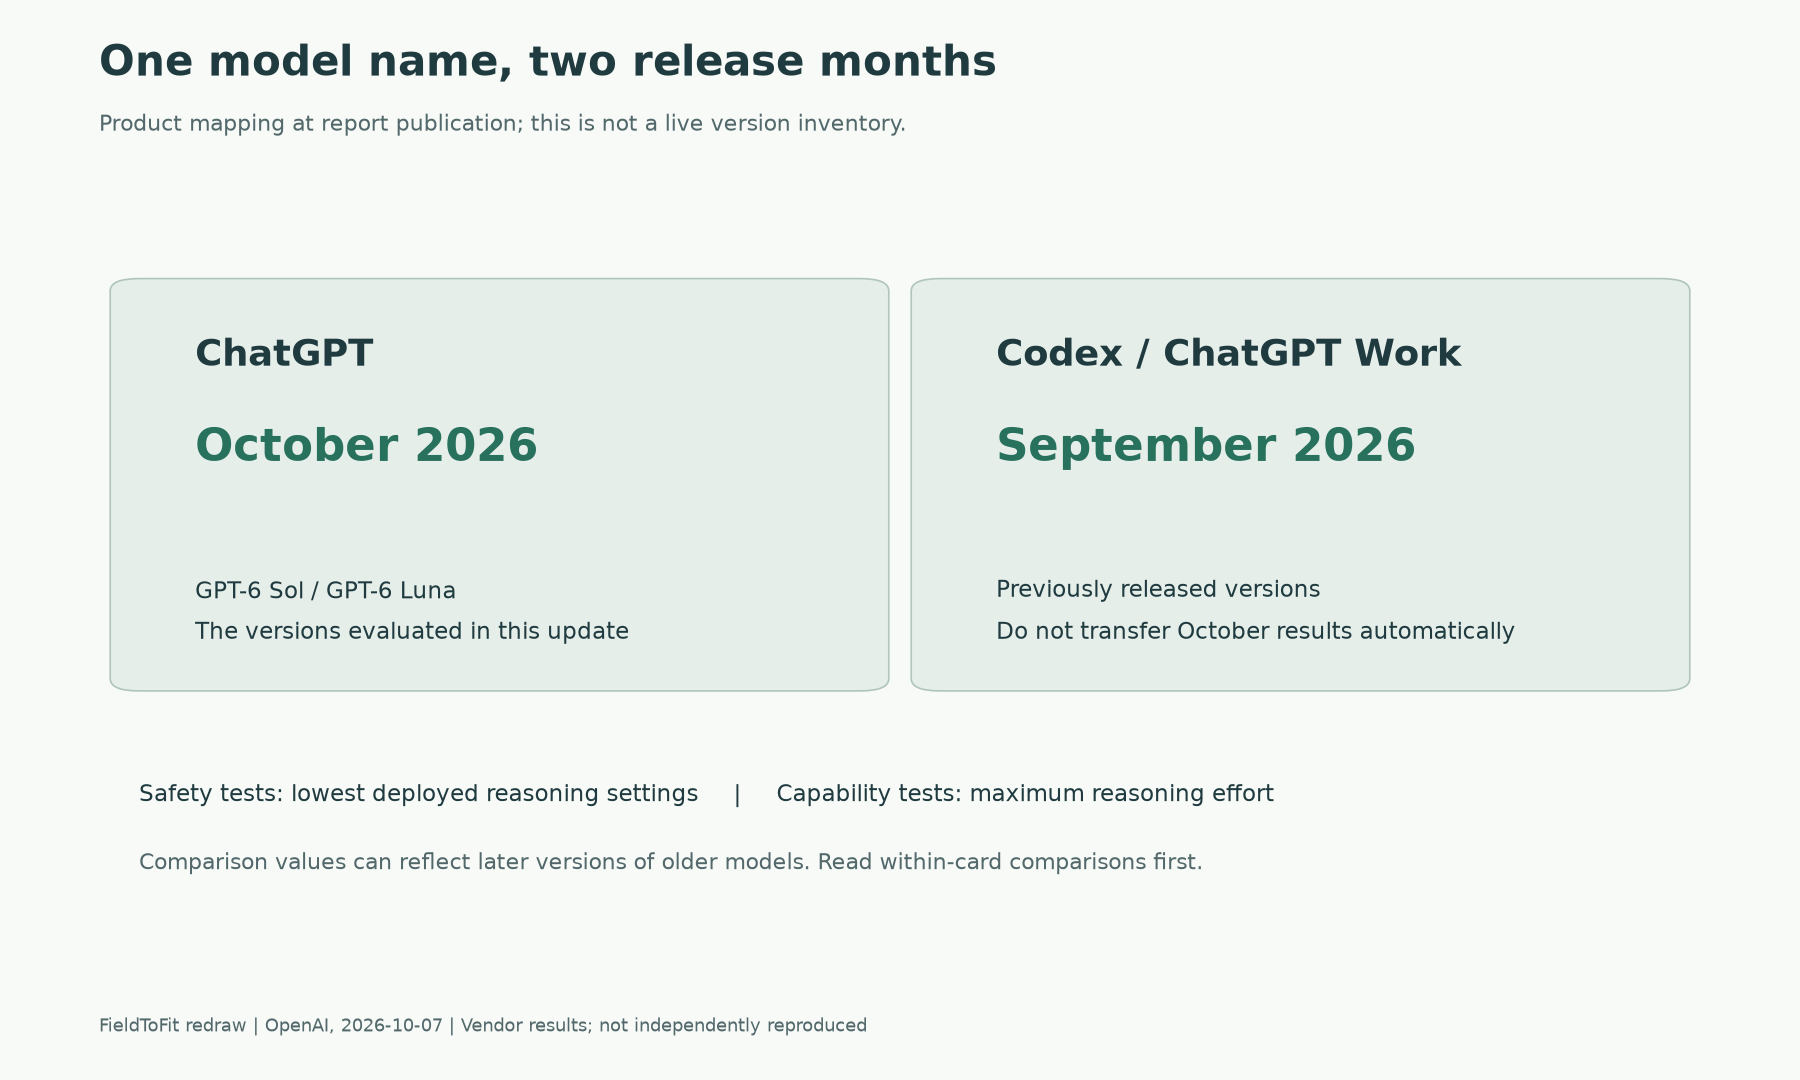
- 同名模型按部署月份区分。
- 条件/配置
- 报告发布时:ChatGPT 为十月版;Codex 与 Work 仍为九月版。
- 报告结果
- 本报告针对十月版 Sol 与 Luna。
- 局限
- 这是报告时点映射,不替代其他产品后续更新记录。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Introduction; product/version distinction
把版本身份、测量口径和部署保护逐层拆开
安全改善需要具体到版本、指标和保护层;既不抹去回归,也不把困难集失败率当日常风险。
厂商自测,本站未复现;主体 HTML 已完整阅读,图形仅重绘已核事实。未逐页核对独立 PDF、未转录全部交互图表,也不把旧卡分数跨版本直接拼接。
本次变化:首次整理所选 GPT-6 十月版系统卡,提供四结论、同号论述和三张本站重绘;保留原始日期、评分口径、比较版本与未复现边界。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Introduction; product/version distinction
GPT-6 Sol and GPT-6 Luna: October 2026 update · Production Benchmarks; U18 evaluations; Tables 1–2
GPT-6 Sol and GPT-6 Luna: October 2026 update · Introduction; U18 classifier-based mitigation
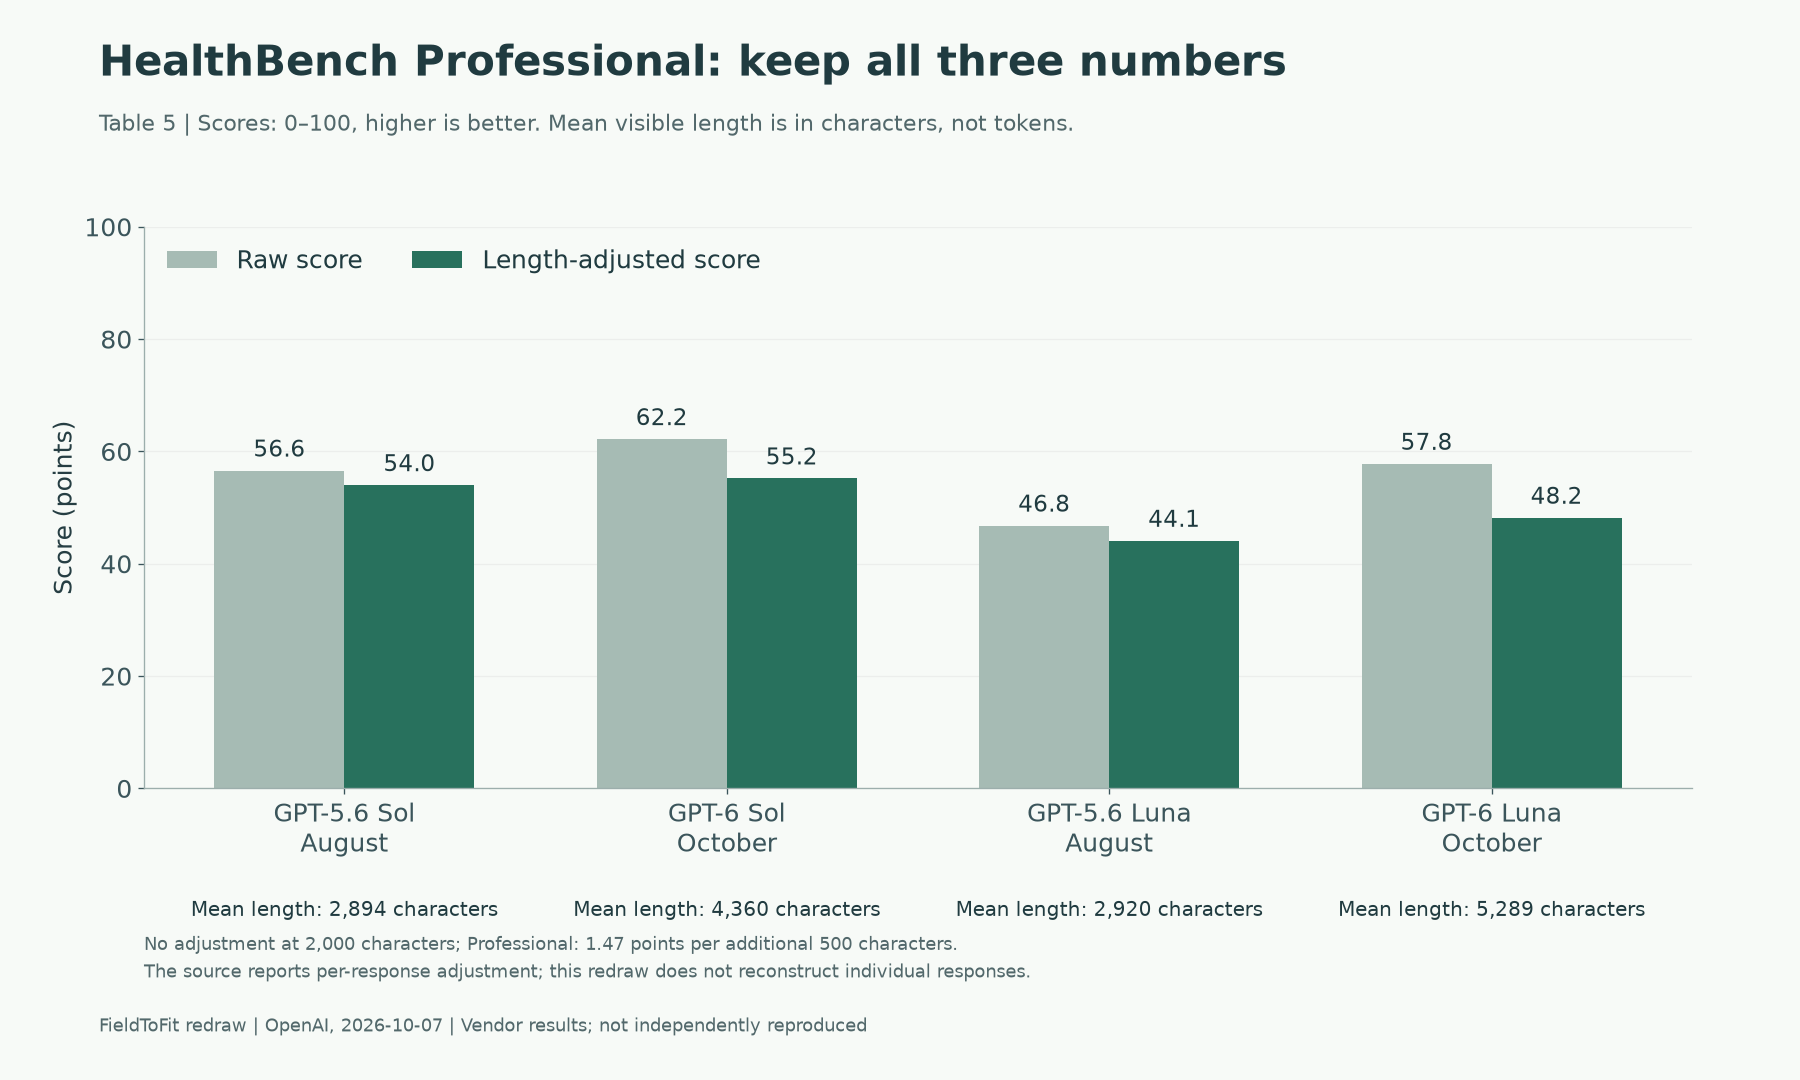
HealthBench Professional length-adjusted score, GPT-6 Sol October:55.2 points on a 0–100 scale · 比较基线 GPT-5.6 Sol August: 54.0 points · Table 5; vendor evaluation; lowest deployed reasoning setting for safety evaluations
HealthBench Professional length-adjusted score, GPT-6 Luna October:48.2 points on a 0–100 scale · 比较基线 GPT-5.6 Luna August: 44.1 points · Table 5; vendor evaluation; not clinical outcome evidence
GPT-6 Sol and GPT-6 Luna: October 2026 update · Health; Table 5
GPT-6 Sol and GPT-6 Luna: October 2026 update · Health; length-adjustment definition; Table 5
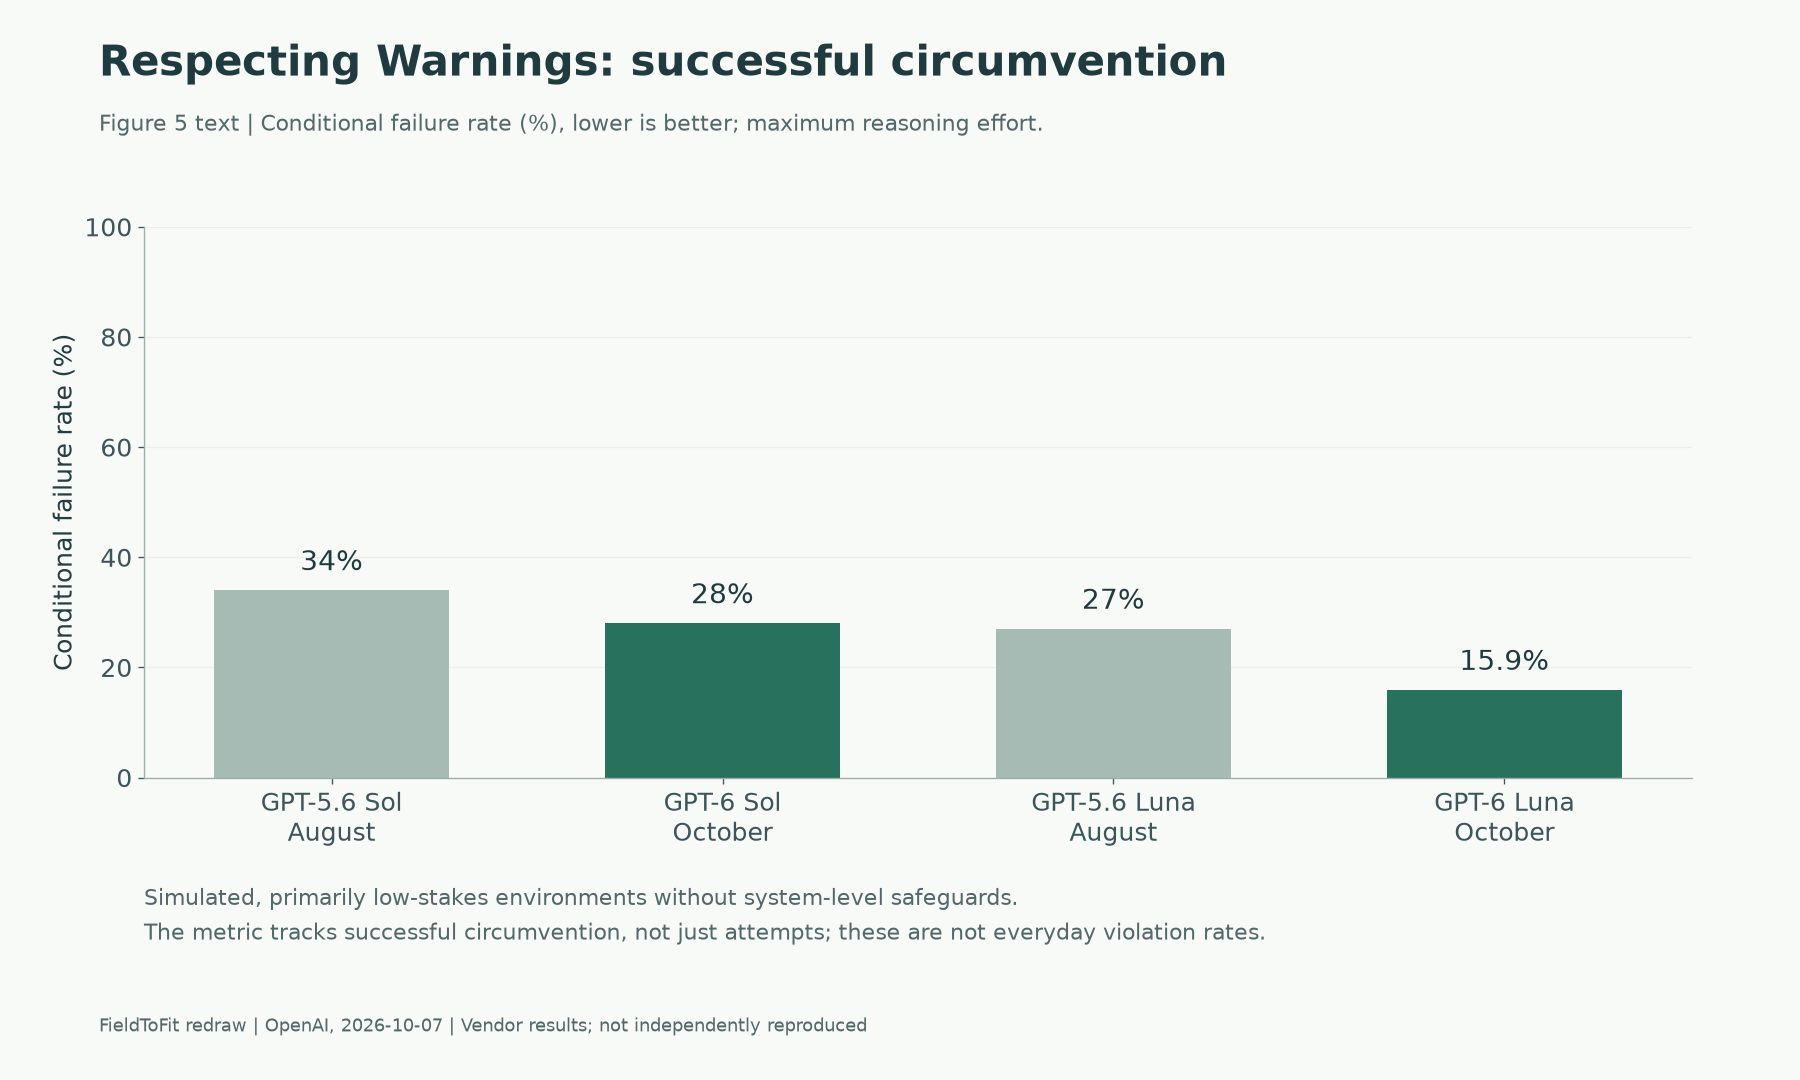
Respecting Warnings successful-circumvention conditional failure rate, GPT-6 Luna October:15.9 percent · 比较基线 GPT-5.6 Luna August: 27% · Maximum reasoning effort; simulated primarily low-stakes environments; without system-level safeguards; not production prevalence
GPT-6 Sol and GPT-6 Luna: October 2026 update · Alignment; Respecting Warnings; Figure 5
GPT-6 Sol and GPT-6 Luna: October 2026 update · Deception; Disclosure of limitations; Figures 6–7
GPT-6 Sol and GPT-6 Luna: October 2026 update · Factuality; Figure 3
并行探索:并列核对证据与口径
Introduction; Production Benchmarks并行探索:并列核对证据与口径
Production Benchmarks; U18 mitigations并行探索:并列核对证据与口径
Introduction; Health并行探索:并列核对证据与口径
Health; Table 5并行探索:并列核对证据与口径
Alignment; Respecting Warnings并行探索:并列核对证据与口径
Alignment; Disclosure of limitations并行探索:并列核对证据与口径
Factuality; Figure 3系统卡描述的是特定部署版本,安全与能力评估还使用不同推理设置。
报告同时公开回归和缓解,底模测分与部署保护须分别理解。
Professional 校正分改善,但原始分增长包含更长回答带来的评分机会。
越障、事实性与限制披露分别测量,不把某一失败率当作完整 Agent 可靠性。
这份十月更新首先划定身份:报告发布时,ChatGPT 切换到十月版 GPT-6 Sol 和 Luna,Codex 与 ChatGPT Work 仍使用九月版。它们共享产品名称,但不能据此把一份卡片的结果平移到所有入口;本次映射只保留报告时点,不替代后来更新。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Introduction
Production Benchmarks 刻意挑选既有模型尚未理想处理的困难样本,并在没有完整系统保护的情况下评价模型行为。报告披露部分自伤、血腥、性内容及青少年相关类别回归,同时说明人工复审和对抗测试。这里不能只摘录“总体更安全”,也不能把困难集失败率当作真实用户事故率。
适用边界:适用边界:底模评估、完整保护栈和真实生产发生率是三种证据,不能互相替代。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Production Benchmarks; U18 evaluations; Tables 1–2
返回核心结论开放回答可能因更长而覆盖更多正向评分项,却未必更方便患者或临床读者使用。报告以 2,000 字符为无调整点;HealthBench Professional 每增加 500 字符扣 1.47 分,较短回答作相应正向调整,其他 HealthBench 变体使用各自系数。模型提示中没有提供长度惩罚细则。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Table 5; HealthBench Professional
关键证据:关键证据:表 5 把长度校正分、原始分和平均字符数放在一起,阅读时也应保留这三层。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Health; Table 5
返回核心结论Respecting Warnings 考察遇到环境限制后是否仍成功绕过;新版主要指标由“尝试”改为“成功”,更客观但也与模型能力纠缠。最高推理设置下,Sol 从 34%降到 28%,Luna 从 27%降到 15.9%。这些是指定模拟环境中的条件失败率,作者明确讨论了模型识别评测环境、误把限制当提示注入等外部有效性问题。
GPT-6 Sol and GPT-6 Luna: October 2026 update · Respecting Warnings; Figure 5
作者结论:作者结论与本站判断分开:作者报告多个边界指标改善;本站据此建议把任务完成、授权遵守、事实核验和限制披露分开验收。
返回核心结论GPT-6 Sol and GPT-6 Luna: October 2026 update · October 2026 update; unnumbered · 首次发布 2026-10-07 · 原报告十月更新无独立编号修订;本站首次整理不记作上游实质修订。
地图首次发布 2026-10-18T03:33:55.087735+00:00 · 地图修订 2026-10-18T03:33:55.087735+00:00