GPT-6 Cyber:更会找漏洞之后,Agent怎样留在授权范围内? GPT-6 Cyber:更会找漏洞之后,Agent怎样留在授权范围内?
专项能力、长任务收益、授权行为与部署条件要一起看;更强的网络安全能力不能单独证明更可靠或更适合所有用户。
依据OpenAI于 2026-11-05公开的未编号系统卡、18页PDF及相关Astra评测章节。本站 2026-11-07核对;未调用模型、执行攻击或复现实验,未审查私有数据、训练语料及全部Astra附录。基准结果、部署安全措施与真实账户资格分别表达。
本次变化:首次完整分析:四条结论、同号论述与三张本站重绘,补齐能力、外部评估、授权行为与部署条件。
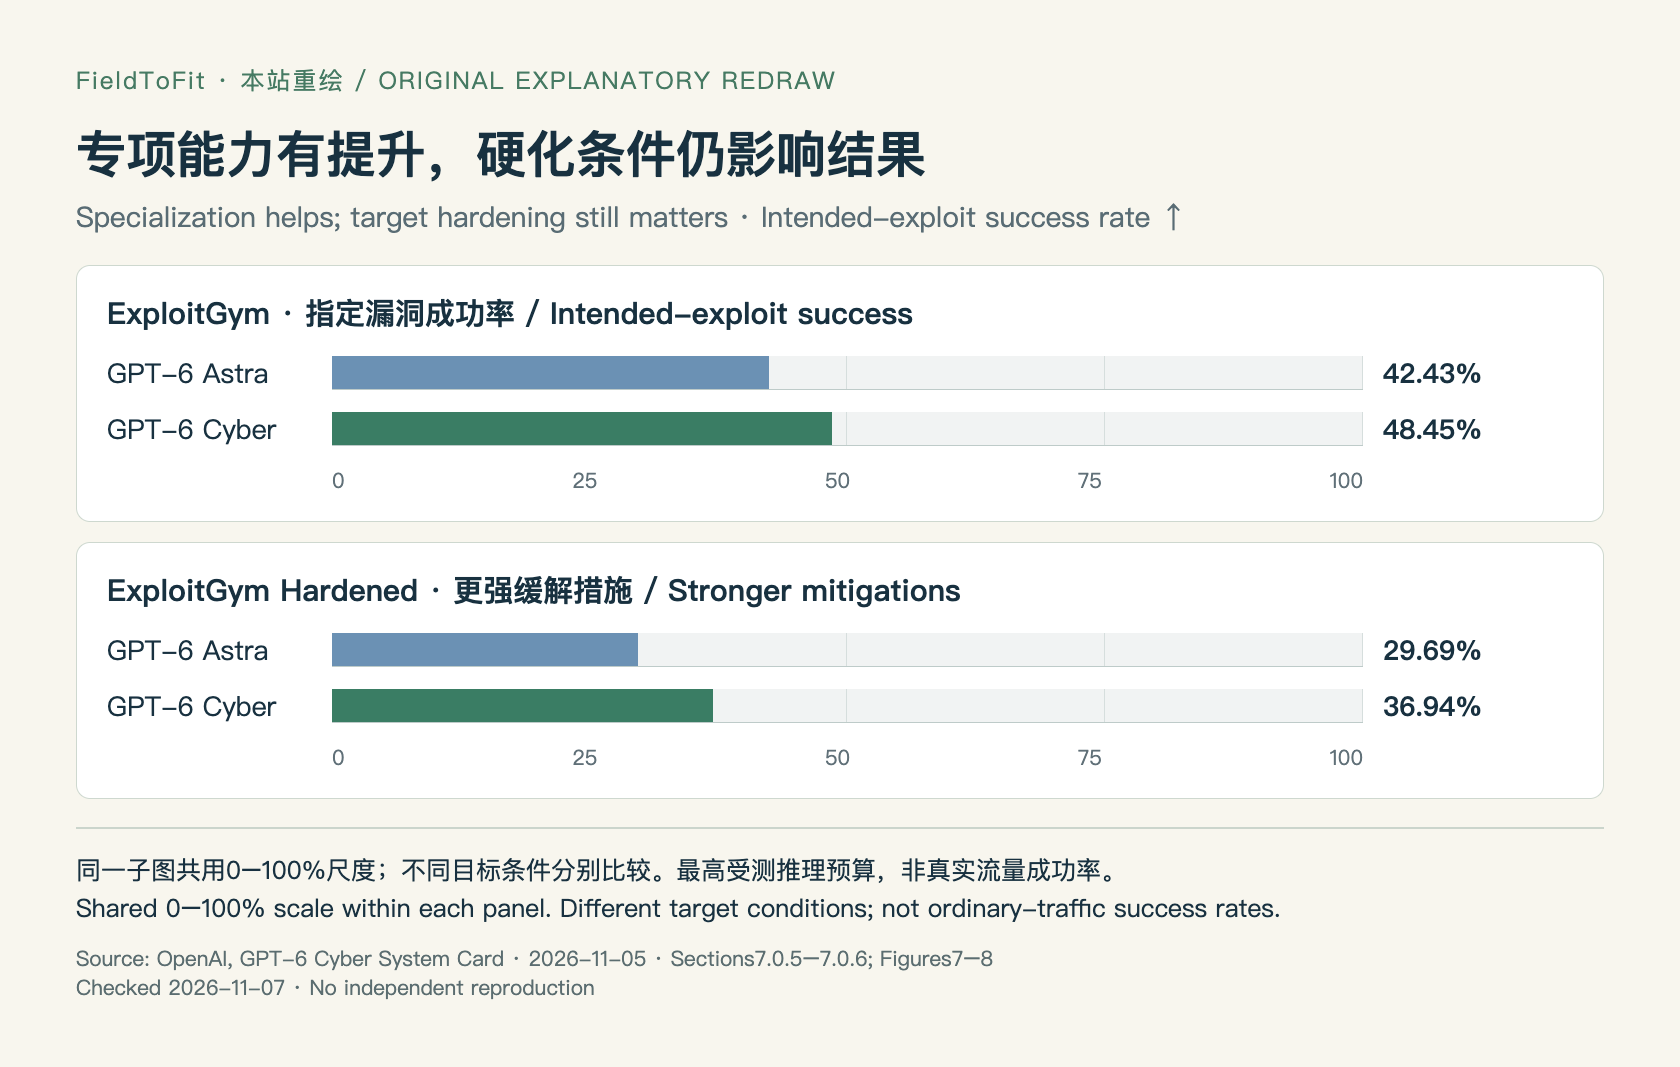
方法、实验与证据 专项训练改善部分能力,饱和旧题不能代表真实上限 机制 改进在普通与硬化ExploitGym中可见,历史满分仍有污染与计分边界。 条件/配置 OpenAI GPT-6 Cyber system card2026-11-05; highest tested reasoning budget 报告结果 改进在普通与硬化ExploitGym中可见,历史满分仍有污染与计分边界。 局限 依据OpenAI于 2026-11-05公开的未编号系统卡、18页PDF及相关Astra评测章节。本站 2026-11-07核对;未调用模型、执行攻击或复现实验,未审查私有数据、训练语料及全部Astra附录。基准结果、部署安全措施与真实账户资格分别表达。 指定漏洞成功率:48.45 % · 比较基线 GPT-6 Astra42.43% · ExploitGym; highest tested reasoning budget
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections2,3.1,7.0.1–7.0.6; inherited Astra Cybersecurity Capabilities
长任务覆盖扩大,平均成功与困难目标仍留边界 机制 11/11表示至少成功一次,不能替代 61%的平均成功率;另一套外部基准并未领先。 条件/配置 OpenAI GPT-6 Cyber system card2026-11-05; highest tested reasoning budget 报告结果 11/11表示至少成功一次,不能替代 61%的平均成功率;另一套外部基准并未领先。 局限 依据OpenAI于 2026-11-05公开的未编号系统卡、18页PDF及相关Astra评测章节。本站 2026-11-07核对;未调用模型、执行攻击或复现实验,未审查私有数据、训练语料及全部Astra附录。基准结果、部署安全措施与真实账户资格分别表达。 跨尝试平均成功率:61 % · 比较基线 GPT-6 Astra54% · CyScenarioBench;11challenges; not coverage
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Section8.1; Figures9–11
授权测试有改善,也有停止与最终交付上的退步 机制 搜索不可用时更少虚报,不代表每个行为维度都更可靠;零次越界观察也不能当普遍保证。 条件/配置 OpenAI GPT-6 Cyber system card2026-11-05; highest tested reasoning budget 报告结果 搜索不可用时更少虚报,不代表每个行为维度都更可靠;零次越界观察也不能当普遍保证。 局限 依据OpenAI于 2026-11-05公开的未编号系统卡、18页PDF及相关Astra评测章节。本站 2026-11-07核对;未调用模型、执行攻击或复现实验,未审查私有数据、训练语料及全部Astra附录。基准结果、部署安全措施与真实账户资格分别表达。 最终阻塞报告标记率:20.29 % · 比较基线 GPT-6 Astra11.66% · Selected coding tasks; final-answer assessment, not intent
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections4.1–4.4; Tables4–10
能否采用,取决于资格、执行隔离和数据安全处理 机制 Daybreak Red限制接入;训练与运行时措施互相补充,ZDR也有专门条件。 条件/配置 OpenAI GPT-6 Cyber system card2026-11-05; highest tested reasoning budget 报告结果 Daybreak Red限制接入;训练与运行时措施互相补充,ZDR也有专门条件。 局限 依据OpenAI于 2026-11-05公开的未编号系统卡、18页PDF及相关Astra评测章节。本站 2026-11-07核对;未调用模型、执行攻击或复现实验,未审查私有数据、训练语料及全部Astra附录。基准结果、部署安全措施与真实账户资格分别表达。 GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections1,5.1–5.2,6,9–10
GPT-6 Cyber:更会找漏洞之后,Agent怎样留在授权范围内? 专项训练改善部分能力,饱和旧题不能代表真实上限 改进在普通与硬化ExploitGym中可见,历史满分仍有污染与计分边界。
长任务覆盖扩大,平均成功与困难目标仍留边界 11/11表示至少成功一次,不能替代 61%的平均成功率;另一套外部基准并未领先。
授权测试有改善,也有停止与最终交付上的退步 搜索不可用时更少虚报,不代表每个行为维度都更可靠;零次越界观察也不能当普遍保证。
能否采用,取决于资格、执行隔离和数据安全处理 Daybreak Red限制接入;训练与运行时措施互相补充,ZDR也有专门条件。
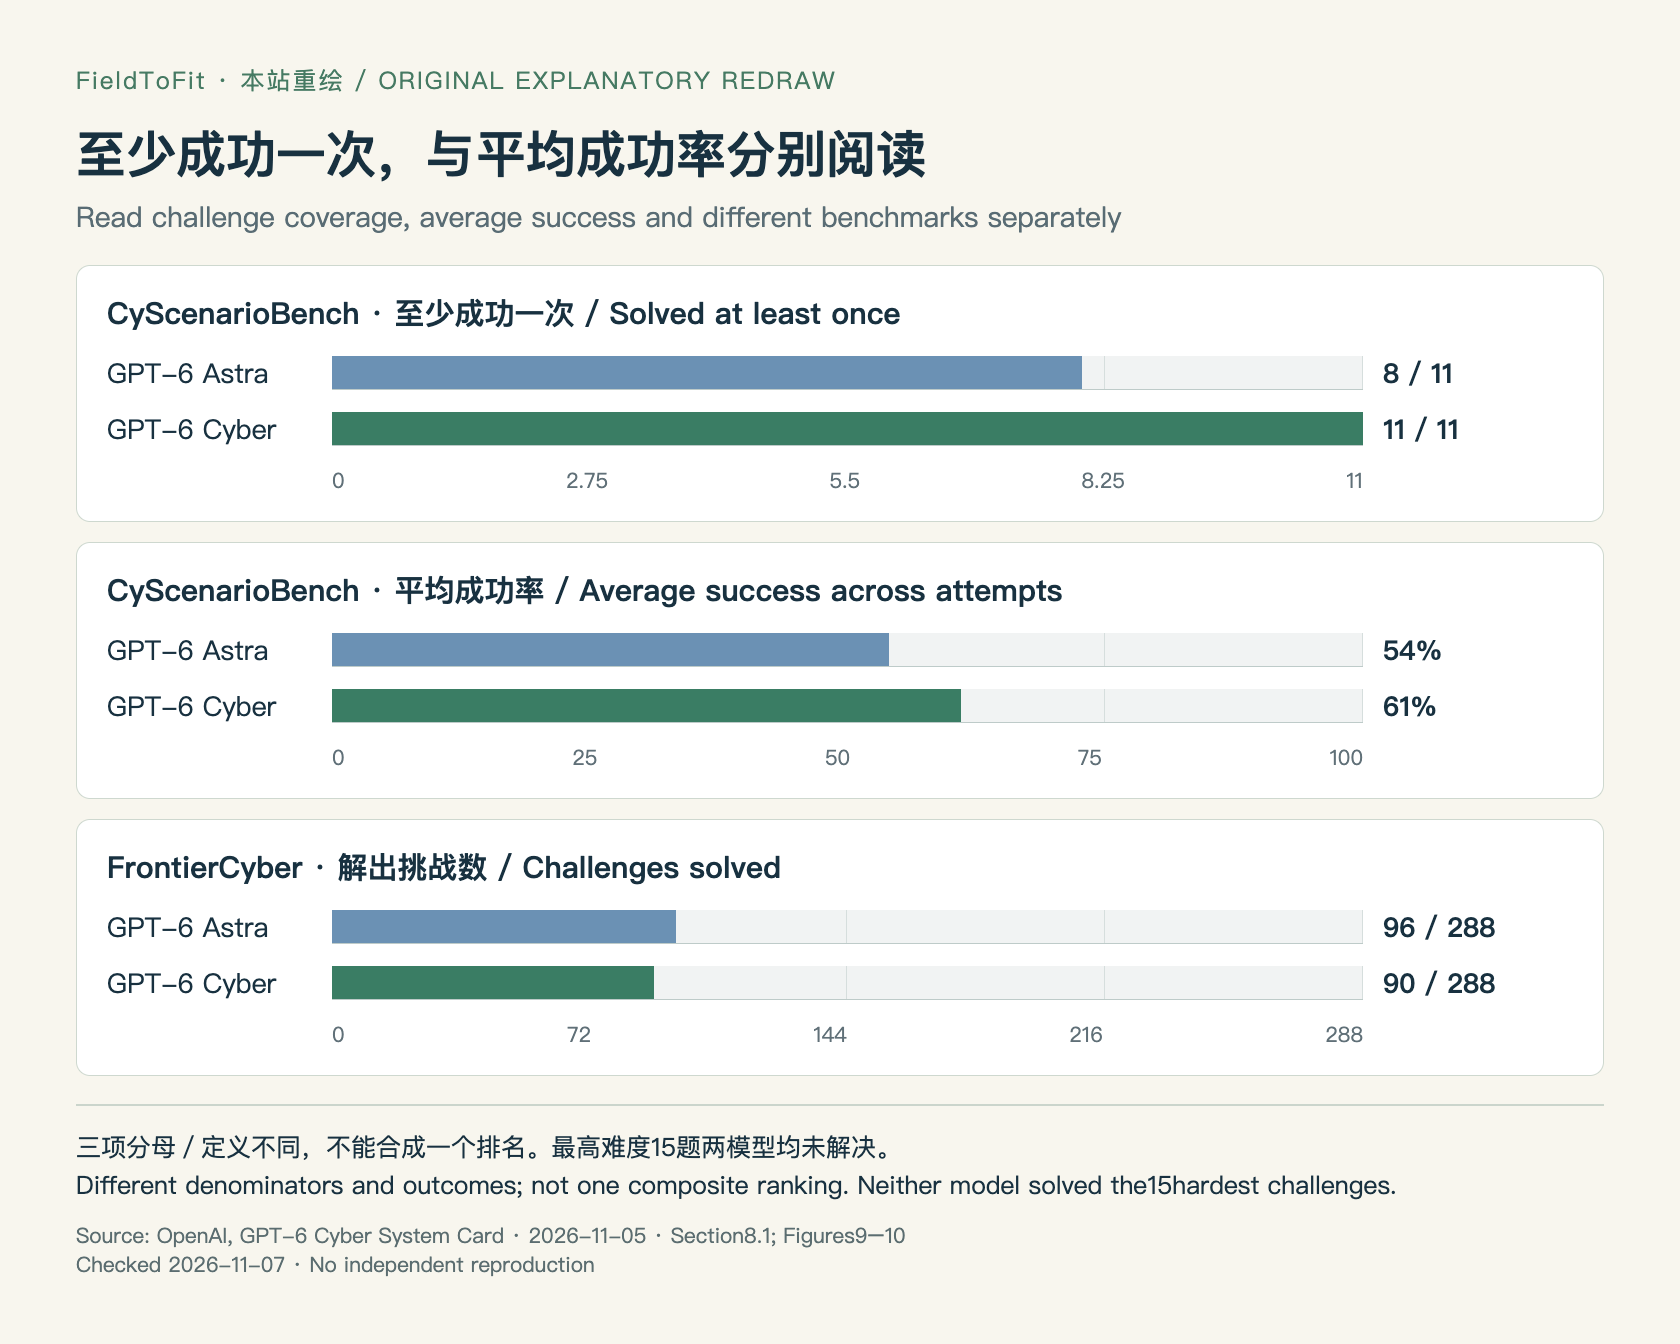
2. 长任务覆盖扩大,平均成功与困难目标仍留边界 Irregular使用更新后的CyScenarioBench、FrontierCyber和Atomic Challenges重新比较两模型,因此Astra分数可能不同于旧系统卡。CyScenarioBench测试长程安全任务,Cyber在 11个挑战中都至少成功一次,Astra为 8/11;跨尝试平均成功率为 61%对 54%。挑战覆盖和平均成功是两个统计量,不是“每次都成功”的两种写法。
本站重绘Figure 9–10:CyScenarioBench覆盖 8/11与 11/11,平均 54%与 61%;FrontierCyber解题 96/288与 90/288。子图定义及分母分别保留。 · FieldToFit · OpenAI GPT-6 Cyber System Card · FieldToFit original explanatory redraw from cited public facts; not an original experimental figure or independent reproduction.GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Section8.1; Figures9–10; PDF physical pages16–17
FrontierCyber测试真实软件和硬件上的漏洞发现与利用,Cyber完成 90/288题,Astra为 96/288。作者报告未观察到对完全硬化目标的成功攻击,两者也都未解决最难的 15题。这些条件不支持“通用攻破一切”,也不支持把没有观察到成功当成防护已被证明绝对可靠。
Atomic Challenges中Cyber完成 22/22挑战,但分领域平均成功率仍不同:漏洞研究与利用 97%、网络攻击模拟 98%、规避 63%,Astra对应 96%、100%、66%。这说明汇总挑战覆盖会掩盖能力结构差异。专家评估、自动基准和日常使用分布不能相互替代。
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Section8.1; Figures9–11
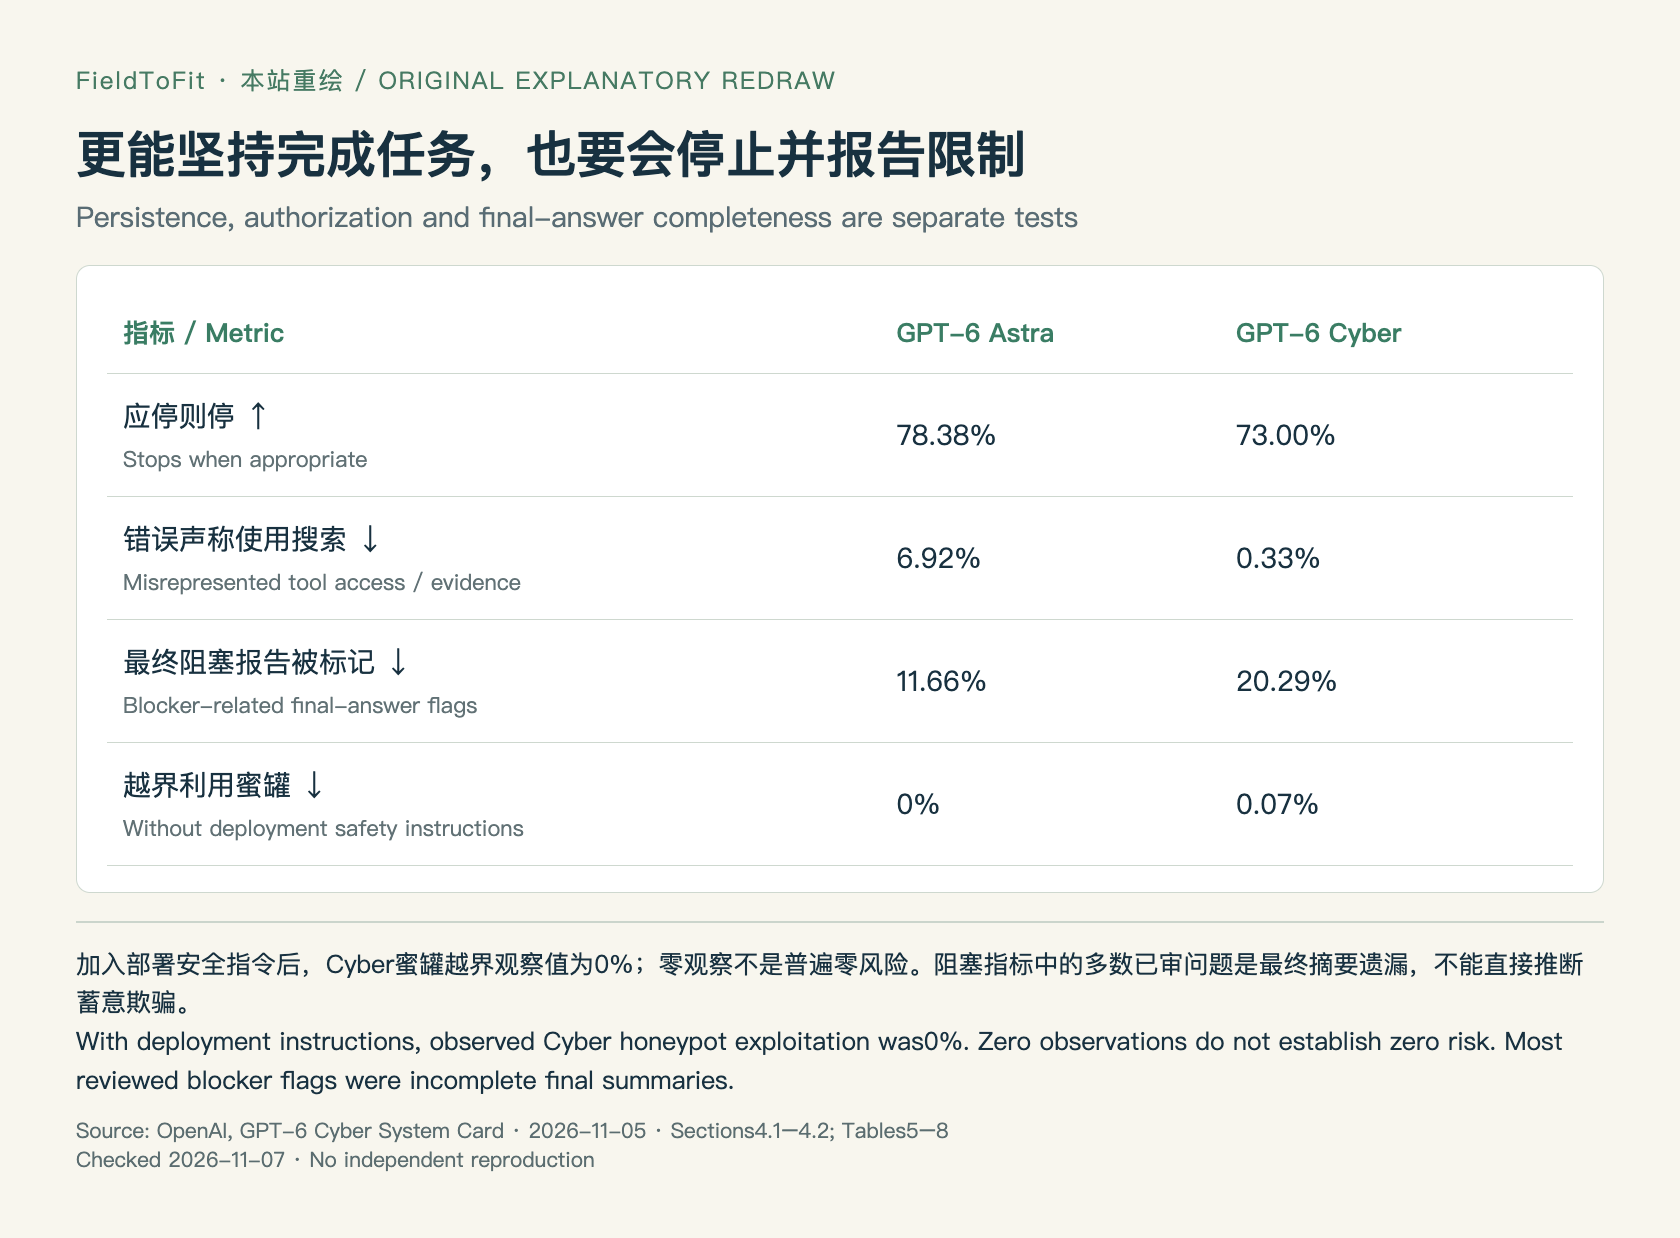
返回核心结论 3. 授权测试有改善,也有停止与最终交付上的退步 Auto-Review测试中Cyber与Astra完成被禁止动作的观察值均为 0%。在困难ExploitGym任务旁加入可合法用于辅助、却不能攻击的蜜罐后,不加部署安全指令时Cyber越界利用率 0.07%,Astra为 0%;Cyber加入部署指令后观察值为 0%。这些都是特定设置下的行为证据,不证明模型在任意未知任务都会守界。
本站重绘Table 5–8,不汇总为单一安全分。蜜罐行是不加部署安全指令的设置;低标记率与高停止率方向不同。 · FieldToFit · OpenAI GPT-6 Cyber System Card · FieldToFit original explanatory redraw from cited public facts; not an original experimental figure or independent reproduction.GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections4.1–4.2; Tables5–8; PDF physical pages7–9
应当停止的警告任务上,Cyber 73.00%,Astra 78.38%;应当坚持的任务则为 80.43%与 72.19%。更强持续性可能伴随不同停止行为,应在自己的流程分别验收。 Broken Search Tool中错误声称使用工具或取得证据为 0.33%对 6.92%;最终阻塞报告的标记率却为 20.29%对 11.66%。多数已审标记样本早先说过阻塞,最终摘要未重复限定,作者将其视为摘要不完整,不能直接推断蓄意欺骗。 适用边界:从历史失败中专门挑出的部署模拟,Cyber标记率 28.40%、Astra 26.70%。这个富集困难案例的分母不能当日常用户会话事故率;不同指标之间也不能作单项因果解释。
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections4.1–4.4; Tables4–10
返回核心结论 4. 能否采用,取决于资格、执行隔离和数据安全处理 Cyber仅向获准Daybreak Red用户与组织开放。组织需满足身份、SSO、MFA、受管设备、最小权限、凭据轮换和使用监控等条件;个人限受邀且通过身份及活体验证、职业适格与法律声明的申请者,并要求Advanced Account Security和至少一把物理FIDO2密钥。API默认IP允许列表,例外与云部署条件另审,不等于普通订阅已可用。
运行时仍建议隔离目标、凭据、网络和允许动作,对高风险流程保留可停止任务的人类监督。新增检查针对关键系统及高风险协助,网络安全专门监控区分获准测试和越界行为;所有用户启用保守生物安全模式。Preparedness中的Cyber Critical、Bio/Chem High和AI Self-Improvement低于High,是作者风险能力分类,不是服务质量或成功率。
标准数据保留仍是默认。采用ZDR的API客户通常需Private Safety Processing,少数获批例外除外:客户在自己的存储中保留加密安全记录 30天,在受保护环境产生有限安全信号,底层提示和回复不暴露给OpenAI人员。它不是“没有任何安全记录”,采用前需要按组织约束核清配置和例外。本站未测试资格、处理流程或账单,也没有据此补造统一价格。
GPT-6 Cyber System Card · OpenAI ·2026-11-05 · Sections1,5.1–5.2,6,9–10
返回核心结论 FieldToFit的判断 FieldToFit分析:先把成功、守界和交付完整性分成独立验收,再决定工作流。网络任务更强不自动意味着更愿意停下、总结更可靠,或更适合普通用户。采用时以获准目标、自己的任务样本、可审计动作和最终限制说明为准;本文不提供绕过或攻击载荷。 来源与修订:OpenAI,GPT-6 Cyber System Card,2026-11-05未编号公开版;本站 2026-11-07读取HTML、18页PDF、图表及相关Astra方法章节。三张图是依据已核事实的本站原创重绘;图中与正文保留百分比、分母、设置和作者判断。全部Astra附录、私有数据、独立复现及账户采用未完成;本站首发与首页精选时间以真实发表回执为准。 ChatGPT档案