Gemini 4 Argon:长任务成绩领先在哪,哪些比较并不等价?

主流模型的能力证据与评测可比性

Argon的知识工作与长上下文成绩值得关注,但选型仍须逐任务、逐配置理解;安全收益与残余风险分开。

作者与外部榜单数据混合;本站未复现实验,未完成 217 页安全报告深读。

本次变化:首次整理所选模型卡:四条结论、同号论述、三张本站重绘,保留月份日期与指标条件。

方法、实验与证据

多模态与上下文容量

机制
稀疏MoE,原生多模态输入;RL包含多步推理与问题求解数据。
条件/配置
文本、图像、音频、视频输入;文本输出;输入输出合计最多 1M token。
报告结果
GraphWalks BFS F1:短组 99.7%,长组 84.2%。
局限
容量不是无限记忆;两组样本不同,不能把差值当同一任务随长度下降的因果。

GraphWalks BFS F1:84.2 % · 比较基线 Gemini 4 Argon up to 128K: 99.7% · 200 problems, 256K to 1M; other subset 650 items

Gemini 4 Argon Model Card · October 2026 · Card pp2–3,6; methods p3

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

把运行框架与预算读进成绩

机制
多数pass@1 且最高thinking;小集多次试验均值,具体例外另列。
条件/配置
PostTrainBench同一OpenCode、单H100、10 小时;OSWorld离线子集部分分、3 次取最大。
报告结果
配置、子集、取样与供应商自报共同限定比较。
局限
不是所有模型、所有行均由Google同条件重测;视觉帧数也不同。

Gemini 4 Argon Model Card · October 2026 · Card p5; methods pp2–4

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

分任务强项与落后项并存

机制
知识工作、代码、终端与机器学习工程分别计分。
条件/配置
模型卡 2026 年 10 月矩阵;按行保留外部榜单与内部复测口径。
报告结果
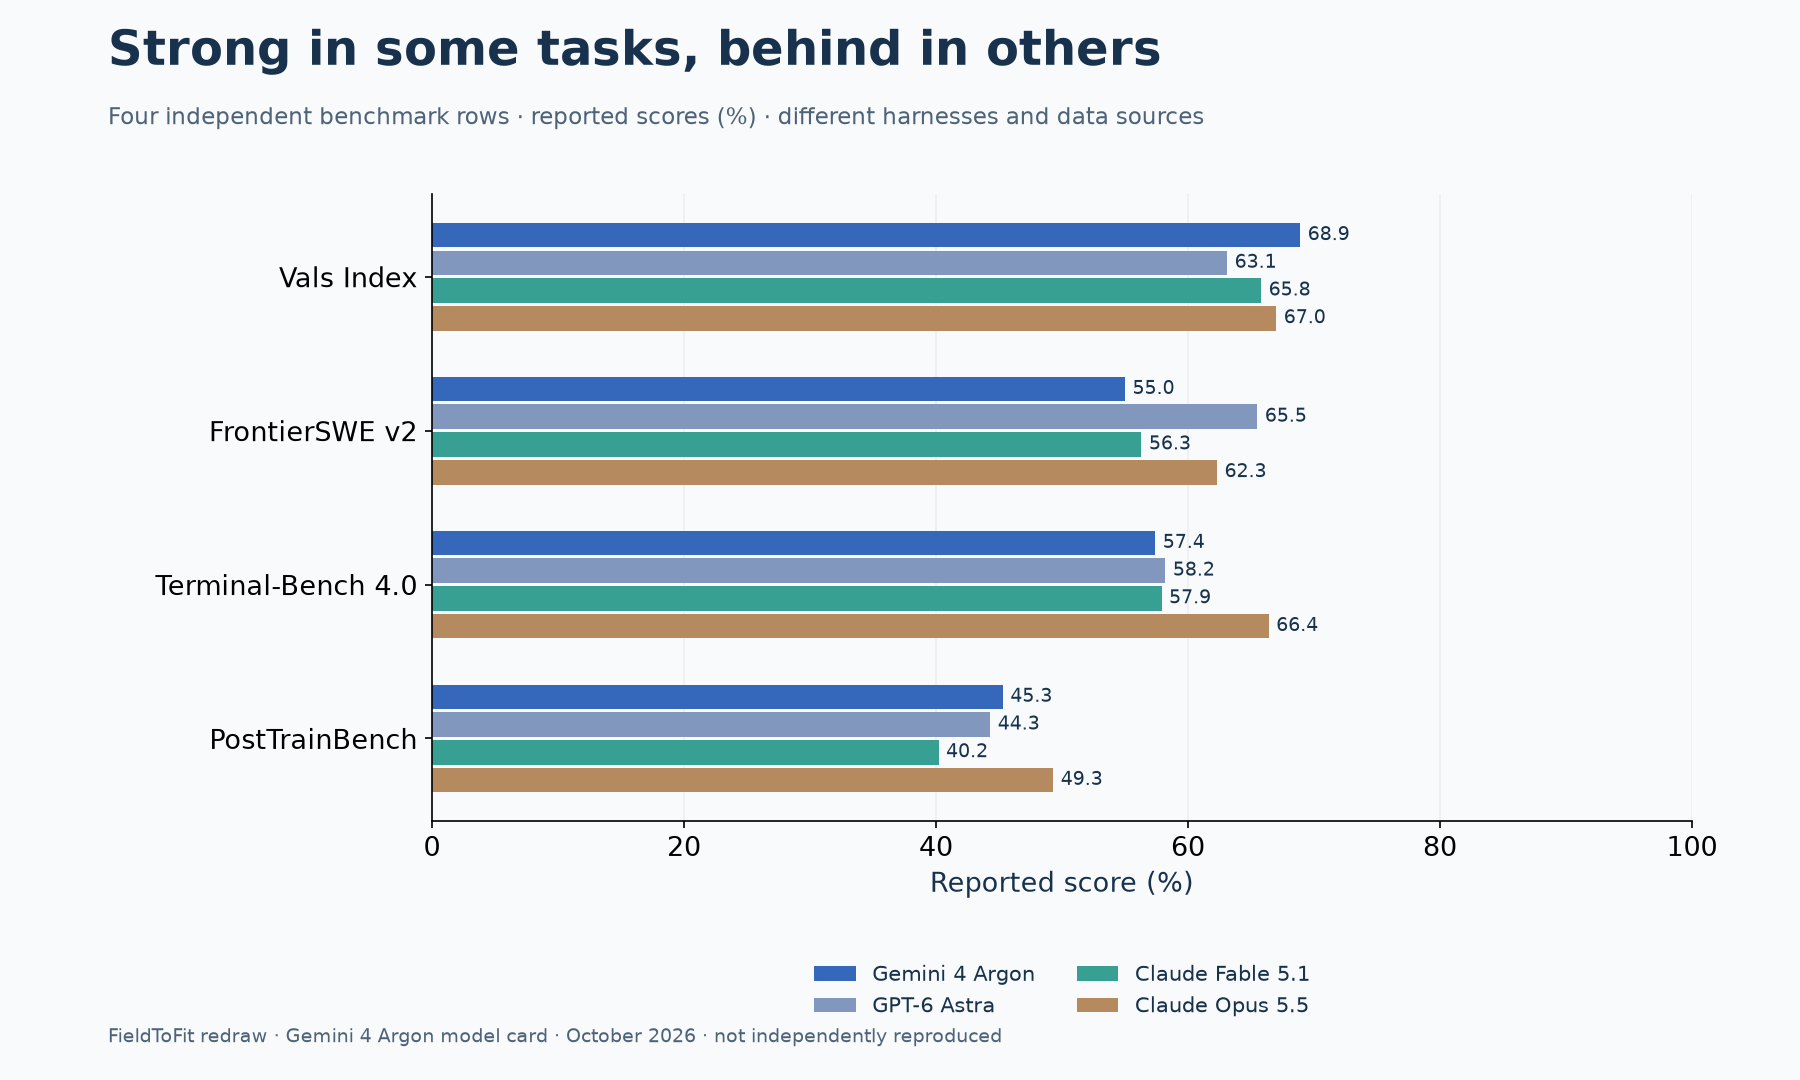
Vals 68.9%,FrontierSWE 55.0%,Terminal-Bench 57.4%,PostTrainBench 45.3%。
局限
不平均不同基准,不从一行领先推出全任务领先。

Vals Index:68.9 % · 比较基线 GPT-6 Astra 63.1%; Fable 5.1 65.8%; Opus 5.5 67.0% · Official matrix row; results sourced from Vals AI

Gemini 4 Argon Model Card · October 2026 · Card p6; methods pp2–3

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

Gemini 3.1 Pro安全对照

机制
同一组内部自动安全评测中的比较基线。
条件/配置
绝对百分点变化;每项更好方向分别定义。
报告结果
表内只报告差值,并未给所有绝对发生率。
局限
改进过的评测不与旧模型卡直接拼表。

Gemini 4 Argon Model Card · October 2026 · Card pp9–10

安全收益与残余风险分别读

机制
内容安全、拒绝行为和前沿能力风险采用不同评估。
条件/配置
对照Gemini 3.1 Pro;内部自动评测及FSF阈值判断。
报告结果
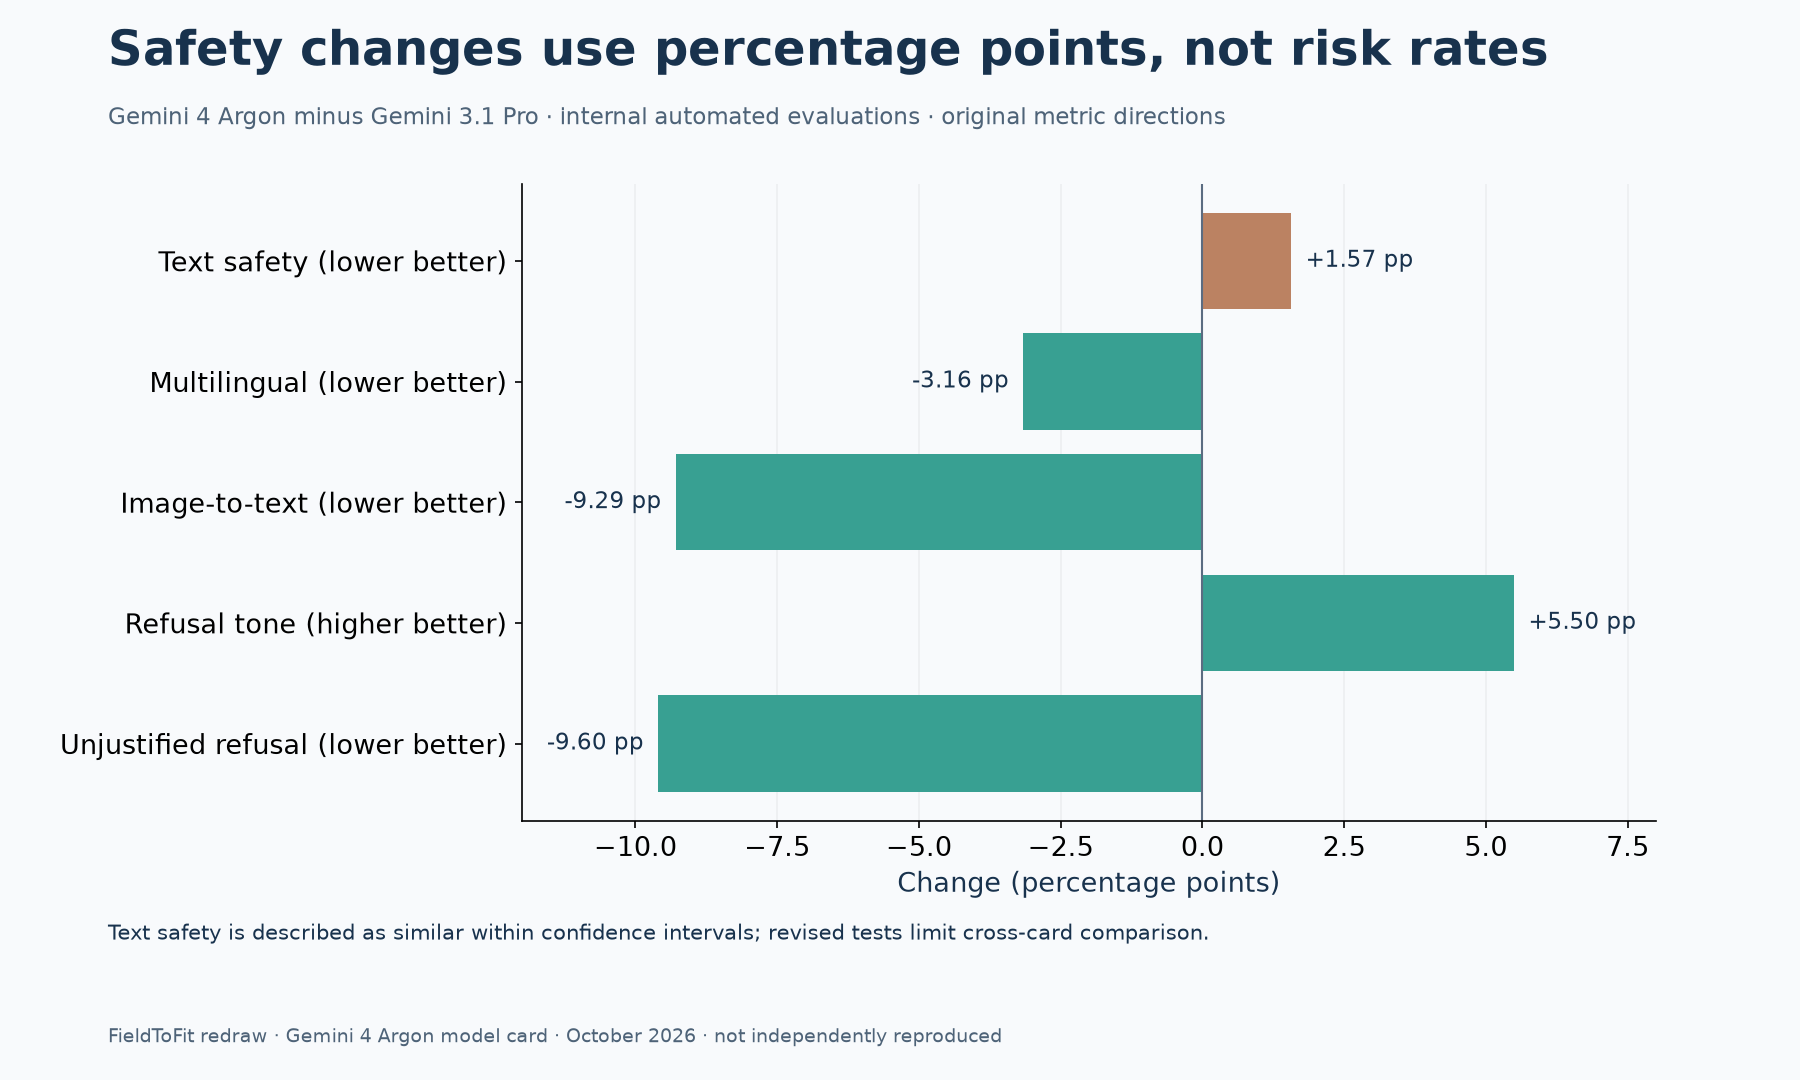
文本安全+1.57pp,多语-3.16pp,图像到文本-9.29pp;拒绝语气+5.50pp,过度拒绝-9.60pp。
局限
作者称文本安全在置信区间内相近;生物/网络CCL及隐蔽/情境意识TCL不能排除,不是零风险证明。

Gemini 4 Argon Model Card · October 2026 · Card pp9–14

关系与依据

context → tasks

并行探索:同一模型的上下文与分任务证据并列,非因果证明

Card pp2–6

tasks → safety

并行探索:能力成绩与安全判断分别评估

Card pp5,8–11

四条核心结论

  1. 1M窗口是容量,长任务仍需检验是否完整交付

    GraphWalks长组 84.2%与短组 99.7%来自不同样本,不是无限记忆或长度退化的统一概率。

  2. 知识工作强项不能替代每项任务的独立比较

    Vals领先,但FrontierSWE、Terminal-Bench和PostTrainBench有更高的对照模型;不要制作伪统一排行榜。

  3. 框架、预算和取分方式会改变“更强”的含义

    多数pass@1 并不覆盖所有行;OSWorld的部分分与 3 次最大值、不同视觉帧数都需明示。

  4. 安全表有改善也有例外,残余风险需另读

    百分点差值不是事故概率;内容安全评测与前沿风险阈值不是同一套分数。

1. 1M窗口是容量,长任务仍需检验是否完整交付

模型卡明确Argon不是旧模型的微调版本,而是新的稀疏MoE模型。多模态输入和多步推理训练使它可以覆盖较复杂工作流;但公开卡没有给参数总量、训练数据各类占比或完整训练预算,不能补出机制细节。

  1. 容量:输入与输出合计最多 1M token;不是输入 1M再额外输出 1M。
  2. 测试:最多 128K组 650 题;256K至 1M组 200 题,BFS F1 分别 99.7%/84.2%。两组题不同,不能由 15.5 个百分点差值推算同一任务的失败增加。
  3. 产品:模型卡仍列幻觉、延迟/超时与 2026 年 3 月知识截止。检索、引用核对和任务终态验证仍有价值。
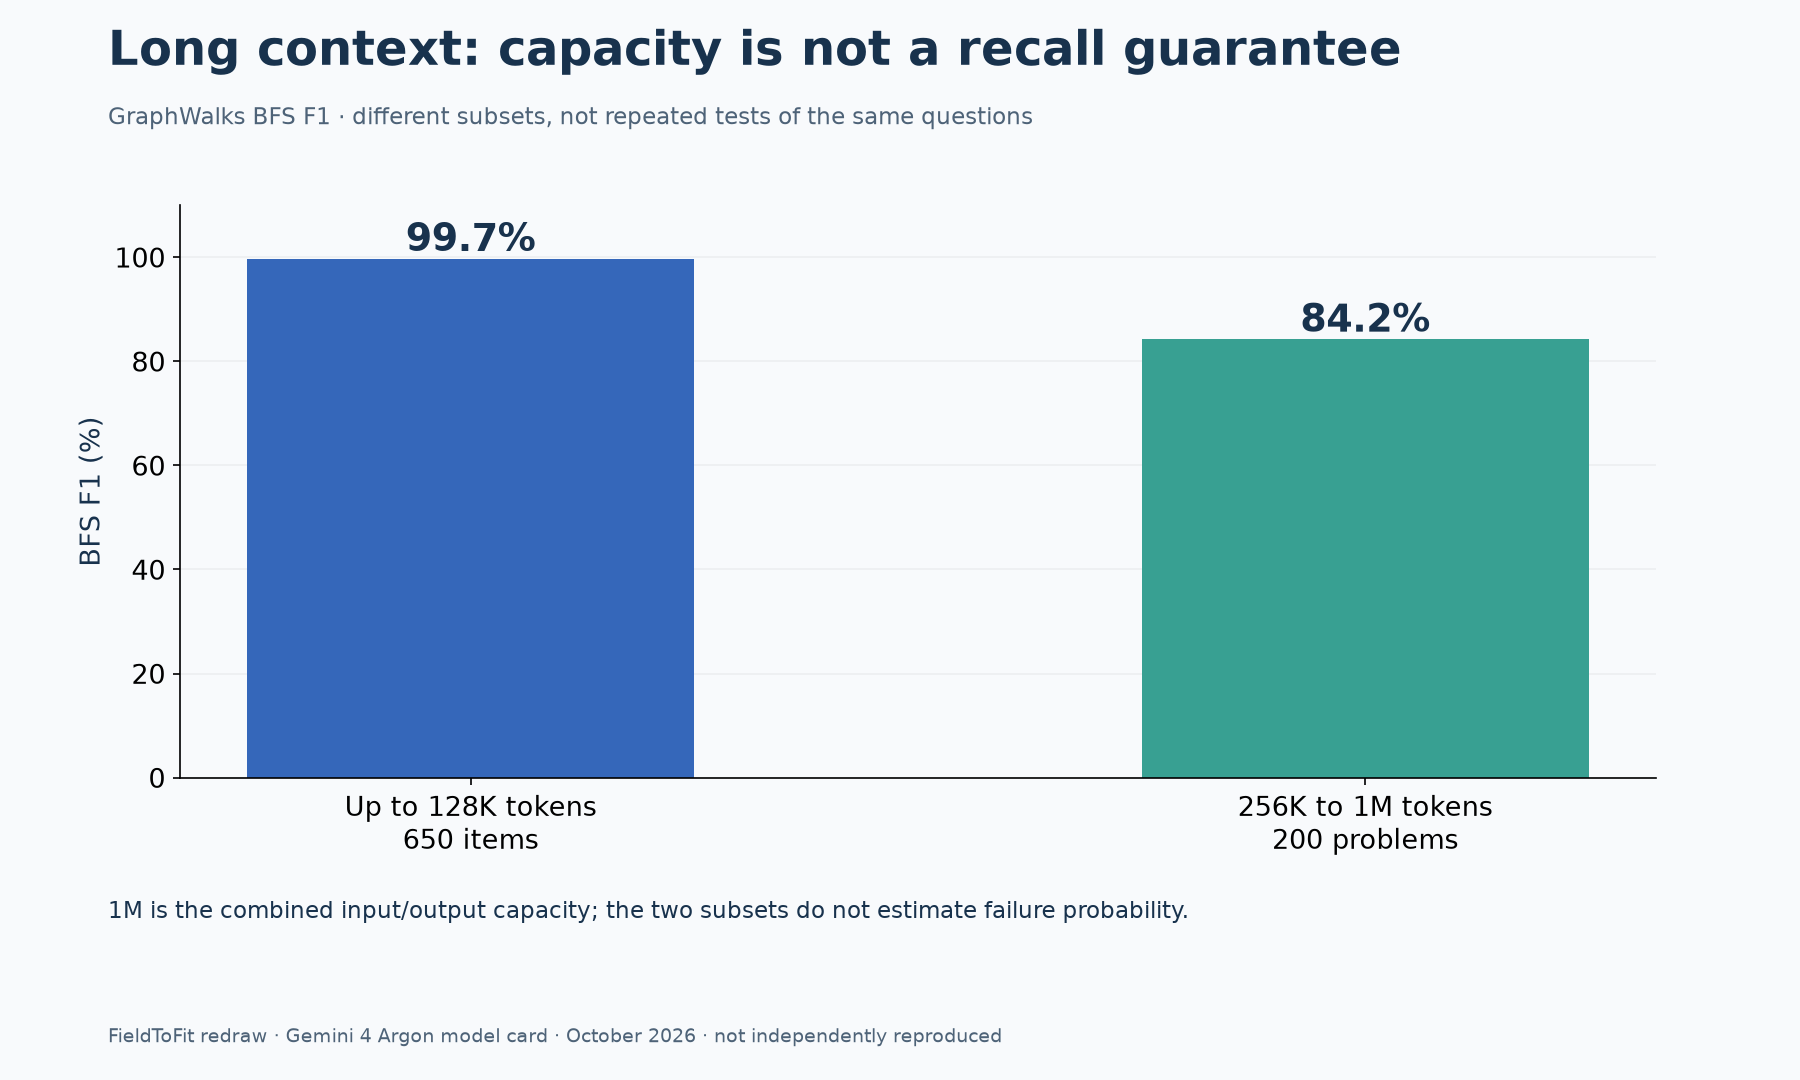
两个GraphWalks子集的BFS F1 为 99.7%和 84.2%,样本分别 650 与 200。
本站重绘:不同子集使用同一指标,但不是同题重复实验,也不是记忆成功概率。 · FieldToFit本站重绘;公开数据来自Google DeepMind的 2026 年 10 月模型卡。 · Graphics © FieldToFit; original data: Google DeepMind model card.

Gemini 4 Argon Model Card · October 2026 · Physical p6 / printed p5

适用边界:长上下文提高可放入的信息量,不自动证明模型能正确使用每条信息或交付无人监督任务。

Gemini 4 Argon Model Card · October 2026 · Card pp2–3,6–7; methods p3

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

返回核心结论
2. 知识工作强项不能替代每项任务的独立比较

第 6 页矩阵的价值是把不同工作类型展开。知识工作和工程任务没有同一个分母;即便单位都写百分比,也不能平均成通用Agent成功率。

  1. Vals Index:Argon 68.9%,GPT-6 Astra 63.1%,Fable 5.1 65.8%,Opus 5.5 67.0%;本行可描述为表内领先。
  2. FrontierSWE v2:Argon 55.0%,Astra 65.5%;Terminal-Bench 4.0:Argon 57.4%,Opus 5.5 为 66.4%;本行不能写Argon全面领先。
  3. PostTrainBench:Argon 45.3%,Opus 5.5 为 49.3%。共享硬件和框架改善可比性,但仍只是四个基础模型与七个基准的加权结果。
四个基准分别展示四个模型分数,Argon并非每行最高。
本站重绘:每行独立比较,横轴 0–100%。不跨行相加;对照数据来源和运行设置见正文。 · FieldToFit本站重绘;公开数据来自Google DeepMind的 2026 年 10 月模型卡。 · Graphics © FieldToFit; original data: Google DeepMind model card.

Gemini 4 Argon Model Card · October 2026 · Physical p6 / printed p5

关键证据:选型应从自己的任务类型出发,先判断结果对应的工作流与评分是否接近实际业务。

Gemini 4 Argon Model Card · October 2026 · Card p6; methods pp2–3

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

返回核心结论

3. 框架、预算和取分方式会改变“更强”的含义

方法文档默认最高thinking、单次尝试,且小基准平均多次试验以降低波动。其他厂商通常引用自报结果,能取得时用最大推理设置,否则用最佳可得结果;这不是一场统一实验。

  1. PostTrainBench v1.1:全部模型由Google复测,OpenCode、单NVIDIA H100、10 小时预算;数据与权重范围必须一起写。
  2. OSWorld 2.0:离线子集部分分,3 次运行取最大,每次单次尝试;默认 1080p、最多 500 步,Gemini CUA框架与并行批量工具调用。69.2%不能直接称完整任务成功率。
  3. 视频理解LVBench:Gemini用 1FPS,Astra 800 帧、Fable 5.1 为 300 帧、Opus 5.5 为 600 帧,受到API限制。Terminal-Bench Science还有 6 倍验证器超时安排。

适用边界:框架和样本不同不让结果失去价值,但限制了它能回答的问题;不能由分数反推真实用户的时间、费用或事故率。

Gemini 4 Argon Model Card · October 2026 · Card pp5–6; methods pp2–4

Model evaluation: Approach, methodology & results · Gemini 4 Argon · Model evaluation: Approach, methodology & results; physical pp2–4

返回核心结论

4. 安全表有改善也有例外,残余风险需另读

安全差值对照Gemini 3.1 Pro。多语、图像到文本、拒绝语气与过度拒绝总体改善;文本安全原始差值+1.57pp,在“越低越好”的方向上增加,但作者称置信区间内相近。不能只保留绿色数字。

安全差值:+1.57、-3.16、-9.29、+5.50、-9.60 个百分点,改善方向逐项不同。
本站重绘:保留原始符号和指标方向。未给绝对基线,不能换算事故率或相对降幅。 · FieldToFit本站重绘;公开数据来自Google DeepMind的 2026 年 10 月模型卡。 · Graphics © FieldToFit; original data: Google DeepMind model card.

Gemini 4 Argon Model Card · October 2026 · Physical p10 / printed p9

  1. Google说明评测与查询集已改进,旧模型卡数字不能直接拼接比较;人工复核发现的损失多为误报或非严重问题,这是作者解释,不是本站验证。
  2. 前沿风险:生物与网络CCL不能排除;隐蔽/情境意识TCL不能排除。Google据此部署缓解并评估残余风险,而不是宣布模型无风险。
  3. 本篇读完 14 页模型卡,不等于已完成 217 页安全报告和安全案例论证。模型、工具权限、监控与人工批准需要一起考虑。

适用边界:作者评测及缓解声明不等于独立安全认证,更不能把测试阈值转换为生产事故概率。

Gemini 4 Argon Model Card · October 2026 · Card pp9–14

返回核心结论

报告与日期

Gemini 4 Argon Model Card · October 2026 · October 2026 model card · 首次发布 2026-10 · 原卡只标 2026 年 10 月;首发日和独立修订号未核实。开放公告 10 月 13 日不替代报告首发日。

地图首次发布 2026-10-14T03:18:58.759207+00:00 · 地图修订 2026-10-14T04:00:31.149194+00:00

Gemini档案