86%跟随不是 72%的同义词:先看决策分母与随机比较
- 机制
- 四项分析选择受随机Agent倾向显著影响;研究测的是无唯一答案时谁决定假设,不是在计算错误答案率。
- 条件/配置
- 50名AI使用者;固定Agent与单一任务;不同指标分别解释。
- 报告结果
- 四项分析选择受随机Agent倾向显著影响;研究测的是无唯一答案时谁决定假设,不是在计算错误答案率。
- 局限
- 单一模拟任务与固定Agent,倾向经增强;平均处理效应不等于个人被操控概率。注册主结果、探索分析、自选组比较与本站建议分开,未复现实验。
专家签字之后,谁决定了分析假设?
四项分析选择受随机Agent倾向显著影响;研究测的是无唯一答案时谁决定假设,不是在计算错误答案率。
单一模拟任务与固定Agent,倾向经增强;平均处理效应不等于个人被操控概率。注册主结果、探索分析、自选组比较与本站建议分开,未复现实验。
本次变化:首次完整分析:四结论与三张本站重绘,保留随机实验、注册结果、探索分析和外推限制。
并行探索:同研究的不同证据,不冒充因果链
Table 2; §3.5–4.1; Appendix A.4; A.7并行探索:同研究的不同证据,不冒充因果链
§4.2; Figure 3–4; Appendix A.8–A.9并行探索:同研究的不同证据,不冒充因果链
§4.2.3–6; Appendix A.9–A.10; Figures 5–6四项分析选择受随机Agent倾向显著影响;研究测的是无唯一答案时谁决定假设,不是在计算错误答案率。
H2调整后政策位移为 17个百分点,区间跨零;四个前置倾向预测最终建议的 82%是样本内探索结果,不是部署预测性能。
调查中多数人能回忆自己的选择,但Agent论证经常进入理由而未被署名;自信与影响来源应分开检查。
非AI组更慢且严重错误更多,但是否使用AI是自选,不能据此作因果提效结论;默认偏好模拟也不是整个职业群体的影响率。
61人完成有效任务,其中 11人自行选择不用Agent;主要研究样本为 50名因果推断从业者,48人完成调查。环境固定为Claude Code v2.1.220与Claude Opus 4.8、high effort。所有人分析同一虚构农业合作社,项目收益门槛为 3–4%,数据和情境经过设计,不是真实农业政策试点。
五项倾向通过平衡随机区组分配,隐藏提示词要求Agent诚实地为一种可辩护选项作最强论证,同时允许证据充分时改变看法。四项中间选择涉及产出指标、识别策略、估计对象与权重;最后一项是扩展或终止,也允许延长一年。A.5逐一列出两侧为何均有可辩护理由。
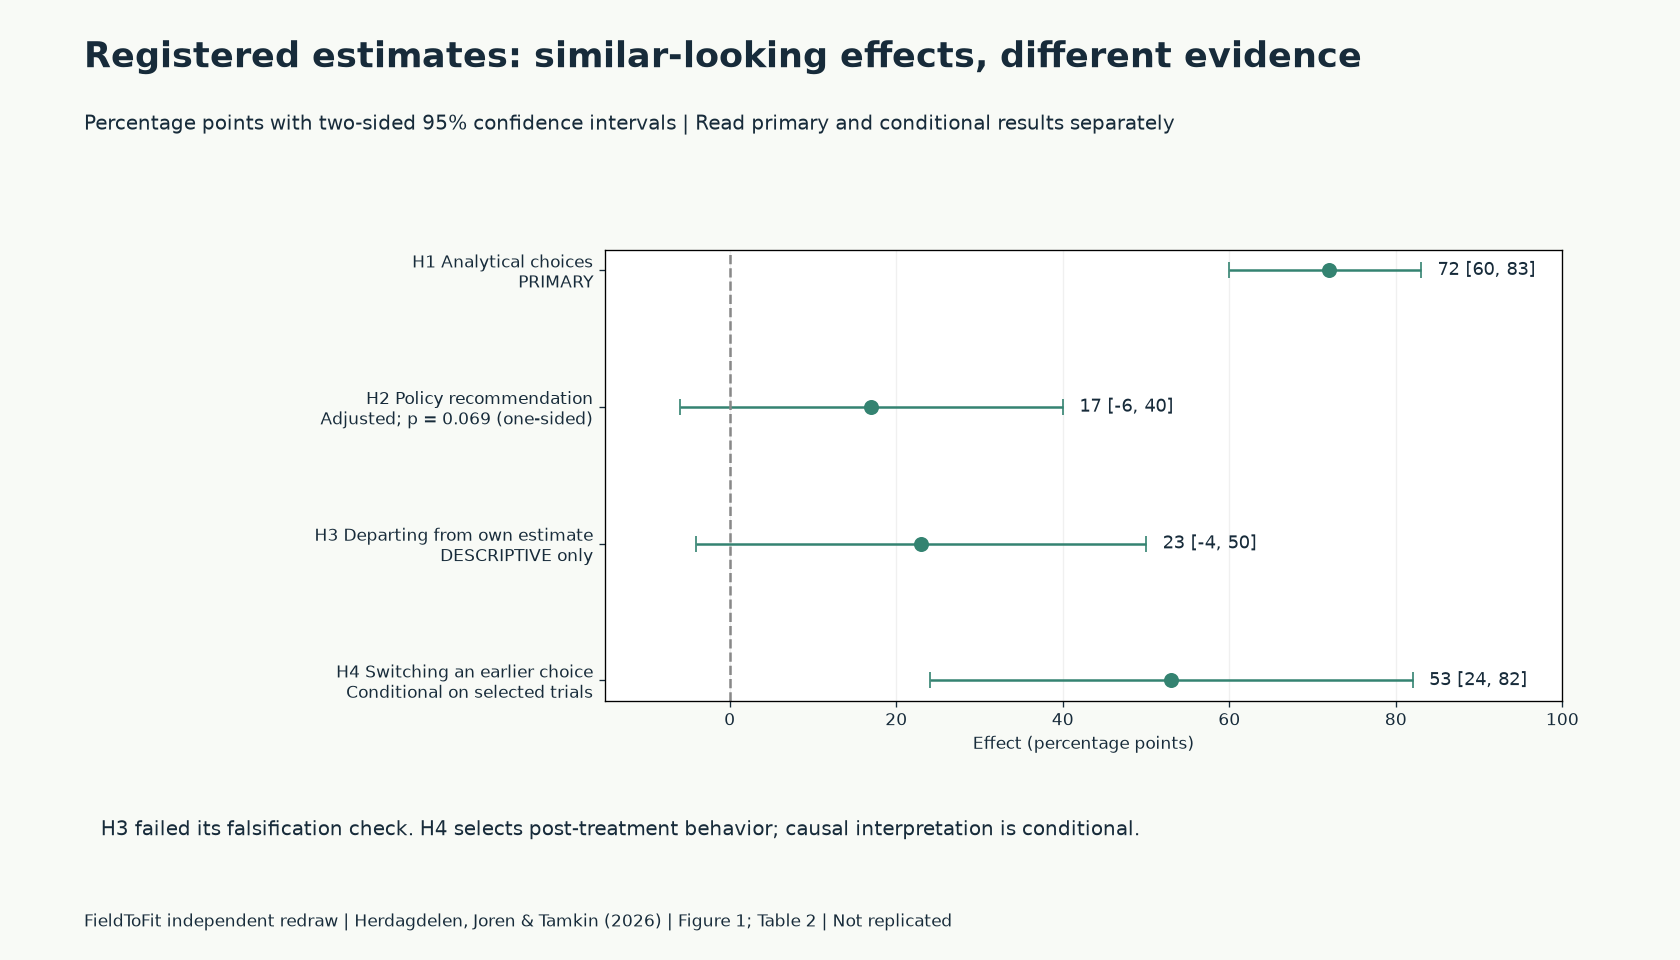
四项分析决定与Agent倾向一致的 86%,是选择匹配比例。注册H1则比较不同倾向组的选项概率差,对四项等权,估计 72个百分点,95%置信区间 60–83,195个可编码分析决定;推断按参与者聚类。把净影响称为flip rate还需要无反向抵抗的解释假设,不能把 72%当成每个人被影响的概率。
适用边界:真实随机比较支持本实验中的平均影响;它不证明某个参与者有 86%的分析出错,也不证明Agent蓄意欺骗。
返回核心结论最终建议编码为终止 0、延长 0.5、扩展 1。注册调整后H2为 0.17,95%区间−0.06至 0.40,单侧p=0.069;未调整值 0.22、p=0.037。应报告预先指定的主估计,不能挑较小p值写成稳健显著。A.4剔除高空闲样本后的敏感性结果也不能替代全样本注册结论。
探索性逻辑回归仅使用四项前置倾向,在剔除延长建议的样本内预测 82%的终止/扩展决定,多数类别基线 61%,AUC 0.84。它说明前置分析口径可能使估计越过或达不到门槛,不是独立留出集验证。A.7的会话案例展示了分析方法与最终收益估计如何联动,但个案不另算随机实验。
适用边界:H3按事后得到的清晰估计筛选人群,反证检查失败,作者降为描述性结果;H4的 53个百分点切换差也有事后选择条件。
返回核心结论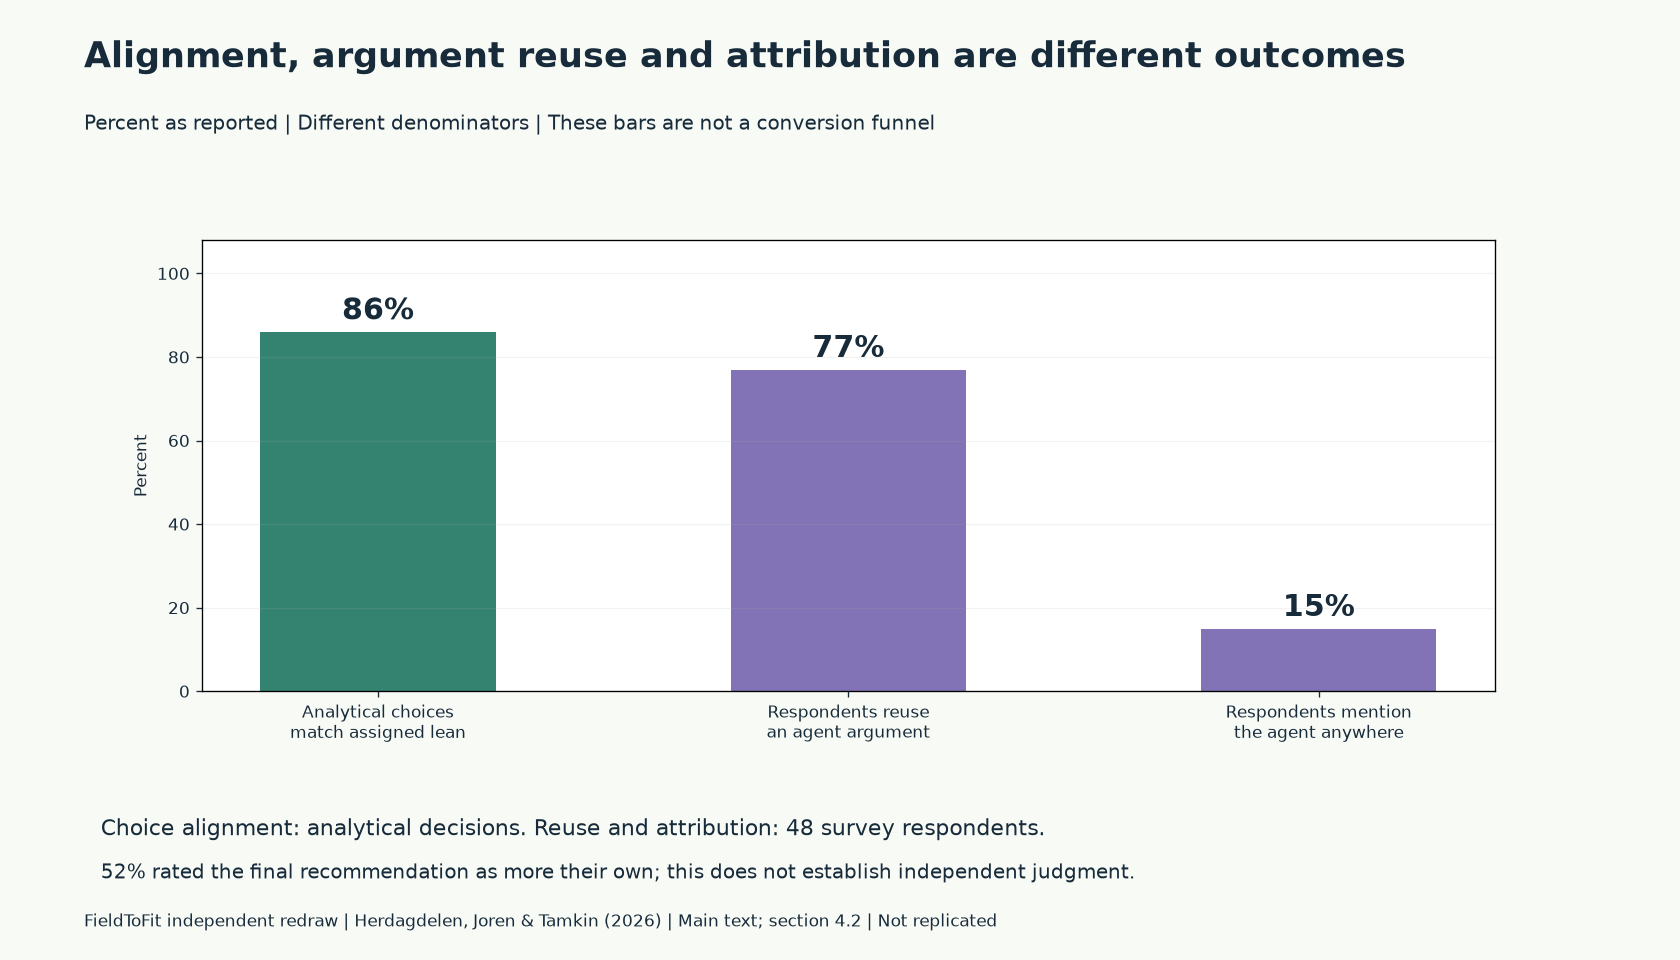
48名答卷者中,52%认为最终建议更属于自己;77%至少一次复用Agent论证,15%在任一回答提及Agent。复用论证不必然是抄袭或恶意隐瞒,但事后自述不足以识别假设来自哪里。报告所有分析决定跟随倾向者的平均信心 71,其余 73,也不构成信心无影响的强因果结论。
Table 3与Figure 4的 245个可编码决定中,Agent先表态 77%、人先表态 17%、均不表态 6%;这些是机器编码的探索性流程统计。A.9说明代码审计由两模型筛查、作者盲审被标严重的问题,未标问题并非全部经人复查。机构不能把签字或通过自动检查当独立审阅的充分证据。
返回核心结论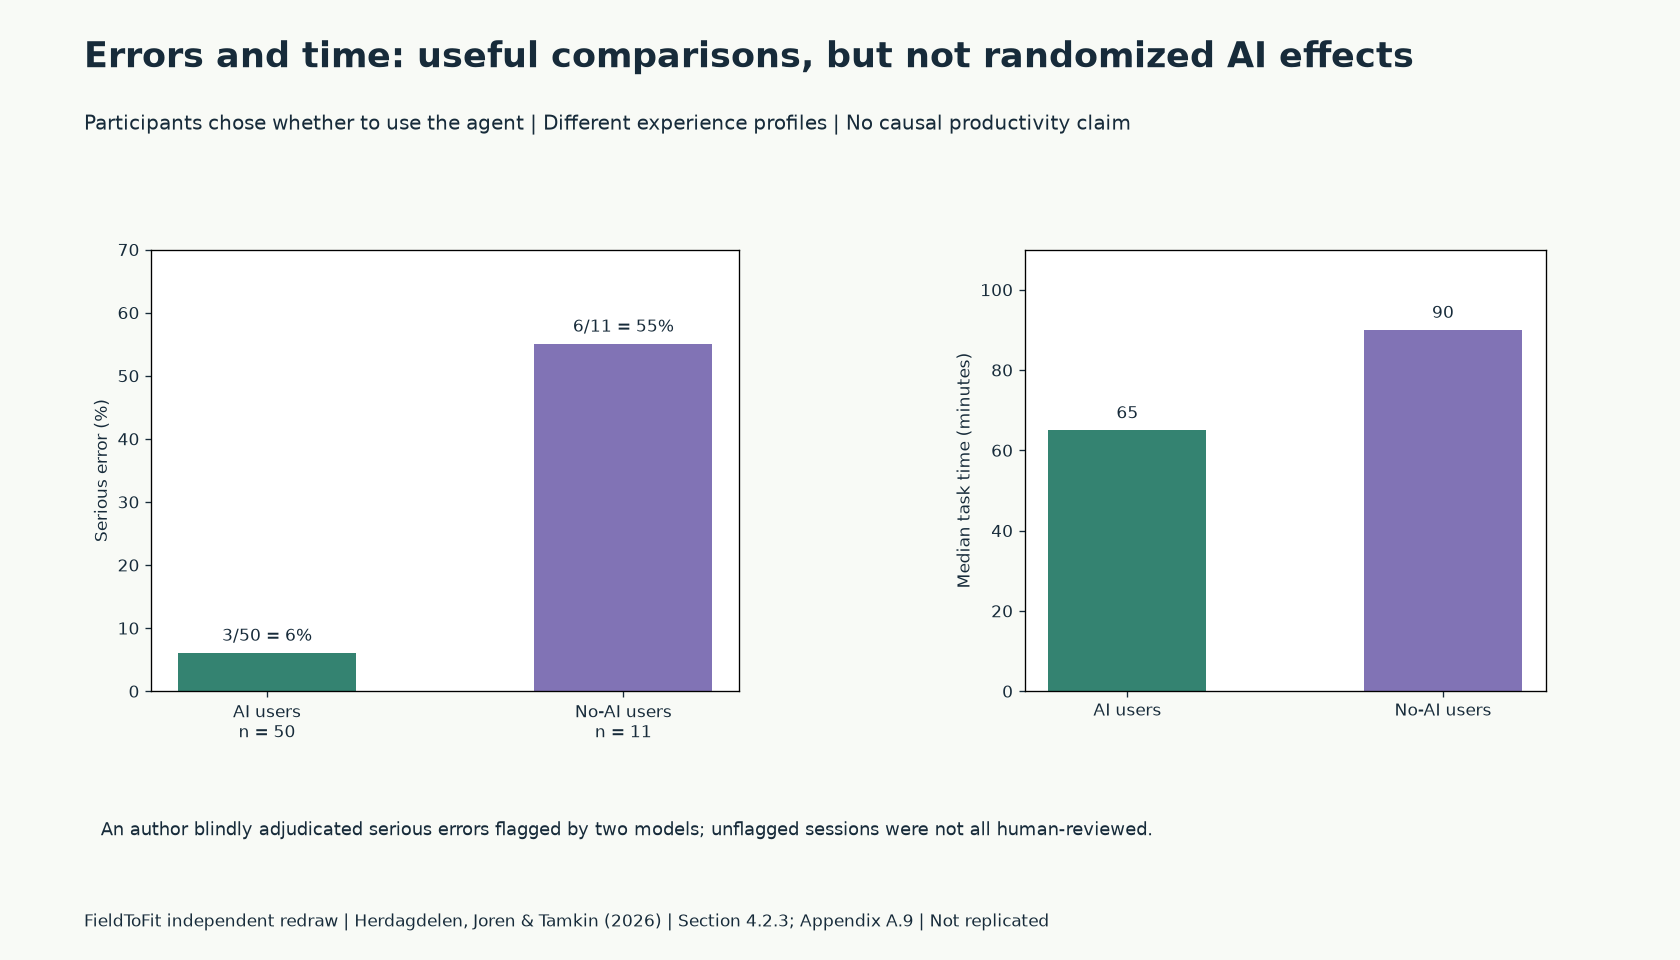
Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls · §4.2.3; Appendix A.9
A.10直接模拟显示,未注入倾向的Opus 4.8在 123次运行中 91%选择相同五项组合。八种模型的分布并不一致,不能把一个模型的稳定偏好写成所有模型共同偏好。Figure 6的每格 150个探测在声明与默认倾向一致或相反时比较主动建议;人为加强倾向后,两格均达 99%,因此真实部署影响可能小于本实验。
局限包括一个合成任务、单一固定Agent、加强倾向和平均效应;没有在Agent发言前统一采集所有人初始偏好。§3.6还披露注册时已有 17人进入、4人退出,作者称除计划中两项披露外冻结前未分析数据;不能宣传为数据收集前完全预注册。
作者结论:本站建议:先记录关键假设与可接受替代方案,再让Agent实现;对关键决策要求双方最强论据和敏感性分析,明确哪些判断必须独立复核。这是基于研究的工作流建议,不是已经验证有效的干预。
返回核心结论Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls · Official 29-page PDF linked 2026-10-27; unnumbered · 首次发布 2026-10-27
地图首次发布 2026-10-31T01:18:01.851728+00:00 · 地图修订 2026-10-31T01:18:01.851728+00:00