多模态检索缩小之后,哪些能力保住了?

多模态检索缩小之后,哪些能力保住了?

统一空间允许按任务加载编码器,不能把总参数、启用参数和向量维度混为一谈。

这是单向量嵌入模型,不是生成式聊天模型。榜单来自不同实现,消融用中间配方,量化部分更换评测环境;参数、维度和设备内存分别解释。未下载大权重或复现实验。

本次变化:首次完整分析:四结论、三张本站重绘,保留模块、训练和评测边界。

方法、实验与证据

1|744M是完整配置,文本检索实际走 271M路径

机制
统一空间允许按任务加载编码器,不能把总参数、启用参数和向量维度混为一谈。
条件/配置
单向量嵌入;原文各任务与配置分别比较。
报告结果
统一空间允许按任务加载编码器,不能把总参数、启用参数和向量维度混为一谈。
局限
这是单向量嵌入模型,不是生成式聊天模型。榜单来自不同实现,消融用中间配方,量化部分更换评测环境;参数、维度和设备内存分别解释。未下载大权重或复现实验。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §1–2.2; Figure 1

2|先蒸馏再对比学习,增益不能只解释为训练更久

机制
模块简化、分阶段目标与编码器训练共同作用,消融只能在其对应配方内比较。
条件/配置
单向量嵌入;原文各任务与配置分别比较。
报告结果
模块简化、分阶段目标与编码器训练共同作用,消融只能在其对应配方内比较。
局限
这是单向量嵌入模型,不是生成式聊天模型。榜单来自不同实现,消融用中间配方,量化部分更换评测环境;参数、维度和设备内存分别解释。未下载大权重或复现实验。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §2.3–3.3; Tables 2–4; Appendix A

3|代码和原生声音有进步,英文与部分任务仍有回退

机制
比较保留任务分母、聚合方式、实际启用参数与基线来源,不把效率前沿写成所有任务第一。
条件/配置
单向量嵌入;原文各任务与配置分别比较。
报告结果
比较保留任务分母、聚合方式、实际启用参数与基线来源,不把效率前沿写成所有任务第一。
局限
这是单向量嵌入模型,不是生成式聊天模型。榜单来自不同实现,消融用中间配方,量化部分更换评测环境;参数、维度和设备内存分别解释。未下载大权重或复现实验。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §4.1–4.4; Tables 6–11; Appendices B–C

4|缩维、量化和视觉预算,是三组不同的取舍

机制
少占向量空间不等于整个系统等比例变便宜,更大的视觉预算也不总是更好。
条件/配置
单向量嵌入;原文各任务与配置分别比较。
报告结果
少占向量空间不等于整个系统等比例变便宜,更大的视觉预算也不总是更好。
局限
这是单向量嵌入模型,不是生成式聊天模型。榜单来自不同实现,消融用中间配方,量化部分更换评测环境;参数、维度和设备内存分别解释。未下载大权重或复现实验。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §2.4, 3.4; Tables 1, 5, 8; Appendix C

关系与依据

多模态检索缩小之后,哪些能力保住了?

  1. 1|744M是完整配置,文本检索实际走 271M路径

    统一空间允许按任务加载编码器,不能把总参数、启用参数和向量维度混为一谈。

  2. 2|先蒸馏再对比学习,增益不能只解释为训练更久

    模块简化、分阶段目标与编码器训练共同作用,消融只能在其对应配方内比较。

  3. 3|代码和原生声音有进步,英文与部分任务仍有回退

    比较保留任务分母、聚合方式、实际启用参数与基线来源,不把效率前沿写成所有任务第一。

  4. 4|缩维、量化和视觉预算,是三组不同的取舍

    少占向量空间不等于整个系统等比例变便宜,更大的视觉预算也不总是更好。

1. 1|744M是完整配置,文本检索实际走 271M路径

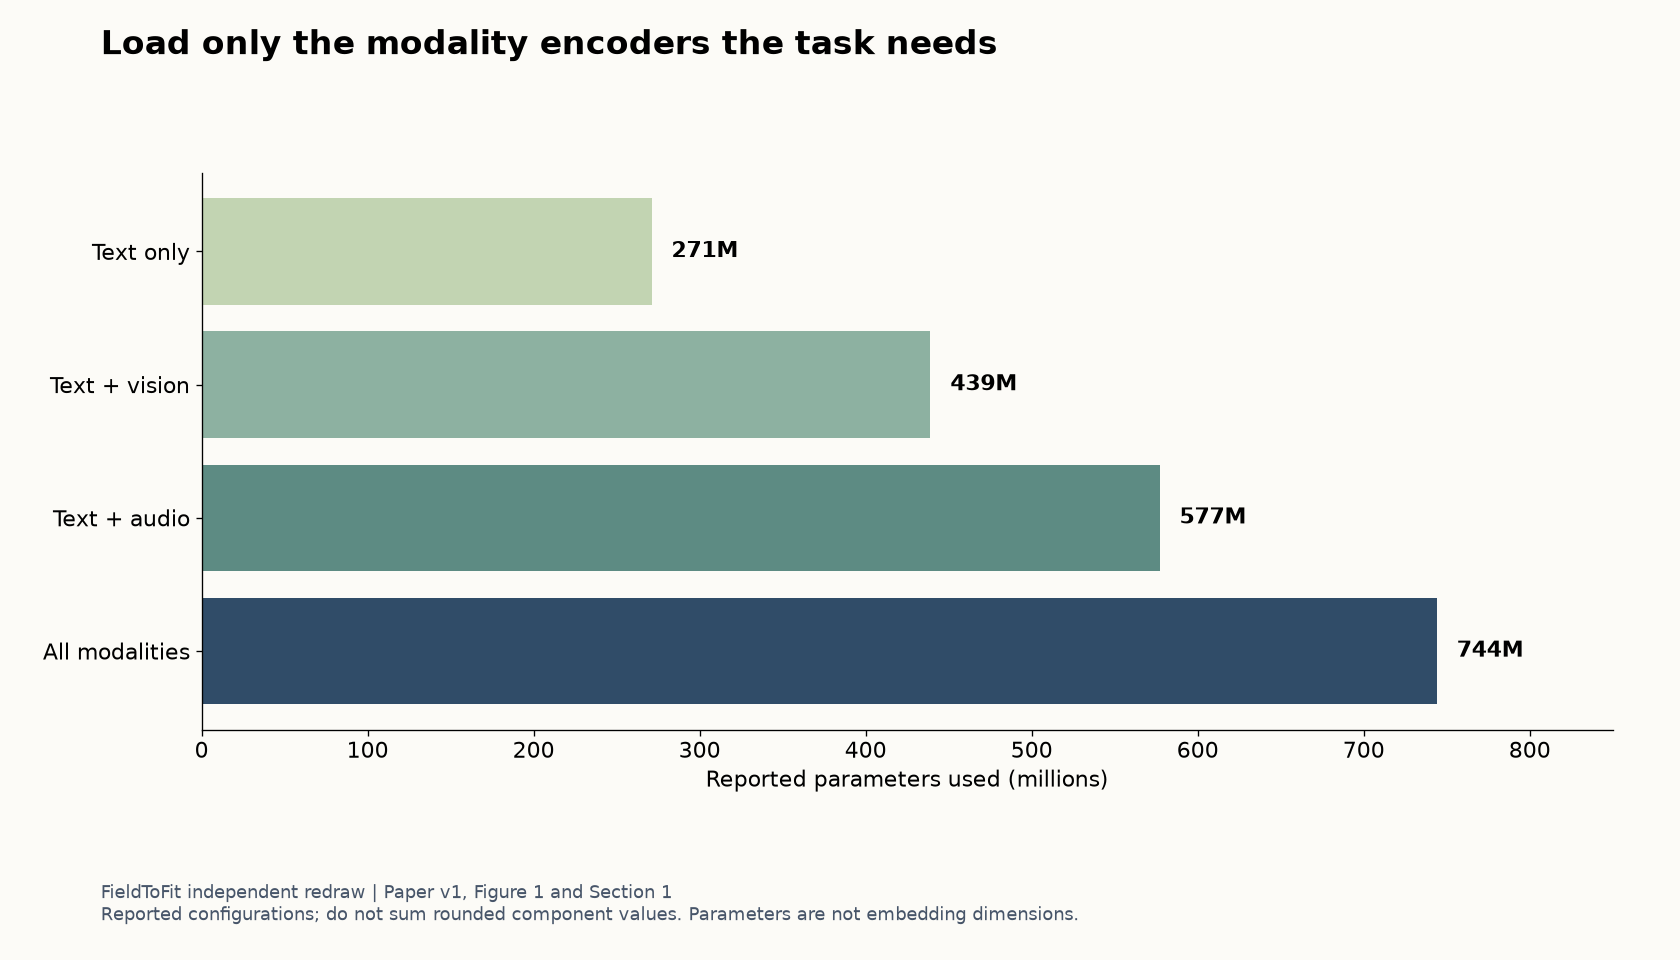
EmbeddingGemma 2由Google团队发布,基于Gemma 4权重与架构,并向Gemini Embedding 2学习。24层双向Transformer通过均值池化、线性投影与L2归一化,输出 768维单向量;文字、图像、声音和交错输入共享空间,目标是检索、聚类和分类,而不是生成回答。

论文报告的四种可选模块配置,单位百万参数
本站据§1、Figure 1重绘。271M文字路径已含embedder;439M视觉、577M声音、744M完整配置按论文报告值,不从四舍五入组件重新相加。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts; original artwork is not reproduced.

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §1; Figure 1; §2.1

图像经过可训练视觉编码器,声音编码器在本研究训练中保持冻结;视频通常先按每秒一帧采样,再限制为 32帧。论文训练序列上限 8192,图像与视频每帧默认分别 280和 140个视觉token,声音每秒 25个软token。长媒体能否完整表示,取决于采样、截断与token预算,不能从“支持视频”推导任意长度无损索引。

适用边界:官方开发文档将规模约写为 740M/270M,论文细写 744M/271M;本文使用论文口径,不将近似命名当另一模型。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §1–2.2; Figure 1

返回核心结论

2. 2|先蒸馏再对比学习,增益不能只解释为训练更久

训练共约 2.9T token:文本预微调约 300B,多模态预微调约 2T,多模态微调约 600B。前两阶段主要向教师蒸馏,最后阶段改用对比损失、spread-out正则与Matryoshka表示学习。随后沿同一训练轨迹平均两个检查点,再进行量化感知训练;不是另找多个独立模型融合。

简化PLE不再保留专用token查找表,而从共享输入投影到各层。Table 2的MMEB-v2总体分数为 55.46对 55.07;Table 3中继续蒸馏的总体 52.28,与改用微调目标的 55.46形成对照。作者使用近似计算量相当的比较;同时最后阶段数据混合与损失配方变化,不能把全部差异归给某一个损失项。

Table 4将可训练视觉编码器与冻结编码器对照,总体 52.27对 48.18。与表 2、表 3一样,这些使用中间配方,不是最终模型Table 6的成绩。附录A还区分非对称检索的query/target前缀与聚类、相似度的同前缀,复现时不能只换权重。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §2.3–3.3; Tables 2–4; Appendix A

返回核心结论
3. 3|代码和原生声音有进步,英文与部分任务仍有回退

前代与第二代的不同任务指标分别比较
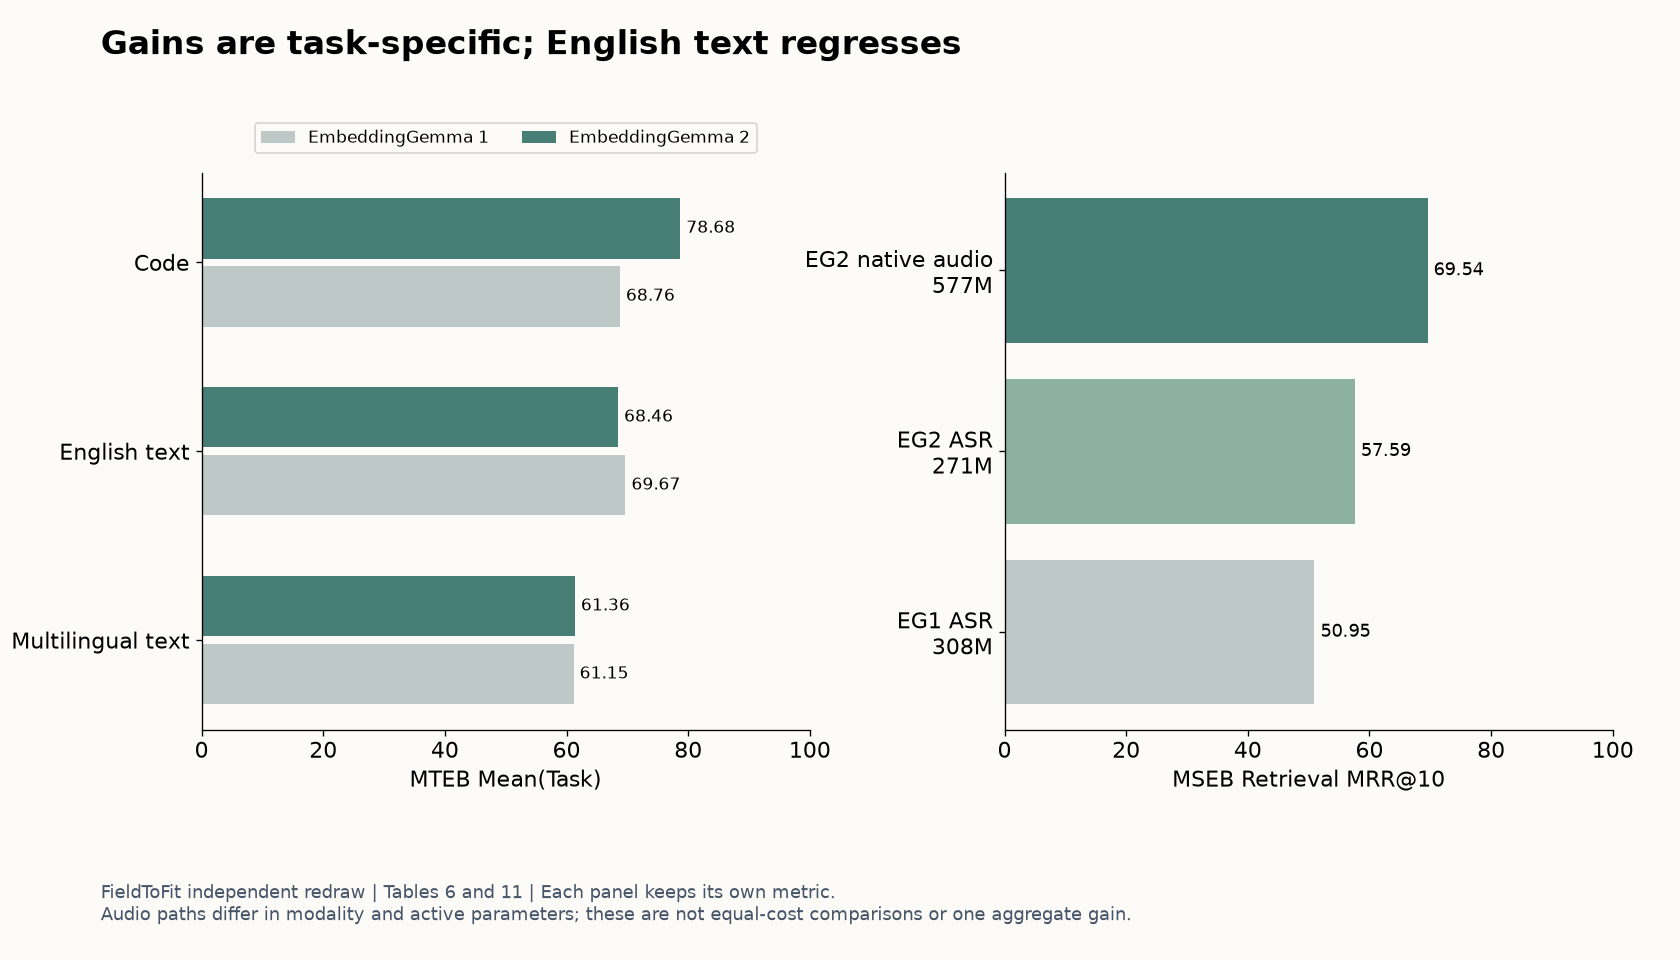
本站据Tables 6、11重绘:前三项为MTEB Mean(Task),声音为MSEB MRR@10且EG1走ASR、EG2走原生声音。各项不可合成平均涨幅。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts; original artwork is not reproduced.

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · Tables 6, 11; §4

Table 6代码Mean(Task)从 68.76到 78.68,多语任务均值 61.15到 61.36,但多语类型均值 54.31到 53.82,英文任务均值 69.67到 68.46。MMEB-v2视觉文档 67.84也低于所列Jina的 71.34;MAEB类型均值 48.65低于其 55.31。不能只展示胜出的聚合方式。

MSEB检索覆盖 26种语言和区域,指标是MRR@10。原生声音路径 69.54,高于同代ASR路径 57.59及前代ASR路径 50.95;原生声音启用 577M而文字路径 271M,并非同成本对照。MTEB有 162项,MMEB-v2有 78项,MAEB有 30项;具体任务结果见附录C。

适用边界:比较限定单向量模型,部分榜单限定 1B或 2B以下;除Jina部分复测外,其他基线主要来自公开榜单。不同任务指标不等于真实RAG回答质量、延迟或成本。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §4.1–4.4; Tables 6–11; Appendices B–C

返回核心结论

4. 4|缩维、量化和视觉预算,是三组不同的取舍

不同视觉token预算下,视频与文档的变化方向不同
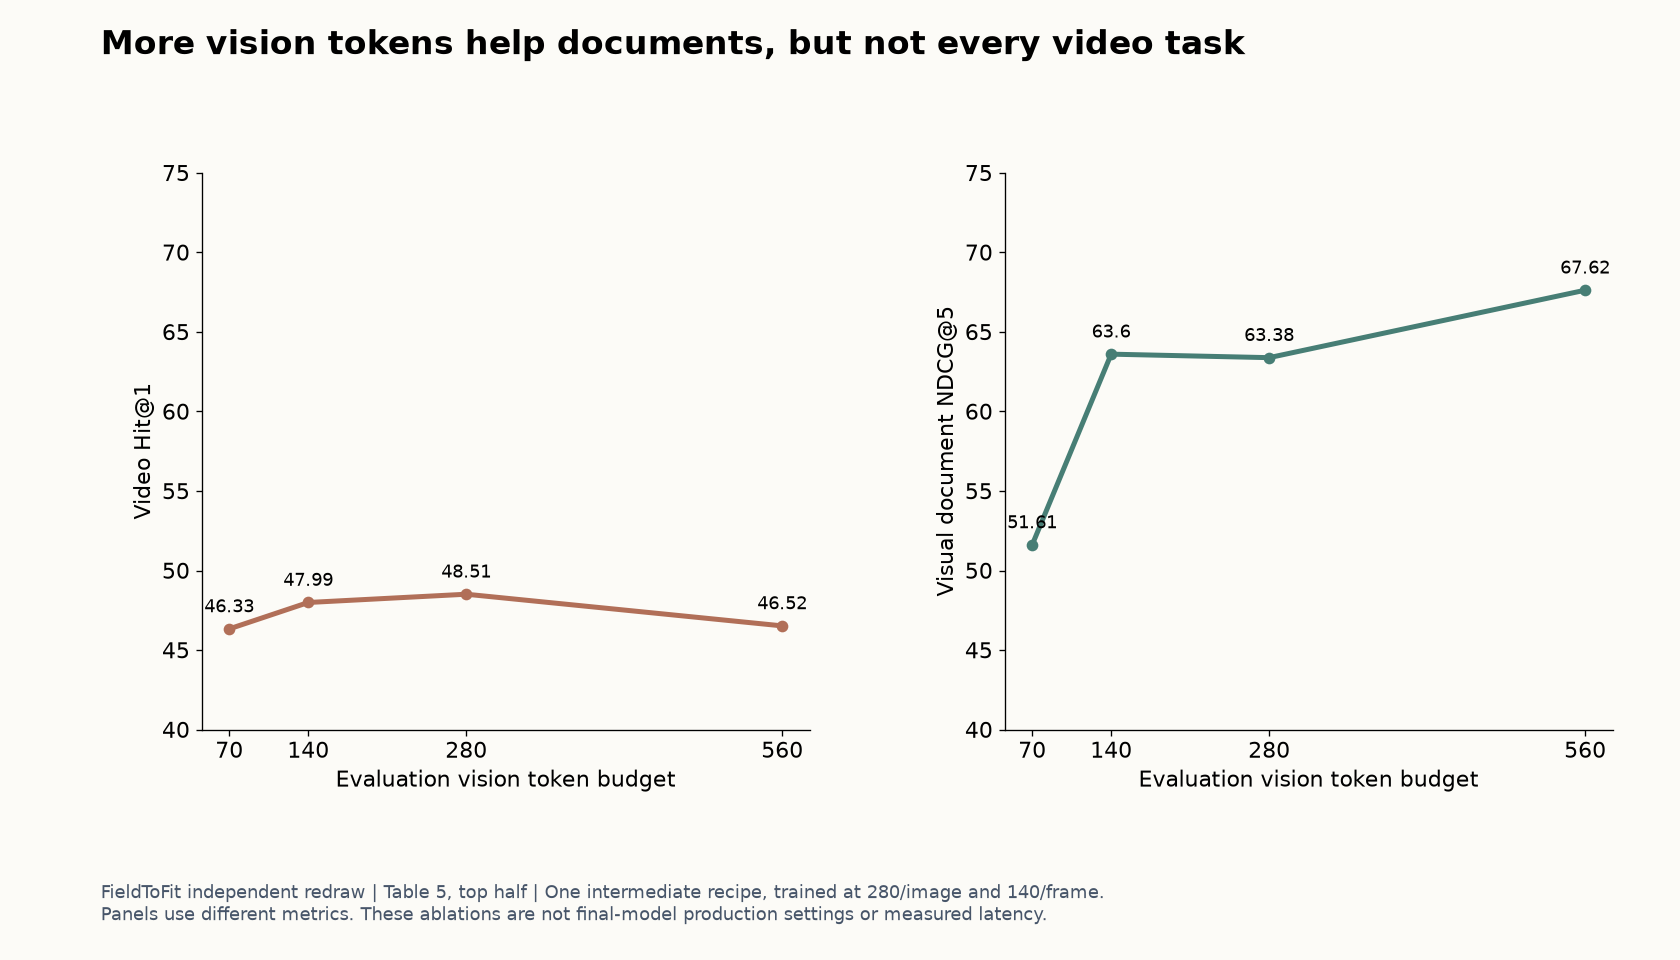
本站据Table 5上半重绘;同一中间模型训练预算 280/140,评测预算 70、140、280、560。视频Hit@1与文档NDCG@5分面显示,不比较两个指标的绝对值。 · FieldToFit · Graphics © FieldToFit. Independent redraw of reported facts; original artwork is not reproduced.

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §3.4; Table 5 top

MRL支持 768、512、256、128维。相同数值精度下,128维的原始向量载荷是 768维的六分之一,这是算术关系;索引、元数据、备份和计算并不会同步缩成六分之一。Table 8的MMEB-v2总体从 768维 59.0降到 128维 45.6,任务侧损失必须与空间收益一起算。

Table 5中视觉预算从 280到 560,文档NDCG@5由 63.38升至 67.62,视频Hit@1却从 48.51降至 46.52;这是中间模型实验,不据此直接规定最终生产预算。Q4_C在Pixel 11 Pro测得文字 191MB、视觉 447MB、完整多模态 567MB峰值内存,包含运行时编译开销,不能推广所有手机或说成权重文件大小。

适用边界:Table 1明确注明视觉/声音float与量化运行的评测harness不同。其差值不能全归因量化;选型应在自己的设备和数据上同时测质量、内存、吞吐与端到端延迟。

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · §2.4, 3.4; Tables 1, 5, 8; Appendix C

返回核心结论

报告与日期

EmbeddingGemma 2: Unified and Efficient Multimodal Representations · arXiv:2610.37364v1; 28 pages · 首次发布 2026-10-27

地图首次发布 2026-11-01T00:28:00.313773+00:00 · 地图修订 2026-11-01T00:28:00.313773+00:00