DeepInfer的推理降本路线:计算、缓存与集群调度如何协同

模型结构→推理引擎→在线服务:区分可复现核心与生产系统条件

减少重复计算、缓存搬运与集群等待需要共同设计;基准数字必须附带硬件、并发和接受率。

基于官方文档与代码分析,未独立复现;公开离线引擎不等于完整在线服务。

本次变化:新增经用户批准的DeepInfer技术专题:五条结论、对应论述、两张官方原图与一张数据重绘;保留原动态及模型报告日期。

方法、实验与证据

缓存架构改变调度:让历史计算不再绑定一台机器

机制
跨节点可访问的前缀缓存,让请求分配不必总被缓存所在机器绑定。
条件/配置
跨节点全局KV、主机内存SWA、缺失重放
报告结果
跨节点可访问的前缀缓存,让请求分配不必总被缓存所在机器绑定。
局限
原作者材料,未独立复现实验;局部收益不等于完整在线服务收益。

DeepSeek V4.1 Flash Inference Deployment Q&A · KV cache storage and request scheduling

Prefill 与 Decode 分开优化:集群规模不是统一答案

机制
处理输入与逐步生成的瓶颈不同,不能共用一个最佳设备数量。
条件/配置
Prefill EP2–8;Decode EP64–128;具体取决于容量与互联
报告结果
处理输入与逐步生成的瓶颈不同,不能共用一个最佳设备数量。
局限
原作者材料,未独立复现实验;局部收益不等于完整在线服务收益。

DeepSeek V4.1 Flash Inference Deployment Q&A · Parallelism and expert load balancing

DSpark 动态验证:少验证一些草稿,反而可能提高有效吞吐

机制
草稿接受概率与调度成本共同决定验证预算,收益随并发而变。
条件/配置
EP64 / DP64;固定 5草稿与动态验证;作者估计吞吐
报告结果
草稿接受概率与调度成本共同决定验证预算,收益随并发而变。
局限
原作者材料,未独立复现实验;局部收益不等于完整在线服务收益。

DeepSeek V4.1 Flash Inference Deployment Q&A · DSpark confidence-scheduled verification table; EP64/DP64

如何正确读性能曲线:先看分母,再看条件

机制
接受率、上下文长度与服务范围决定离线数字能否迁移到在线业务。
条件/配置
131,072 token上下文;固定 3草稿;75%接受率
报告结果
接受率、上下文长度与服务范围决定离线数字能否迁移到在线业务。
局限
原作者材料,未独立复现实验;局部收益不等于完整在线服务收益。

DeepInfer README / architecture and performance figures · Decode curve; benchmark.py and plot_pareto.py acceptance adjustment

关系与依据

DeepInfer的推理降本路线:计算、缓存与集群调度如何协同

  1. 降本从模型结构开始:少算与少存是一套设计

    共享与压缩KV、减少Decoder重复Prefill,为引擎优化创造条件。

  2. 缓存架构改变调度:让历史计算不再绑定一台机器

    跨节点可访问的前缀缓存,让请求分配不必总被缓存所在机器绑定。

  3. Prefill 与 Decode 分开优化:集群规模不是统一答案

    处理输入与逐步生成的瓶颈不同,不能共用一个最佳设备数量。

  4. DSpark 动态验证:少验证一些草稿,反而可能提高有效吞吐

    草稿接受概率与调度成本共同决定验证预算,收益随并发而变。

  5. 如何正确读性能曲线:先看分母,再看条件

    接受率、上下文长度与服务范围决定离线数字能否迁移到在线业务。

1. 降本从模型结构开始:少算与少存是一套设计

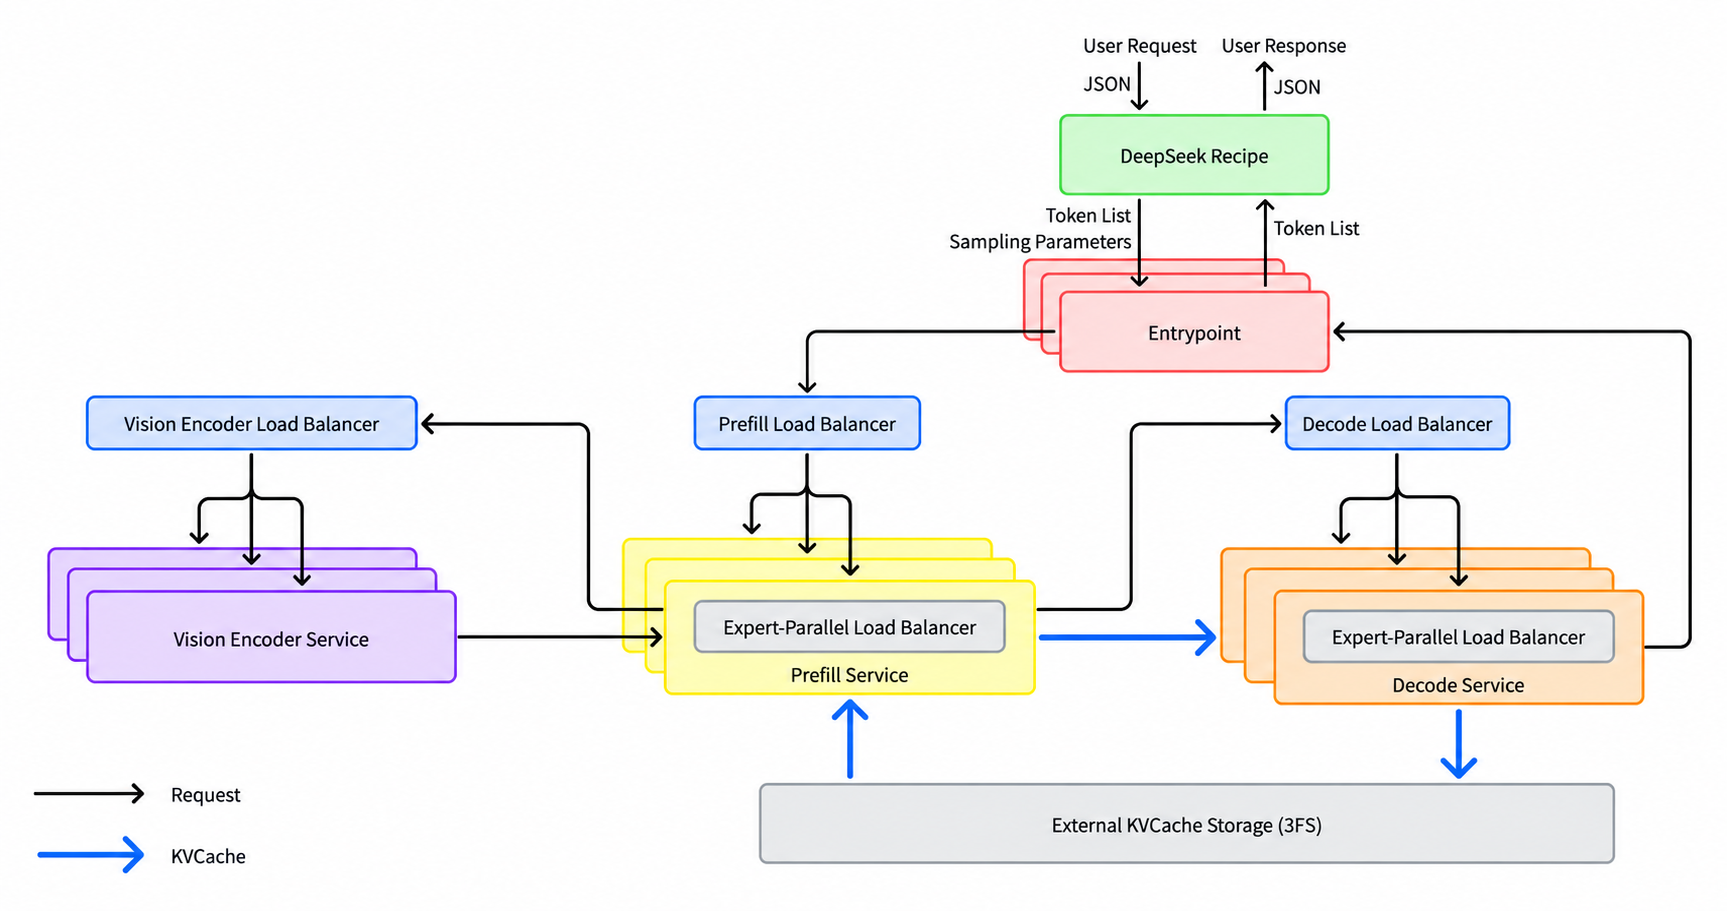
DeepInfer官方架构:请求调度、分阶段计算和外部KV缓存
图 1|官方架构图。公开离线引擎不包含完整生产缓存服务与请求分流系统。 · DeepSeek-AI原图,未改动。 · Apache-2.0

DeepInfer README / architecture and performance figures · Architecture overview; open-source scope

V4.1-Flash 的 CED 将模型划分为 Encoder 与 Decoder。Decoder 的全局 KV 来自最终 Encoder 状态,使长提示词的大部分 token 不必再经过完整 Decoder Prefill;局部滑动窗口注意力的状态,则通过有限长度的重放补齐。在提示词远长于局部窗口的条件下,这能显著减少 Prefill 计算。它不能直接推导为“所有请求的延迟减半”。

CSA2 则跨层共享全局 KV,并复用部分检索结果。模型报告给出的全局 KV 为 890 字节/token,约为 V4-Flash 的四分之一。这里的统计对象是全局 KV,不包括模型权重、全部局部状态、运行时缓冲等,不能将其换算成整机显存缩减比例。低精度也并非一刀切:主 KV 使用 FP4,而敏感的局部 SWA KV 保留 FP8。

适用边界:一个必须保留的精度边界Bounded Replay 只重放最近的窗口,而精确恢复跨层局部状态需要更长的历史。报告明确承认:这是近似状态,不同缓存命中位置产生的结果并不在数学上完全相同。作者在所测任务上观察到质量影响很小,但这不是所有输入上的等价保证。公开 YOCO 测试比较两种实现的一致性,也不能替代“近似重放与完整重算完全等价”的证明。

FieldToFit 判断:DeepInfer 的部分效率来自模型在训练和架构阶段就为部署留出了优化空间。将同一引擎迁移到没有相同 KV 共享与重放结构的模型,不能期待自动获得同样收益。

DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression · Sections 2–3; pp.9–14,20,37

返回核心结论

2. 缓存架构改变调度:让历史计算不再绑定一台机器

长对话与 Agent 工作流会反复携带较长的历史上下文。如果历史 KV 只能在少数机器命中,调度器就要在“复用缓存”与“避免拥塞”之间取舍。官方部署方案把较长寿命的全局 KV 放入基于 3FS 的分布式存储,使不同 Prefill 实例可以访问相同前缀;短寿命的 SWA 状态使用主机内存,缺失时再重放恢复。

这让存储容量与计算资源可以分别扩展,也削弱了将请求固定路由至特定缓存节点的必要性。实际收益仍取决于缓存命中率、读取延迟、网络和数据搬运能否被计算覆盖。Q&A 描述的分层读取与异步搬运,是这套设计的一部分,不能只部署存储就假设收益成立。

FieldToFit 判断:对重复前缀多、对话跨度长的业务,这种设计值得优先研究;对短请求、低复用业务,缓存层的容量和运维投入是否划算,需要用真实流量测量。更长的缓存保留时间,不等于每个请求都更快。

DeepSeek V4.1 Flash Inference Deployment Q&A · KV cache storage and request scheduling

返回核心结论

3. Prefill 与 Decode 分开优化:集群规模不是统一答案

Prefill 一次处理输入中的许多 token,Decode 则持续逐步生成,二者对计算、权重访问和通信的压力不同。官方生产经验倾向于:Prefill 使用能容纳模型的较小并行组,通常 EP2–8;Decode 使用较大的 EP64–128 组,借助专家并行、通信融合和负载均衡提高效率。

EP 表示把 MoE 专家分布到不同设备。扩大 EP 能降低单设备承担的专家权重与计算负担,但也增加对互联、调度及热点专家处理的要求。DeepInfer 已包含专家级负载均衡 EPLB;它与“把用户请求分配给不同实例”的负载均衡不是同一件事。

官方建议的高效服务集群规模,也不能当作运行离线引擎的硬性最低配置。公开 README 的基准图使用 NVIDIA SM100;项目另支持 Huawei Ascend 950,但这些 NVIDIA 曲线不能证明两种硬件具备相同性能。

FieldToFit 判断:是否需要更大的并行组,应同时看每用户速度、每卡吞吐和尾延迟。在低负载业务中,增加设备并不保证成本更低。

DeepSeek V4.1 Flash Inference Deployment Q&A · Parallelism and expert load balancing

返回核心结论
4. DSpark 动态验证:少验证一些草稿,反而可能提高有效吞吐

推测解码先用较便宜的草稿路径预测多个 token,再由主模型验证。固定验证长度会把资源花在一些很可能被拒绝的草稿上。DSpark 使用置信度信息估计草稿前缀的接受概率,并结合引擎在当前负载下的性能,为请求分配验证长度。

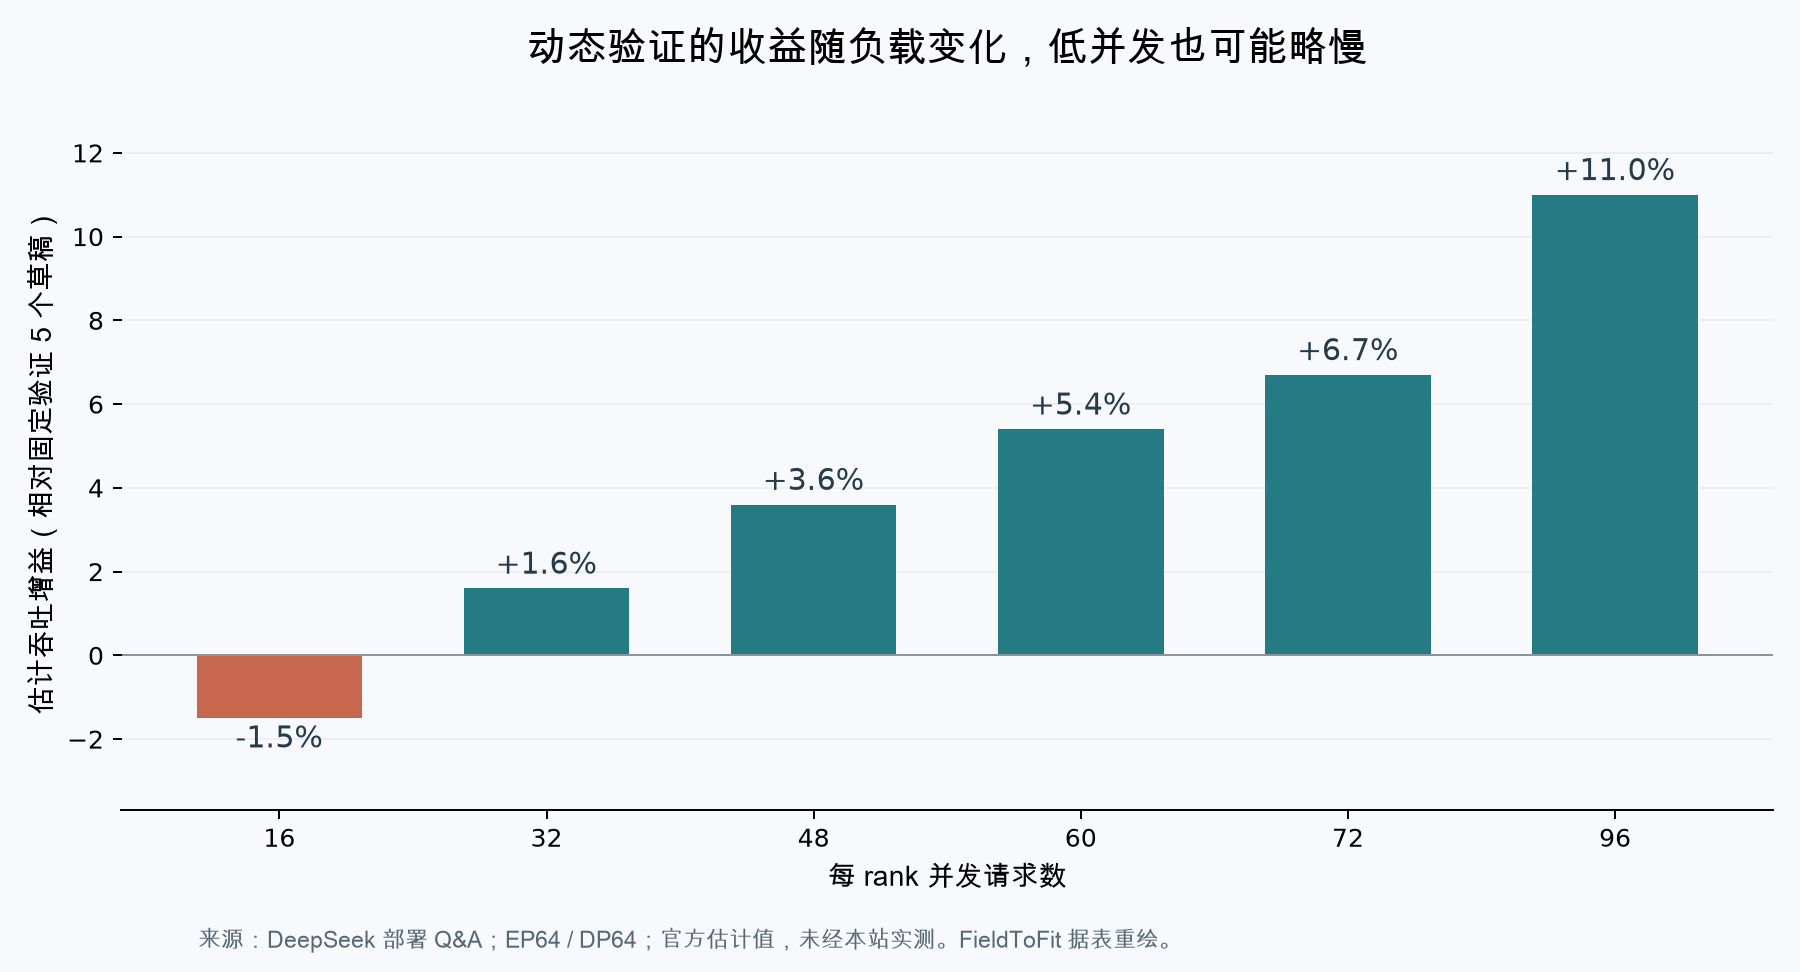
官方 Q&A 在 EP64 / DP64 下比较“固定验证 5 个草稿”与动态长度。每 rank 并发为 60 时,平均验证长度从 5 降到 3.58,平均接受长度从 3.30 降到 3.21;估计吞吐则从 13,730 升至 14,466 tok/s/rank,增幅约 5.4%。验证量减少 28.4%,不能写成端到端加速 28.4%。

动态验证估计吞吐增益:并发 16为−1.5%,并发 96为+11.0%
图 2|EP64 / DP64;相对固定验证 5草稿的估计吞吐增益;横轴为每rank并发。 · FieldToFit据官方Q&A原表重绘;非本站硬件测试。 · Graphics © FieldToFit. Redraw of author-reported facts; no independent performance reproduction.

DeepSeek V4.1 Flash Inference Deployment Q&A · Dynamic verification comparison table

结果保留了负收益点:并发 16 时为−1.5%,并发 96 时为+11.0%。这支持一个更具体的结论:动态验证是在特定负载下改善计算资源分配,而不是对所有请求都增加一个固定加速系数。

FieldToFit 判断:值得关注的新意是把草稿接受概率与调度成本连起来。采用时应让验证策略随业务负载评估,而不能只选最高增益点作为上线预期。

DeepSeek V4.1 Flash Inference Deployment Q&A · DSpark confidence-scheduled verification table; EP64/DP64

返回核心结论

5. 如何正确读性能曲线:先看分母,再看条件

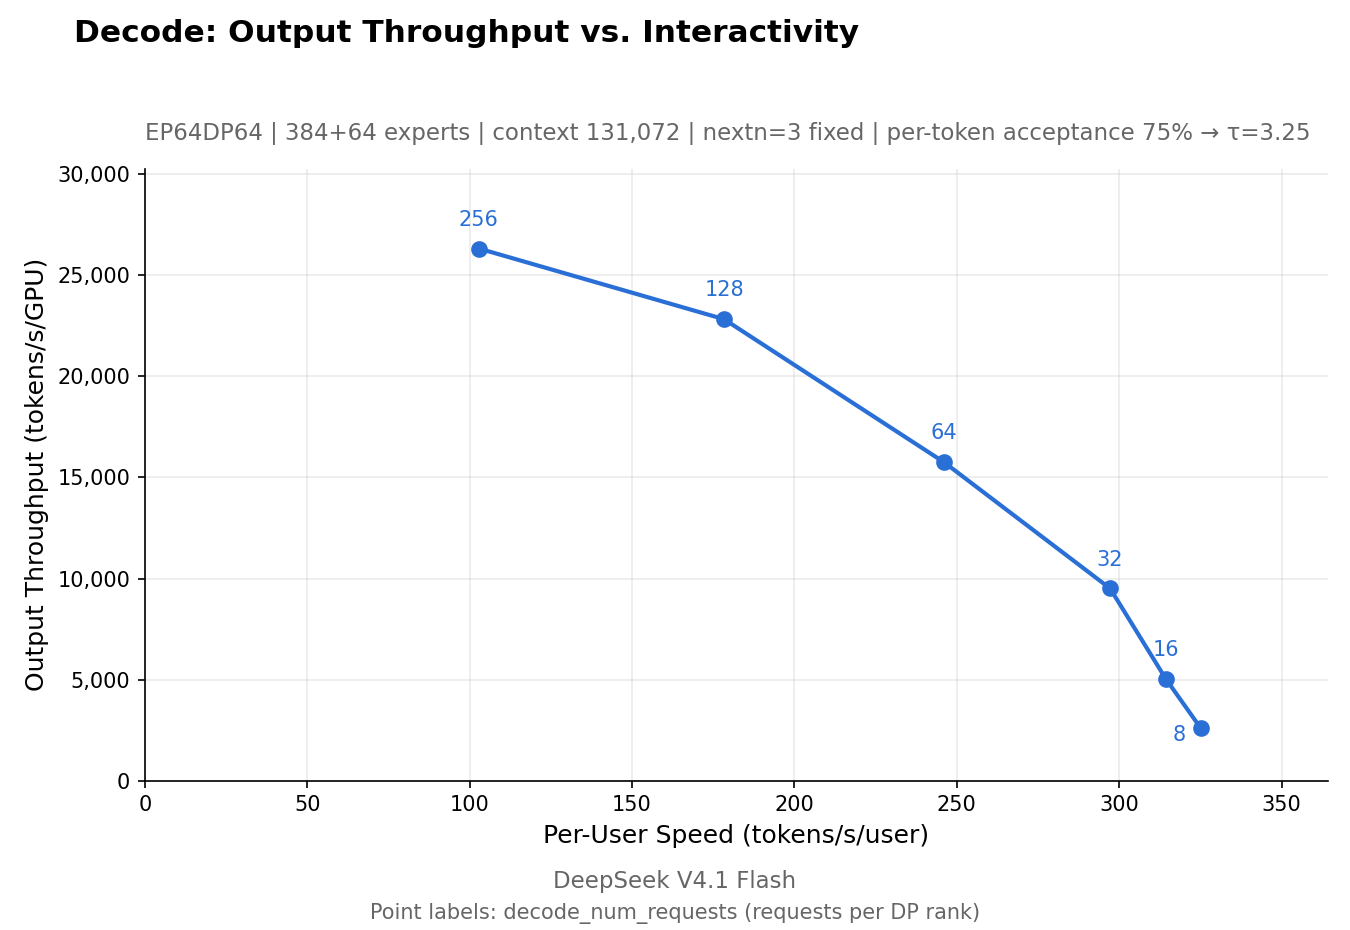
官方 Decode 曲线固定上下文为 131,072 token,使用 EP64 / DP64、384+64 专家配置,并将固定 3 个草稿按 75% 的逐 token 接受率换算。横轴是每用户生成速度,纵轴是每 GPU 输出吞吐。更高并发通常能提高每卡吞吐,同时降低每用户速度:两者需要取舍。

每GPU输出吞吐与每用户生成速度的取舍曲线
图 3|131,072 token上下文;固定 3草稿;75%接受率;384+64专家。不同于图 2的 5草稿实验。 · DeepSeek-AI原图,未改动。 · Apache-2.0

DeepInfer README / architecture and performance figures · Decode Output Throughput vs. Interactivity

代码中还有一个很容易漏掉的口径:默认基准按草稿全部接受计算原始吞吐,而绘图脚本才把固定长度草稿换算为有效 token。代码使用的系数为:

每步计入的有效 token = 1 + 草稿数量 × 接受率

例如 3 个草稿、75% 接受率时,系数为 3.25,而不是全接受时的 4。用全接受原始值直接报告有效生成吞吐,会高估。这是该脚本的计数口径,不是可随意套到所有推测解码方法上的通用收益公式。绘图路径还明确限定固定长度验证,不能把这套系数再次乘到动态长度结果上。

离线曲线也不包含完整的在线排队、协议转换和网络延迟。Prefill 图的横轴是一步计算的耗时,并非用户请求从发出到首 token 的总等待。仓库没有在这里给出与其他通用推理框架完全同条件的对照,不能据此下结论说 DeepInfer 对所有模型、硬件和负载都更快。

DeepInfer README / architecture and performance figures · Decode curve; benchmark.py and plot_pareto.py acceptance adjustment

返回核心结论

报告与日期

DeepSeek V4.1 Flash Inference Deployment Q&A · Official engineering Q&A; English document 774ce24 · 首次发布 2026-10-20

DeepInfer README / architecture and performance figures · DeepInfer commit 9bd9cf243fc53ef9afbf8f04d391d989117d6ab9 · 首次发布 2026-10-20

DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression · arXiv:2609.19969v1 · 首次发布 2026-09-17

地图首次发布 2026-10-22T02:56:26.901623+00:00 · 地图修订 2026-10-22T05:57:54.791623+00:00

DeepSeek档案

DeepSeek-V4.1-Flash-1017档案