证明的是精确定义的性质,先读规格再读规模
- 机制
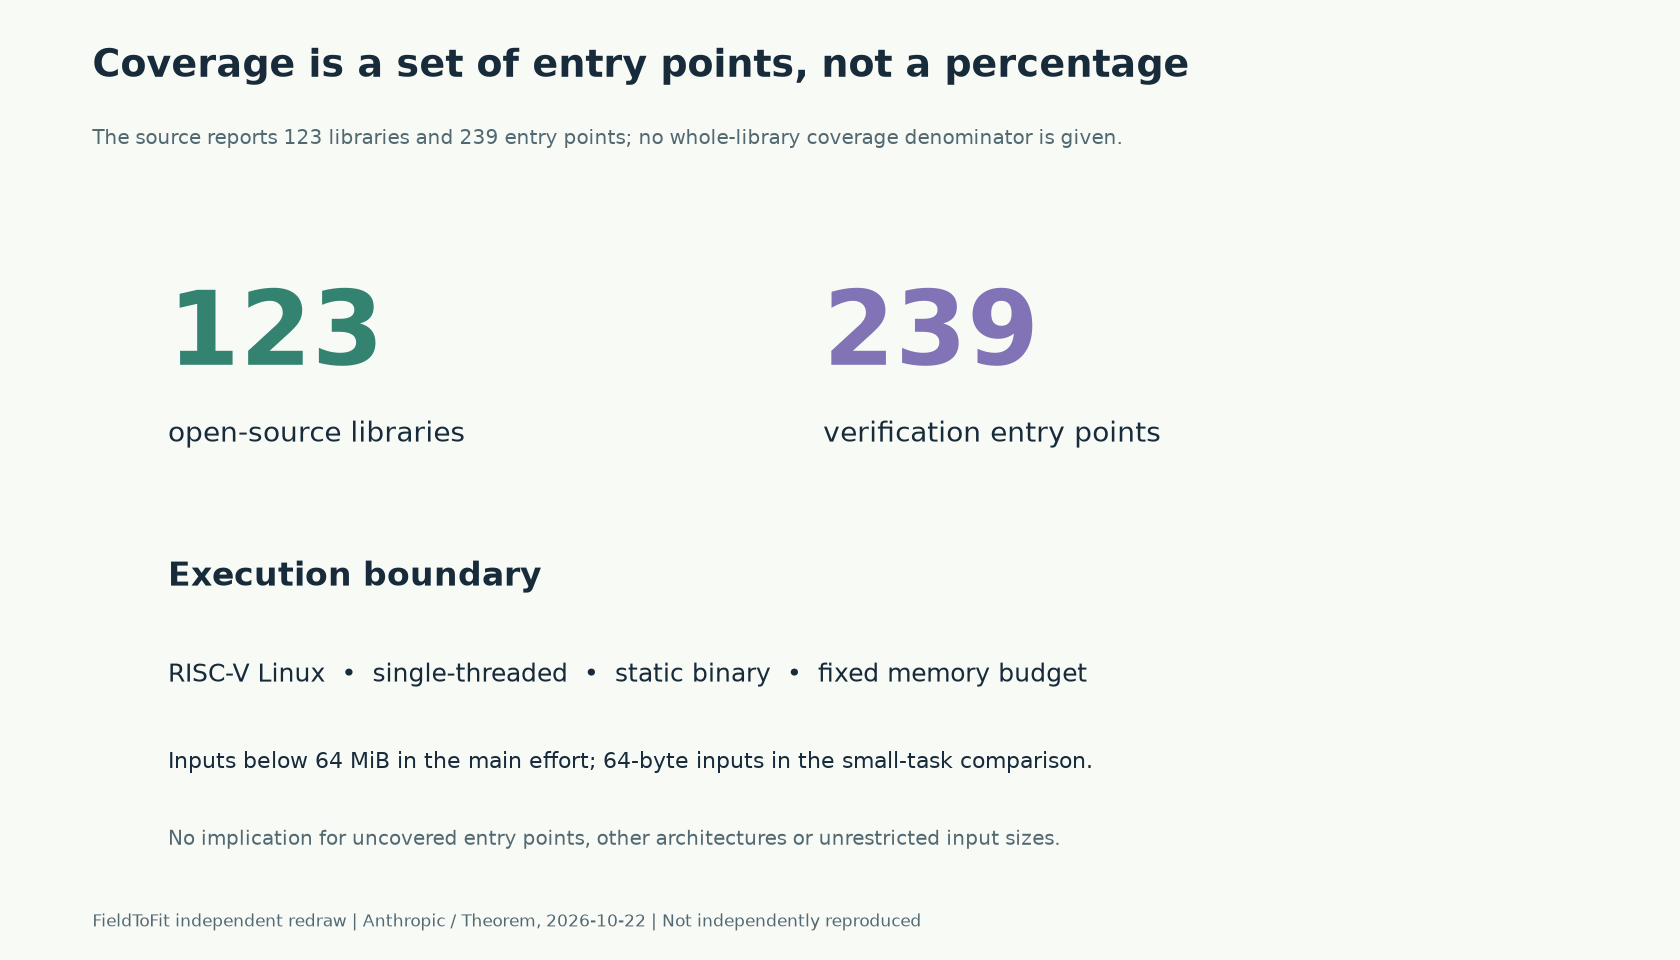
- 239 个入口点来自 123 个库;覆盖特定可执行产物与假设,不是整库全部行为。
- 条件/配置
- 规格、机器检查、环境边界与 token 对照
- 报告结果
- 239 个入口点来自 123 个库;覆盖特定可执行产物与假设,不是整库全部行为。
- 局限
- 原作者结果,未独立复现;特定入口与执行环境不代表整库全部行为无错误。
规格、机器检查、环境边界与 token 对照
独立证明检查是进展;规格和执行假设决定保证范围。
原作者结果,未独立复现;特定入口与执行环境不代表整库全部行为无错误。
本次变化:首次整理所选原始研究;四条结论、同号论述及三张本站重绘。
并行探索:分别阅读方法、结果与边界
Finding and fixing bugs; Limitations并行探索:分别阅读方法、结果与边界
This is just the beginning; technical appendix pp.1–6并行探索:分别阅读方法、结果与边界
This is just the beginning; Limitations239 个入口点来自 123 个库;覆盖特定可执行产物与假设,不是整库全部行为。
约 1,000,000,000 行生成内容中,最终有约 180,000,000 行接受的 Rocq 证明;这些行数描述本次产物。
模型对照看完成半数任务所需 token;协作对照看共享证明工作的 token 使用,二者分母不同。
模型提出证明,独立工具判定,人工核对规格与变更;不同证据等级保持分开。
作者从 OSS-Fuzz 的测试入口组织验证任务:把待检查的行为写成数学规格,由 Claude 生成 Rocq 证明,再让独立证明检查器核验。关键变化是最终证据可由机器检查,而不必信任模型对正确性的口头判断。
本次在 RISC-V Linux、单线程、静态二进制、musl libc 与固定内存预算等设定下,比较 ASan 插桩和未插桩程序。附录定理排除故障、abort 和未建模行为,并比较输入输出轨迹、退出方式及文件系统终态。输入小于 64 MiB 等条件属于结论本身;这些定理不应扩写为任意程序必然终止。
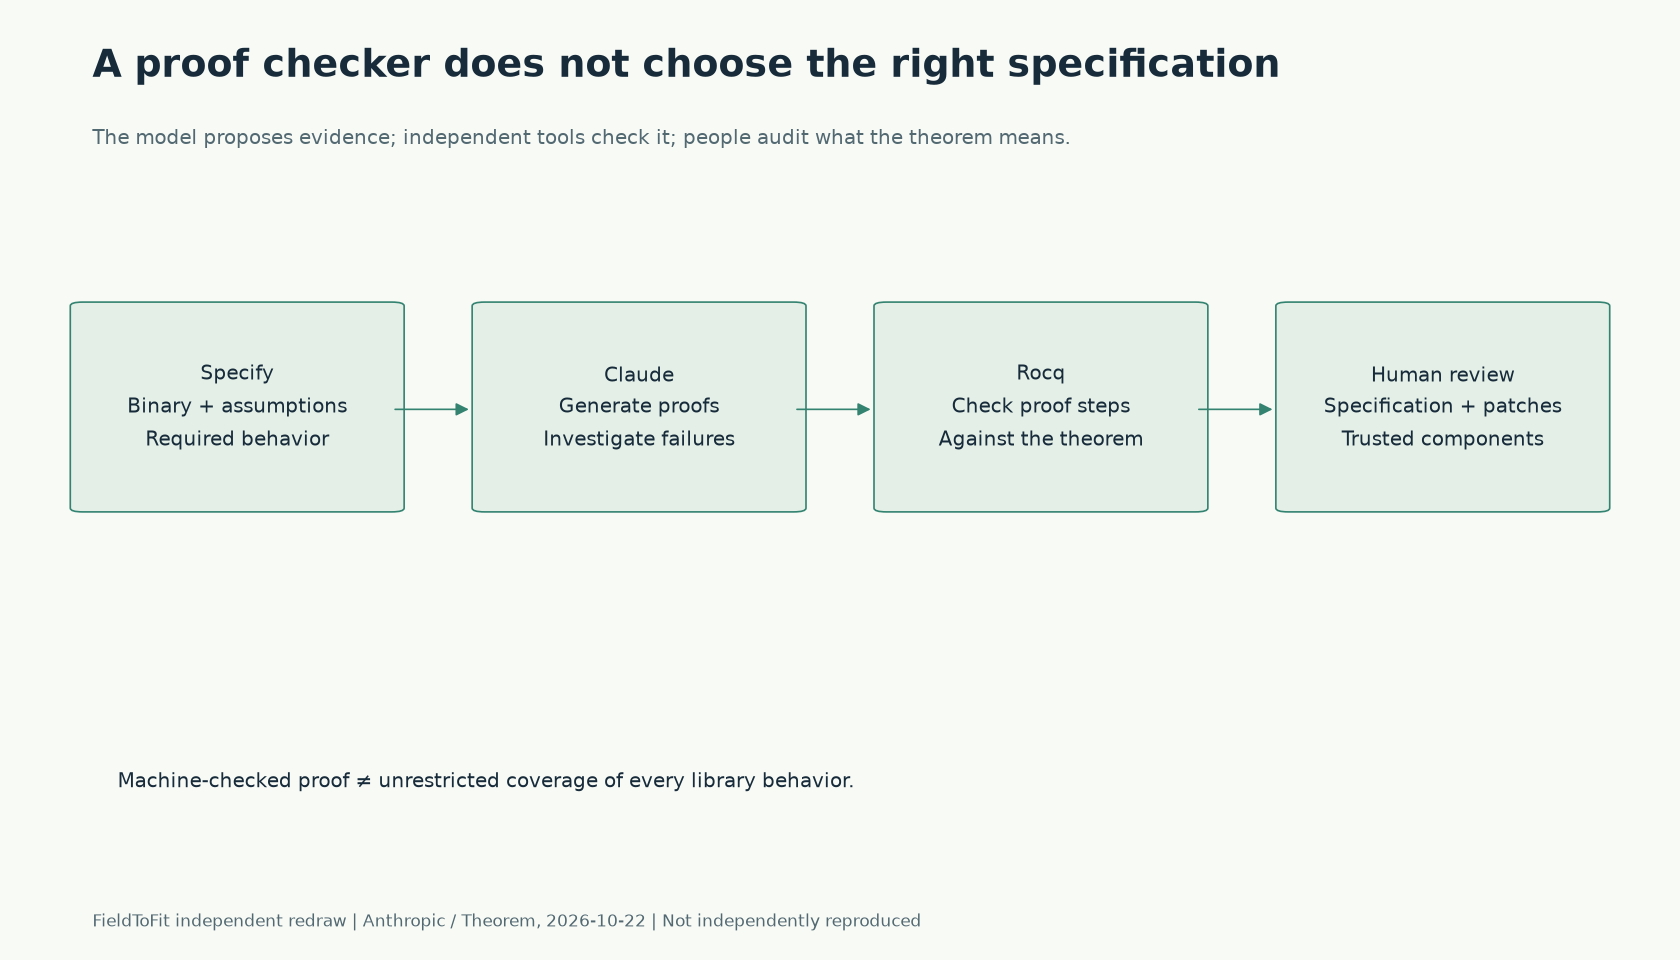
适用边界:未覆盖的入口、并发行为、其他架构、动态链接或超出预算的输入不能从这些结果自动获得保证。行为对应不等于性能一致,也不自动证明终止。
返回核心结论239 个验证入口分布在 123 个库,说明方法跨越多类真实程序,而不是只处理短小的人工例题。但每个库的函数数量、代码路径与已审规格不同;没有整库总入口分母,不能换算为库的安全覆盖百分比。
生成过程中还可能暴露历史测试没有触及的问题;但发现问题、修补代码与证明修补后的性质是三个步骤。模型若通过删除有用功能来满足较弱规格,形式上通过仍可能违背用户目标,所以补丁和规格必须共同审查。
适用边界:证明检查器、语义模型及规格仍处于信任边界内。巨大且重复的证明可能增加存储、检查与维护成本;行数不是可复用性或经济性的直接指标。
返回核心结论附录的单 Agent 比较包含 36 个小型 ASan 任务,每题有三次独立尝试,每次最多 5M token。完成曲线按最先成功的尝试计;Opus 5.5 达到半数任务完成所需 token 比 Opus 5 少约 40%。这不是所有任务总成本下降,也不说明所有任务都完成。
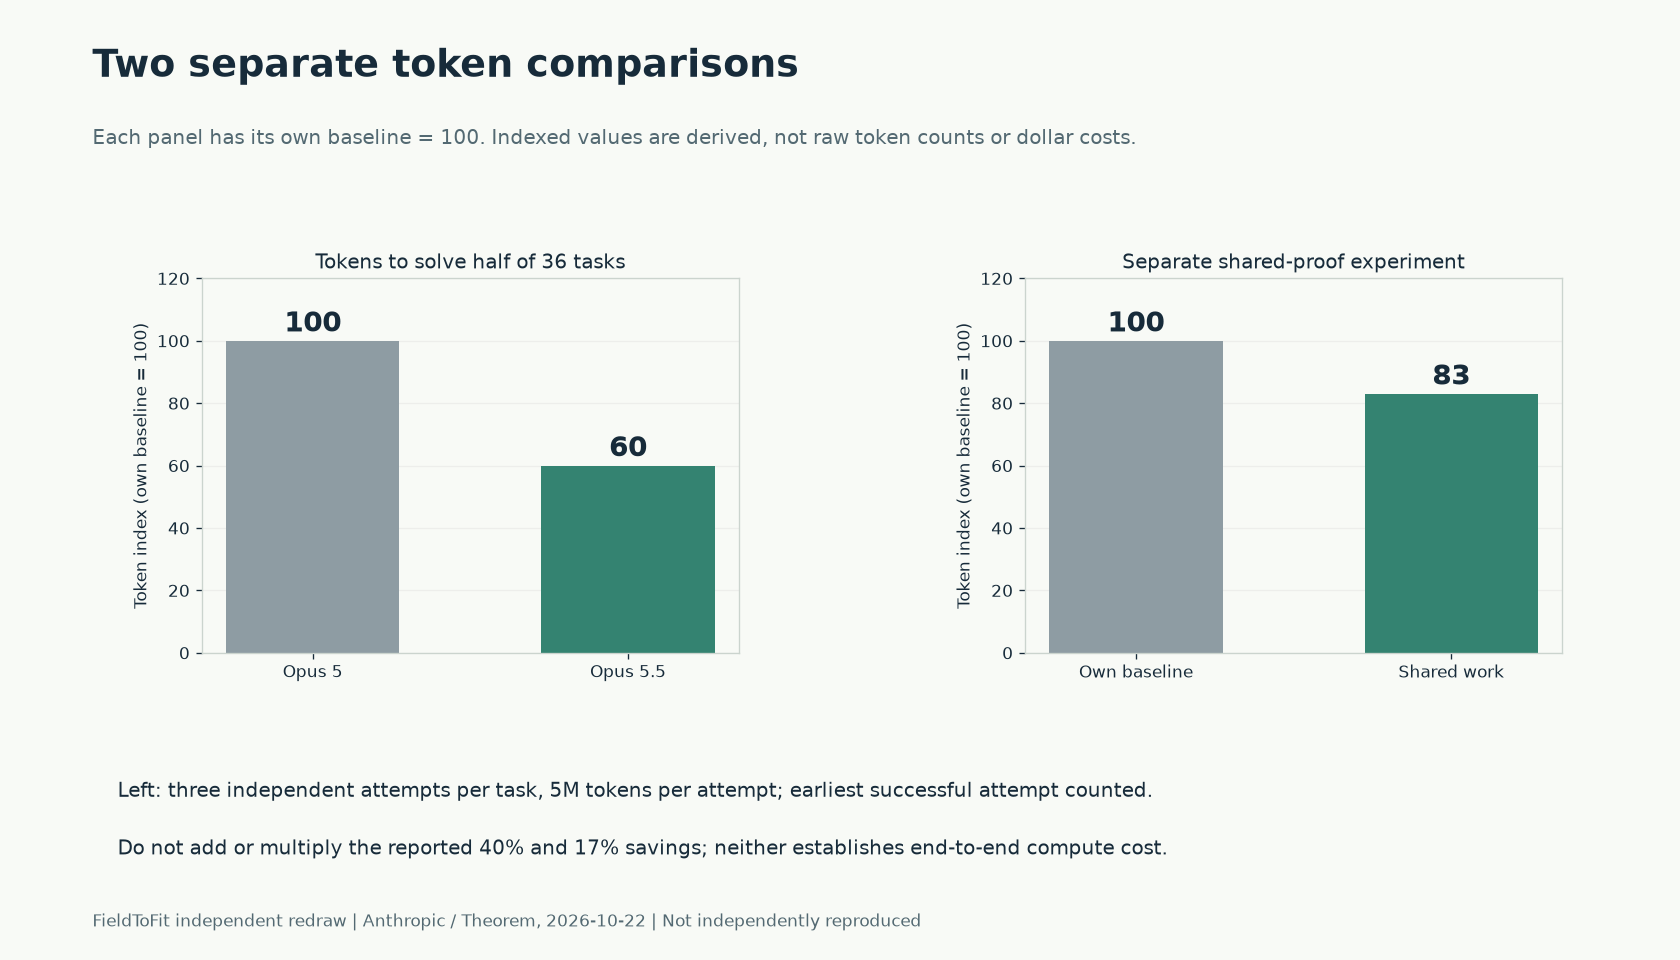
另一项实验报告共享证明工作后少用约 17% token。它不能与模型对照的 40% 相加或相乘。附录小任务的输入界限为 64 字节,主项目讨论的是小于 64 MiB;两种规模不能混用。最终证明检查也可能需要较长 CPU 时间,token 节省不直接等于端到端时间节省。
返回核心结论报告还介绍 Rust 实现的 Python 子集与 CPython 对照测试。约 1.7M、主要随机生成的测试提供经验一致性证据,不能替代对完整 CPython 语义的形式化等价证明。本文保留这类扩展示例,但不把它算入主项目相同的保证口径。
适用边界:本站建议先选输入和环境可明确限定的关键组件,审查规格是否保留业务功能,再分别记录证明通过、未覆盖条件、补丁审计及复查成本。本站没有运行 Rocq、编译产物或复现该实验。
返回核心结论LLMs are making formal software verification feasible at a much larger scale · 2026-10-22; unnumbered article and appendix · 首次发布 2026-10-22
地图首次发布 2026-10-23T04:51:21.411868+00:00 · 地图修订 2026-10-23T04:51:21.411868+00:00