59片算的是一组映射假设,不是模型固有尺寸
- 机制
- 59片由层类型、精度和布局共同决定,不能直接当成真实部署清单。
- 条件/配置
- 权重容量 → 请求状态 → 流水线 → 同口径比较
- 报告结果
- 59片由层类型、精度和布局共同决定,不能直接当成真实部署清单。
- 局限
- 59片与约 190路属于带假设的容量账本,未独立实测,也不等于已公开的服务配置或吞吐保证。
从层放置、KV容量到流水线,解释晶圆级推理的条件与证据边界。
先复算能装下多少,再验证实际能服务多少。
59片与约 190路属于带假设的容量账本,未独立实测,也不等于已公开的服务配置或吞吐保证。
本次变化:在已发布动态基础上首次加入完整技术分析:四条结论、对应论述与三张独立计算/示意图,保留原事件日期。
How we deploy Trillion-parameter frontier models on Cerebras · Section 6: KV memory formula images
并行探索:共同约束
Section 6: KV memory formula images并行探索:共同约束
Sections 3–6: connecting wafers and serving requests并行探索:共同约束
Performance comparison and boundary discussion; Hot Chips 2026 background59片由层类型、精度和布局共同决定,不能直接当成真实部署清单。
约 190路是特定上下文下的KV预算,固定状态与工程余量仍要计入。
流水线重叠多个请求,却不取消单请求的自回归依赖。
性能比较应固定模型质量和交互速度,再核对吞吐、功耗与端到端任务。
先区分三个数量:总参数决定要存多少权重,激活参数影响每个token的计算,晶圆数量还取决于请求状态和放置策略。Moonshot技术报告表 1列K3总参数 2.78T、激活参数 104.2B;Cerebras为讲解取约 3T。不能用 104.2B计算全部驻留权重,也不能把 3T近似值反写成模型精确规格。
在全部权重都按 4bit、十进制容量的教学条件下,3×10¹²×4÷8 = 1.5×10¹²字节,即 1.5TB。再除 93层,得到约 16.13GB/层;博文取 16GB。每片 44GB时,两层线性注意力约 32GB;完整注意力层每片一层,余量留给KV。因此ceil(69/2)+24 = 35+24 = 59。
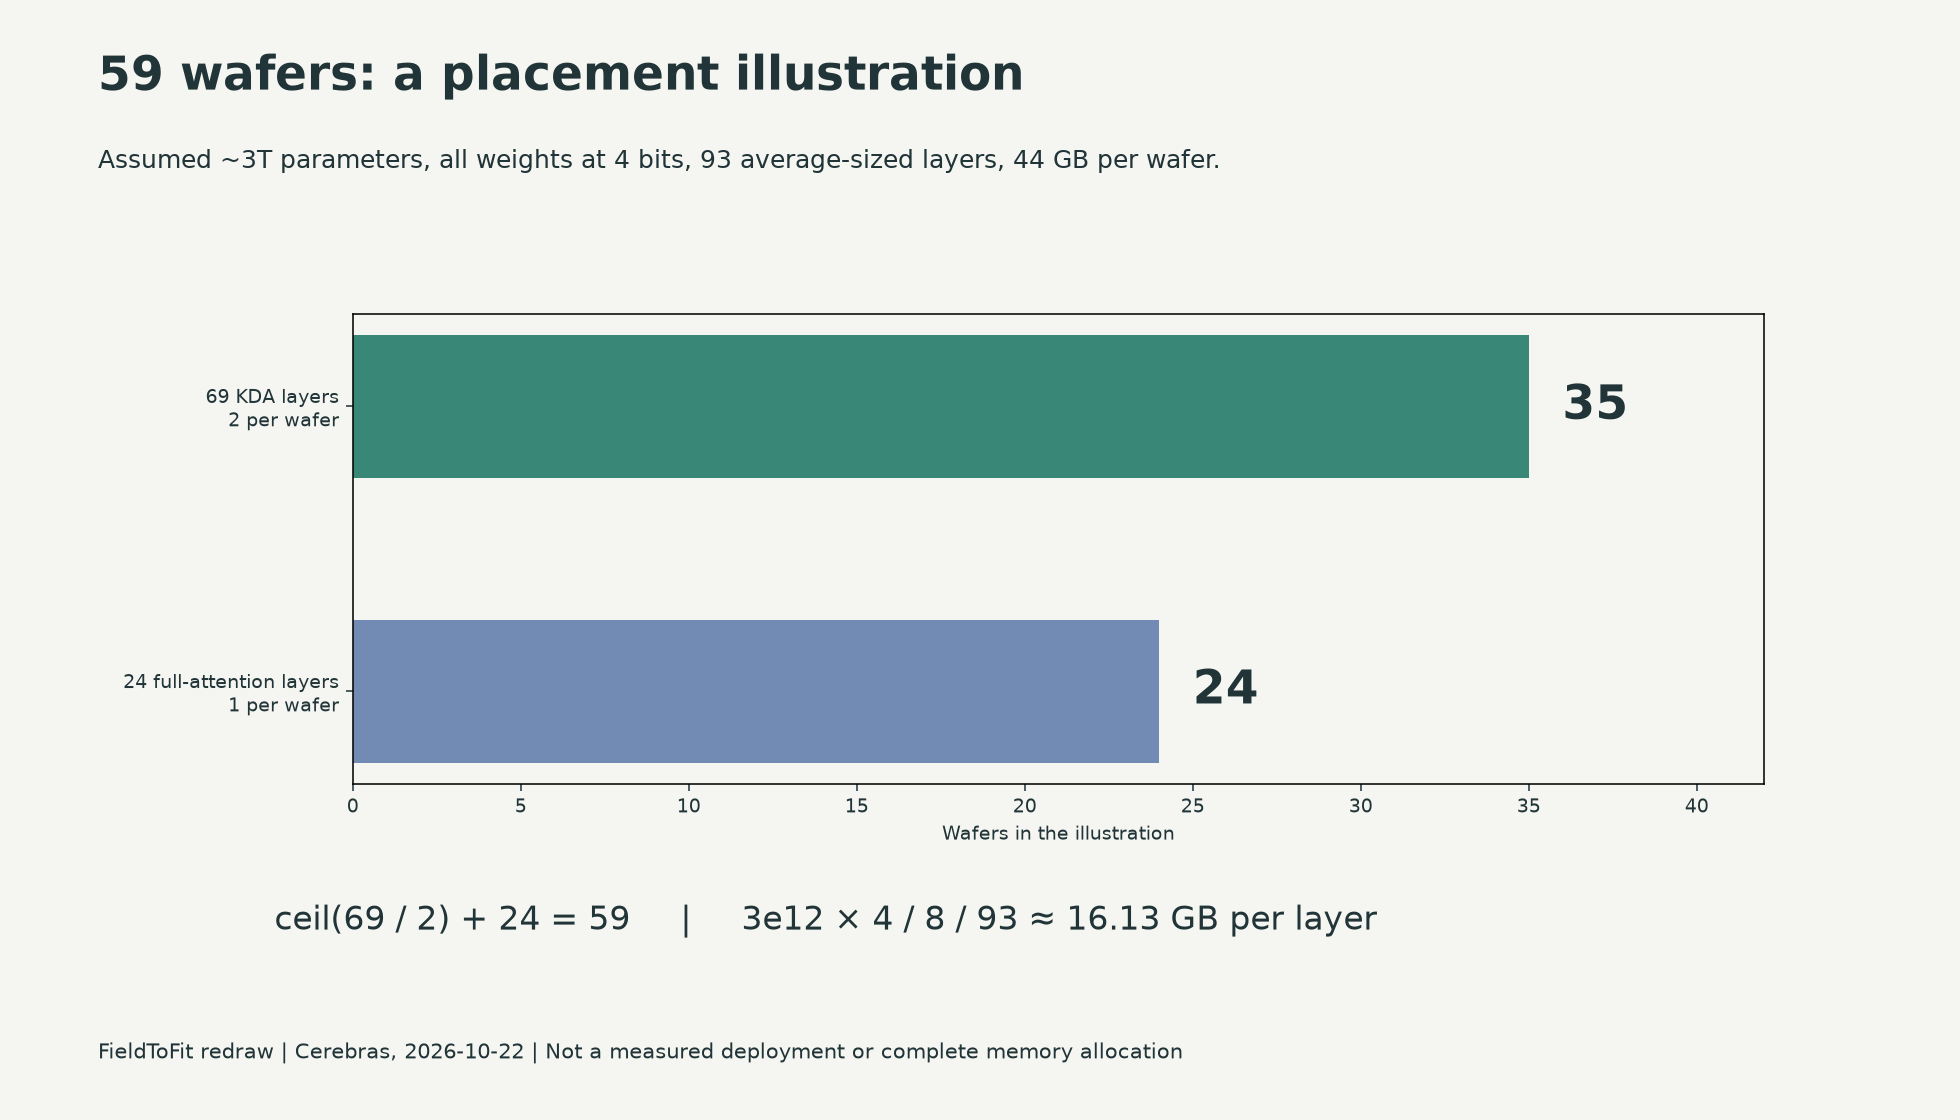
这里的“dense layer”指完整注意力层,不能与模型表中的“Number of Dense Layers = 1”混为一谈:后者对应前馈专家结构,前者对应 69 KDA + 24 Gated MLA的注意力组成。完整注意力也不是每个token都激活全部MoE专家。
Moonshot §4.1.4明确:主要路由专家权重用MXFP4,注意力投影、latent MoE投影、共享专家和路由器等仍保留较高精度;量化元数据也要空间。用一个平均层大小替代每层实际布局,还忽略了嵌入、视觉模块、缓冲、碎片与冗余。真实工程应核对每片的峰值占用,而不是把 1.5TB÷44GB向上取整后就当采购清单。
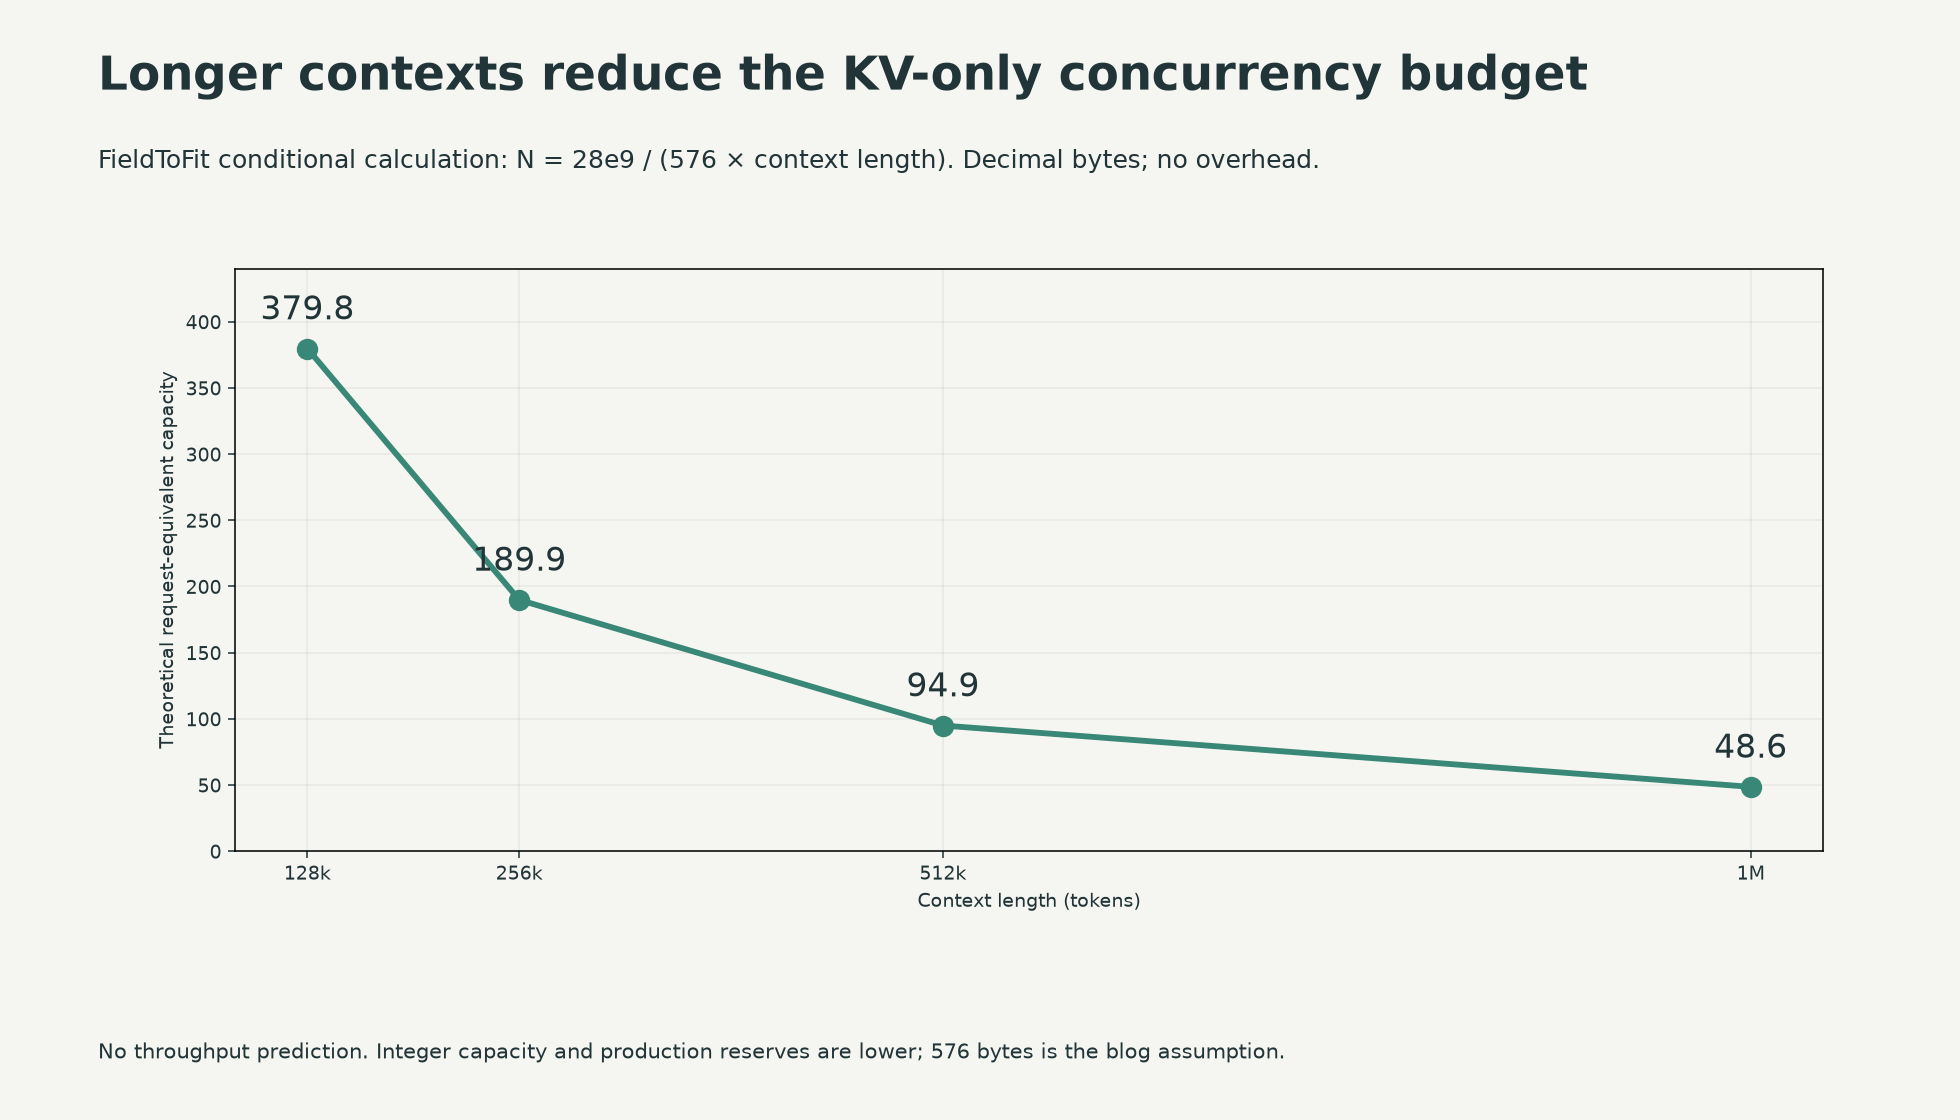
返回核心结论官方公式图给出完整注意力层每token缓存 576字节,平均请求 256,000 token;相乘为 147,456,000字节,即 147.456MB。按博文取整后的 44−16=28GB计算,28×10⁹÷147,456,000≈189.89,所以写“约 190”。这甚至不是保证能容纳 190条完整请求的严格整数上限:按这组精确数字取整只能到 189,实际还须保留运行余量。
576字节是该博文示例给定值。公开K3配置同时列kv_lora_rank=512、qk_rope_head_dim=64与mla_use_nope=true;技术报告说明MLA不施加位置编码。仅凭 512+64恰好等于 576,不能证明Cerebras真实缓存布局一定如此,也不能在未核算缩放元数据、精度和实现细节时宣布找到精确来源。本文将它保留为作者假设,待实际部署说明核验。
How we deploy Trillion-parameter frontier models on Cerebras · Section 6: KV memory formula images
每条请求都经过每个完整注意力层,因此 24片上的KV预算是逐层共同约束。不能把 190乘 24当成系统并发数,也不能把 190乘 59当成并发扩容。对异长请求,更合理的容量账本是Σ(每token字节×各请求长度)+固定开销≤该片可用空间;最紧的层先形成瓶颈。
下图只改变上下文长度,固定 28GB与 576字节,得到理论比例关系N≈28×10⁹/(576L)。上下文翻倍,KV容量允许的并发约减半;这不预测吞吐,因为计算时间、排队和缓存命中也会变。线性注意力不保存逐token的完整KV,但每个请求仍有固定大小的递归状态;固定不等于免费,前缀复用或推测解码还可能需要额外检查点与恢复处理。
How we deploy Trillion-parameter frontier models on Cerebras · Section 6: KV memory formula images
返回核心结论把一条自回归请求看作经过许多工位的产品:当前token需要穿过相关阶段,下一token通常还要等待当前token生成并反馈。流水线利用的是不同请求的重叠,让A在后段、B在中段、C在前段同时工作。它没有把一条请求的顺序依赖变成无限并行。
Cerebras说明权重通常整层驻留,跨片传激活,RDMA以太网每跳约 2微秒;生产阶段比示意中的层更细。这给出了降低数据搬运的方向,却没有提供逐阶段计算时间、通信尾延迟和完整拓扑。用 59×2微秒倒数推算tokens/s,会遗漏几乎所有决定实际服务速度的条件。
可以用一个明确标为教学模型的关系帮助理解:令阶段耗时为t₁…tS,则无排队单次穿越约为Σtᵢ,稳态完成间隔至少受最慢阶段max(tᵢ)约束。微批量为m时,理想聚合能力可写成m/max(tᵢ(m));但tᵢ随m变化,不能将批量乘上去却假设耗时不变。真实调度还受反馈、填充/排空、长短请求与状态容量限制。
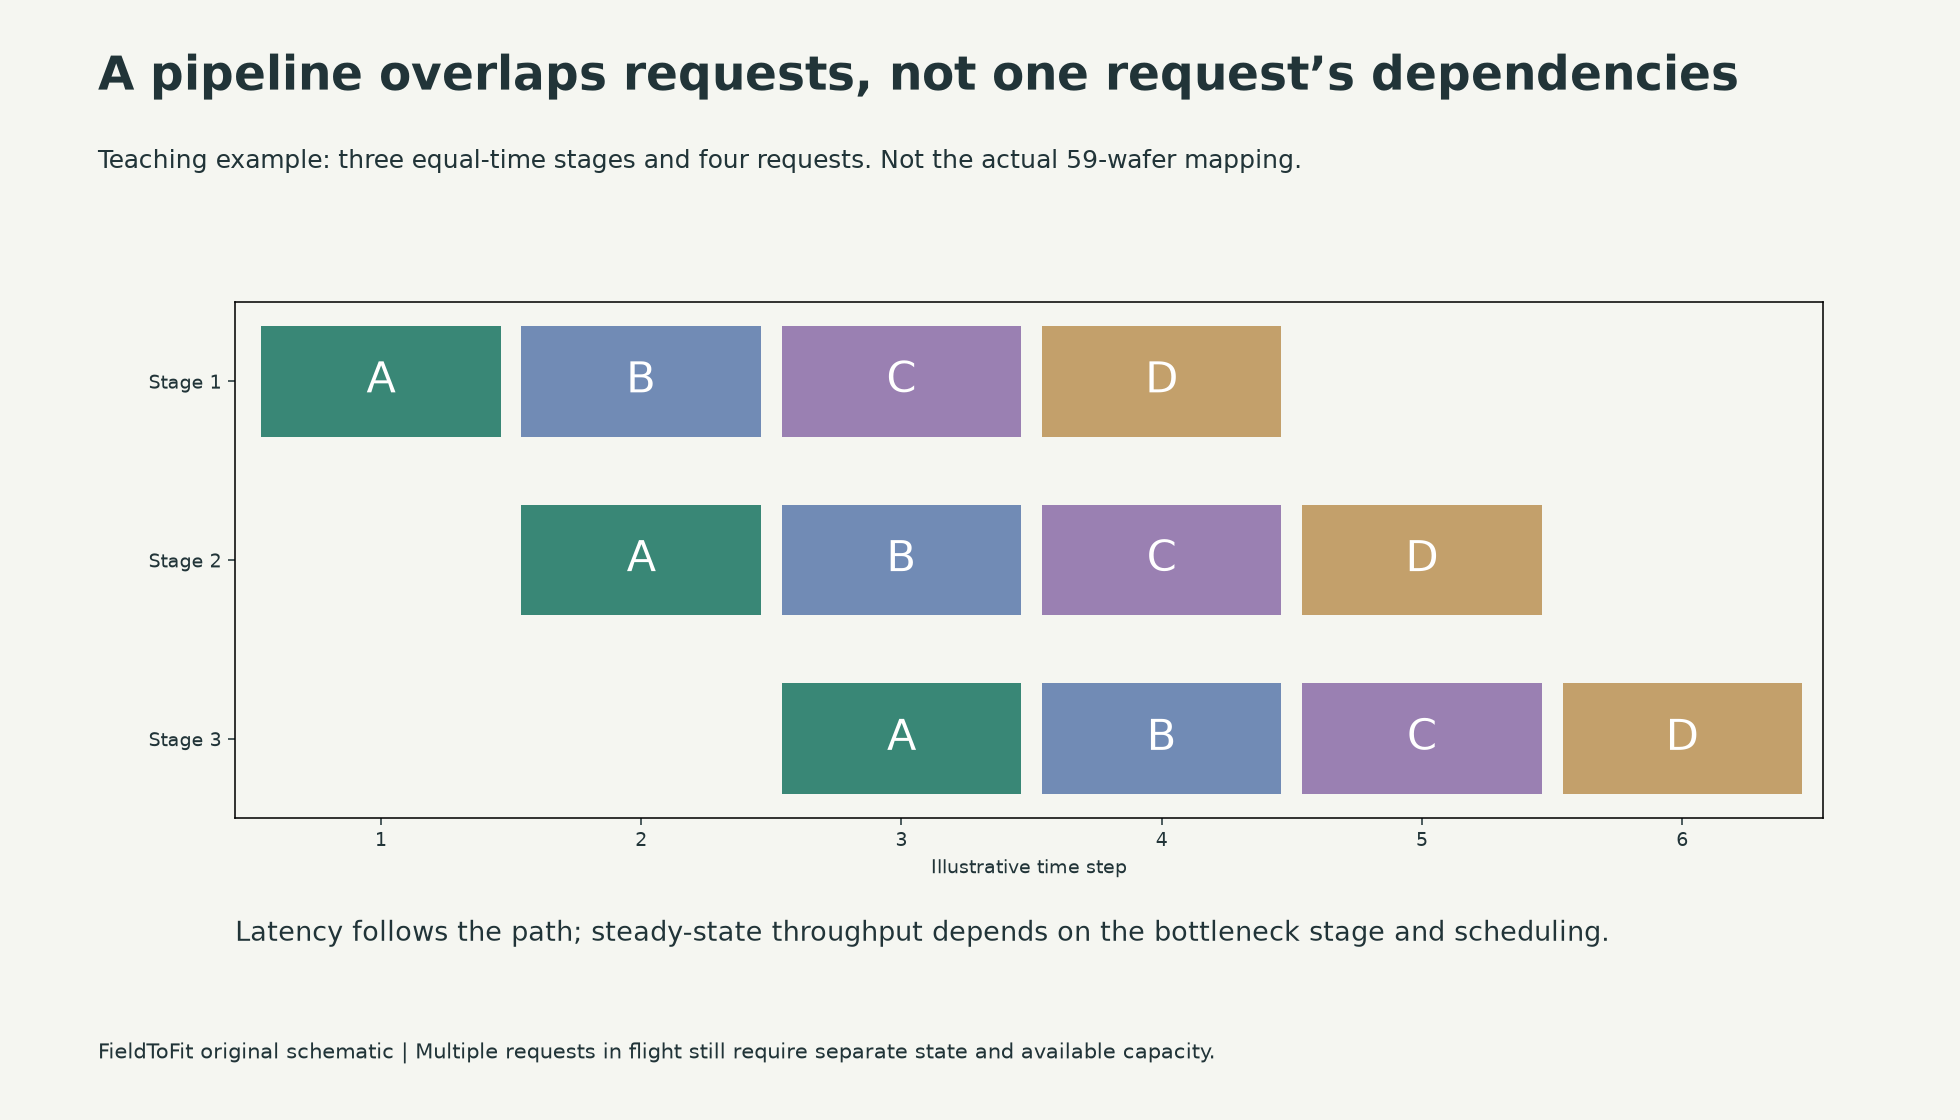
因此,流水线在飞请求数“阶段数×微批量”只是调度直觉,必须同时小于内存和服务目标允许的范围。190是缓存侧近似预算,阶段数是调度划分,吞吐是单位时间完成量;三者不能互换。
返回核心结论低批量解码时,让权重靠近计算有机会减少重复搬运;但一次完整任务还包含输入处理、prefill、排队、decode、工具和外部服务。输出tokens/s不等于首token时间,也不等于Agent任务完成时间。若工具等待已占主要时间,模型解码翻倍也不会使整项任务翻倍提速。
应在同一模型版本、数值精度与质量门槛下,报告输入/输出长度分布、缓存命中、并发与到达率;再给出TTFT、token间隔及p50/p95/p99、成功完成量和错误率。能耗比较应说明功率是在芯片、机架还是整机房边界测量,是否包含网络、主机和冷却,并在同等输出速度约束下比较有效tokens/s/MW。
Hot Chips 2026官方说明讨论CS-4与Nexus平台,也把CS-5明确列为面向 2027的目标。产品路线图不是当前K3配置的实测结果。旧版Cerebras训练文档中的Weight Streaming又属于不同执行模式:不能用“训练时外部流入权重”否定本篇常驻权重的推理描述,也不能把一个场景的数字搬到另一个场景。
截至本次核对,我没有取得 59片K3配置的可复现实验脚本、逐层内存分配、实际功率曲线、端到端延迟分位数或完整商业开放条件;官方模型目录入口的本次读取失败。这里是材料与验证缺口,不是“没有服务”或“没有性能优势”的证明。
返回核心结论How we deploy Trillion-parameter frontier models on Cerebras · Technical blog; 2026-10-22 · 首次发布 2026-10-22
地图首次发布 2026-10-26T04:31:20.974886+00:00 · 地图修订 2026-10-27T05:09:33.591902+00:00