BioBasicsBench:实验数据看得更准之后,模型会不会仍然下错结论?

BioBasicsBench:实验数据看得更准之后,模型会不会仍然下错结论?

日常实验分析需要同时读懂数据、检查对照并约束结论;总分提升不能代替对具体错误的验证。

依据OpenAI于 2026-11-06发表的原始研究网页,本站 2026-11-08读取。正文实验由OpenAI与Ligo报告;未独立运行模型、复核私有数据、开展实验或验证生物安全,不作为临床或自主实验室可靠性证明。

本次变化:首次完整分析:四条核心结论、同号论述与两张本站重绘,保留原文方法、口径和局限。

方法、实验与证据

先保留实验原貌,再谈模型能否可靠分析

机制
100项任务围绕日常分析,不把整理好的论文图表等同原始实验现场。
条件/配置
OpenAI original research; 2026-11-06
报告结果
100项任务围绕日常分析,不把整理好的论文图表等同原始实验现场。
局限
依据OpenAI于 2026-11-06发表的原始研究网页,本站 2026-11-08读取。正文实验由OpenAI与Ligo报告;未独立运行模型、复核私有数据、开展实验或验证生物安全,不作为临床或自主实验室可靠性证明。

BioBasicsBench · OpenAI ·2026-11-06 · Inside BioBasicsBench; What the agent is given

平均获分提高,不代表同等比例任务完全成功

机制
要同时读评分、任务分母、重复尝试和不确定性。
条件/配置
OpenAI original research; 2026-11-06
报告结果
要同时读评分、任务分母、重复尝试和不确定性。
局限
依据OpenAI于 2026-11-06发表的原始研究网页,本站 2026-11-08读取。正文实验由OpenAI与Ligo报告;未独立运行模型、复核私有数据、开展实验或验证生物安全,不作为临床或自主实验室可靠性证明。

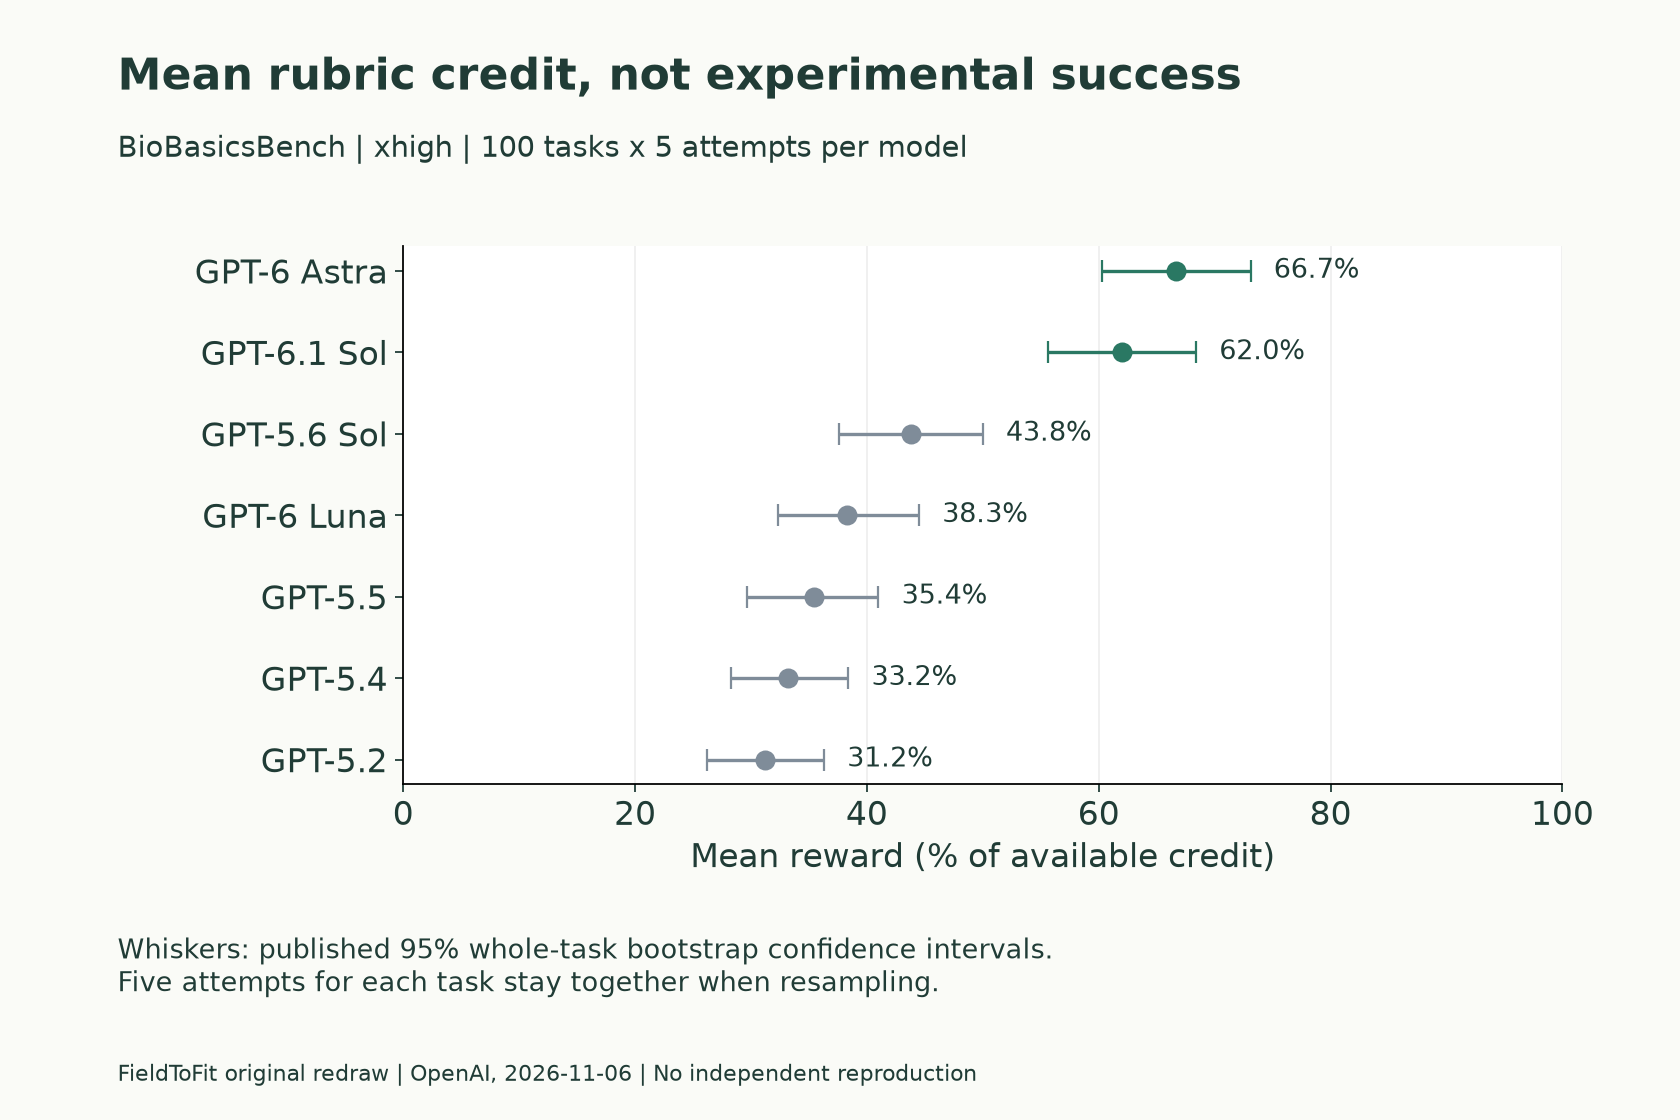
GPT-6 Astra平均获分:66.7 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 60.3–73.1%,不是实验成功率。

GPT-6.1 Sol平均获分:62.0 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 55.6–68.4%,不是实验成功率。

GPT-5.6 Sol平均获分:43.8 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 37.6–50.0%,不是实验成功率。

GPT-6 Luna平均获分:38.3 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 32.3–44.5%,不是实验成功率。

GPT-5.5平均获分:35.4 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 29.7–41.0%,不是实验成功率。

GPT-5.4平均获分:33.2 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 28.3–38.4%,不是实验成功率。

GPT-5.2平均获分:31.2 % · 比较基线 共同xhigh设置,非等成本比较 · 100任务,每项五次;95%整任务bootstrap区间 26.2–36.3%,不是实验成功率。

BioBasicsBench · OpenAI ·2026-11-06 · Results; Performance at xhigh reasoning effort

识别细节的价值,在于改变证据判断

机制
分清影像信号、实验对照与采集方式,再作解释。
条件/配置
OpenAI original research; 2026-11-06
报告结果
分清影像信号、实验对照与采集方式,再作解释。
局限
依据OpenAI于 2026-11-06发表的原始研究网页,本站 2026-11-08读取。正文实验由OpenAI与Ligo报告;未独立运行模型、复核私有数据、开展实验或验证生物安全,不作为临床或自主实验室可靠性证明。

BioBasicsBench · OpenAI ·2026-11-06 · Recognizing what the data can and cannot show; Better multimodal handling; Keeping experimental context in mind

能看到矛盾,不等于最终结论会保留矛盾

机制
对照解释、证据选择和计数仍可能失败。
条件/配置
OpenAI original research; 2026-11-06
报告结果
对照解释、证据选择和计数仍可能失败。
局限
依据OpenAI于 2026-11-06发表的原始研究网页,本站 2026-11-08读取。正文实验由OpenAI与Ligo报告;未独立运行模型、复核私有数据、开展实验或验证生物安全,不作为临床或自主实验室可靠性证明。

BioBasicsBench · OpenAI ·2026-11-06 · Where models still fall short; Building toward reliable lab assistance

关系与依据

BioBasicsBench:实验数据看得更准之后,模型会不会仍然下错结论?

  1. 先保留实验原貌,再谈模型能否可靠分析

    100项任务围绕日常分析,不把整理好的论文图表等同原始实验现场。

  2. 平均获分提高,不代表同等比例任务完全成功

    要同时读评分、任务分母、重复尝试和不确定性。

  3. 识别细节的价值,在于改变证据判断

    分清影像信号、实验对照与采集方式,再作解释。

  4. 能看到矛盾,不等于最终结论会保留矛盾

    对照解释、证据选择和计数仍可能失败。

1. 先保留实验原貌,再谈模型能否可靠分析

BioBasicsBench覆盖蛋白方法、成像与细胞术、定量分析、核酸方法和分子克隆五类日常工作。输入包括凝胶、培养皿、显微图像、仪器导出、测序文件和操作视频,同一任务可以同时使用多种资料。它针对的是解释证据与提出分析,不是让模型实际操作整个实验室。

科学家用自己的实验数据编写问题与评分细则,再经过未参与出题的Ligo科学家、外部博士级实验科学家以及最终内部审核。评分可以分别给结论、数值、理由和承认证据不足计分。技能标签和输入类型重叠,不能相加当任务总数;参考资料也不能冒充独立实验。

BioBasicsBench · OpenAI ·2026-11-06 · Inside BioBasicsBench; What the agent is given

返回核心结论

2. 平均获分提高,不代表同等比例任务完全成功

研究评估七个模型和 37种模型/推理设置,每种设置对 100项任务各尝试五次,共 18500个结果。mean reward是可获分数中实际获得的比例,再对任务求平均。95%置信区间通过整项任务重采样获得,保留同一任务五次尝试之间的关联;不能把所有尝试当完全独立样本。

七模型在xhigh下的平均获分及 95%置信区间
本站重绘;0–100%真实尺度。各模型使用 100任务、每题五次。横线为原文 95%整任务bootstrap区间,不是本站重新估计。 · FieldToFit · OpenAI · FieldToFit original explanatory redraw from cited public facts; not an original experimental figure or independent reproduction.
BioBasicsBench · OpenAI ·2026-11-06 · Results; Performance at xhigh reasoning effort

在共同报告的xhigh设置下,Astra平均获分 66.7%,区间 60.3–73.1%;GPT-5.6 Sol为 43.8%,区间 37.6–50.0%。平均输出分别为 4704和 9099 token/任务。输出token不等于完整延迟或账单;不同模型设置也不是严格等成本实验。

BioBasicsBench · OpenAI ·2026-11-06 · Results; Performance at xhigh reasoning effort

返回核心结论

3. 识别细节的价值,在于改变证据判断

文中三个例子展示了不同层面的改进:识别荧光检测窗口重叠,避免只因亮度就认定细胞死亡;发现阴性对照使用了不匹配的抗生素标签;识别显微深度扫描,避免把细胞暂时失焦解释成生物变化。这些是具体案例,不是三个新增独立基准。

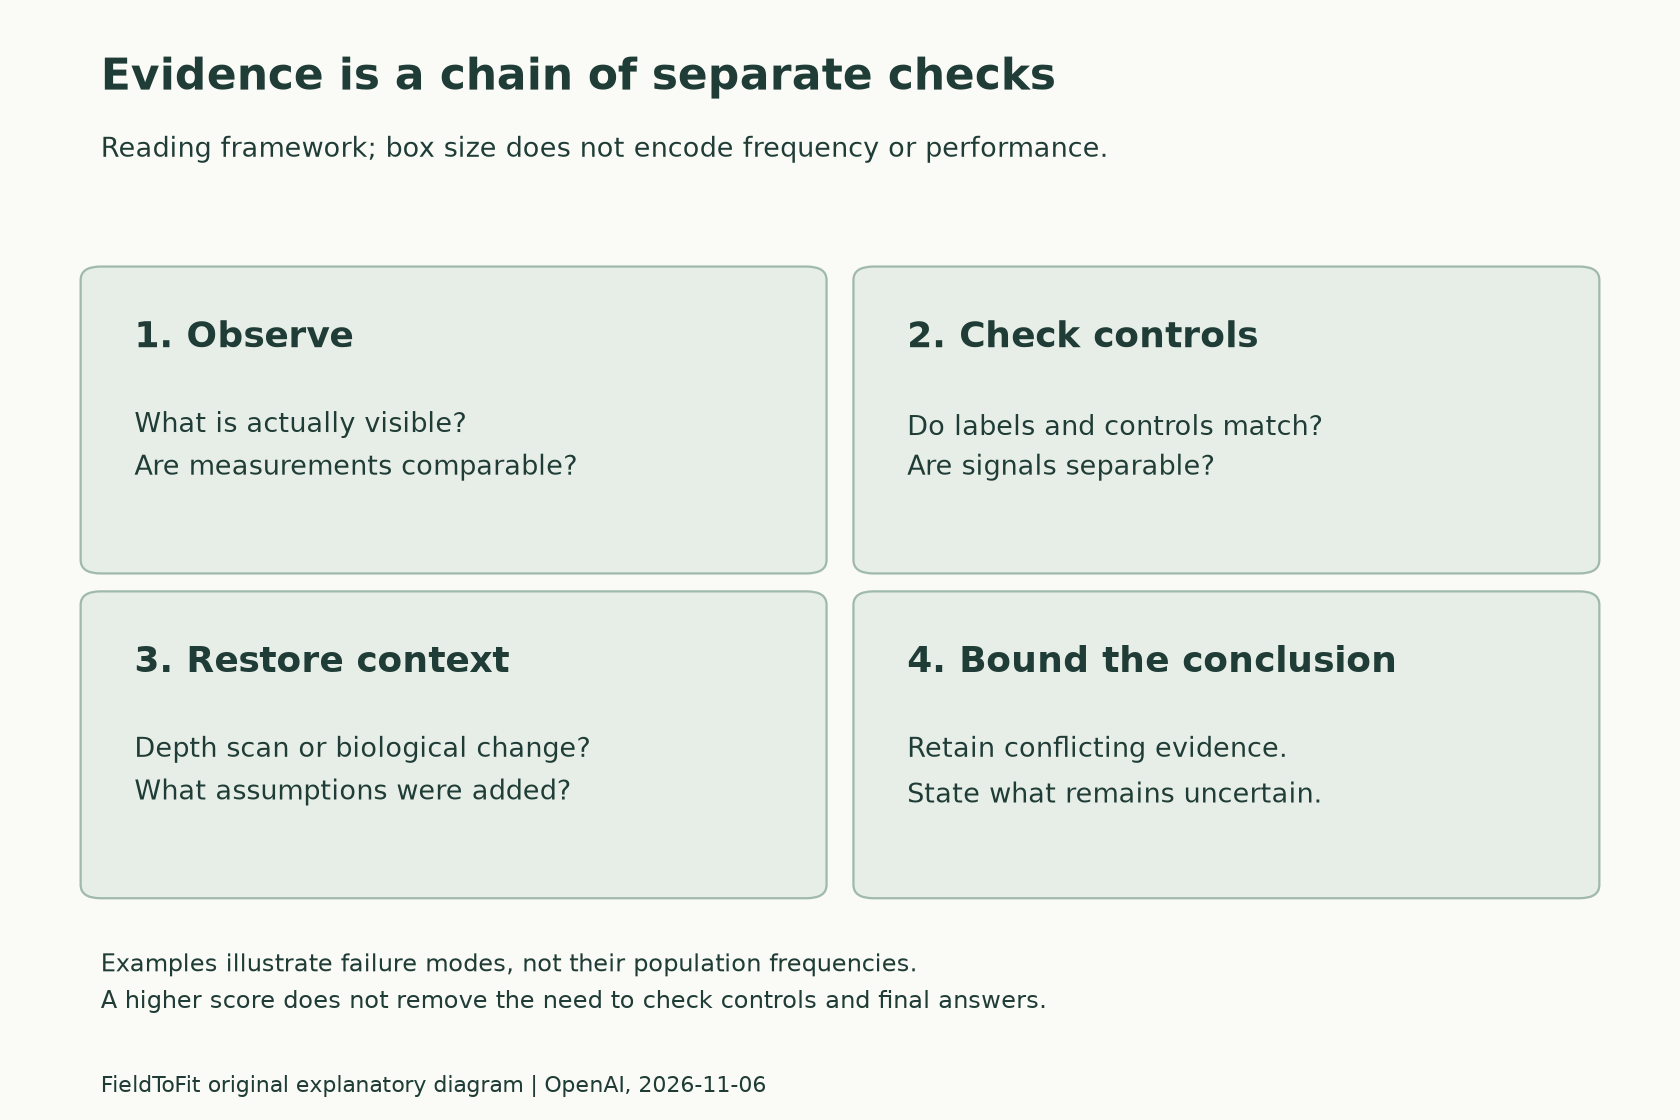
从观测到对照检查再到受约束结论的阅读框架
本站示意:观测、对照、上下文、结论分别核对。三类失败是案例类别,没有伪造发生频率。 · FieldToFit · OpenAI · FieldToFit original explanatory redraw from cited public facts; not an original experimental figure or independent reproduction.

BioBasicsBench · OpenAI ·2026-11-06 · GPT-6 Astra improvements; Where models still fall short

适用边界:不同通道图像采用各自强度尺度,不能直接定量比较亮度;检测窗口重叠不等于已测得串扰大小。更好的解释也不证明某个模型内部机制已经被实验隔离。

BioBasicsBench · OpenAI ·2026-11-06 · Recognizing what the data can and cannot show; Better multimodal handling; Keeping experimental context in mind

返回核心结论

4. 能看到矛盾,不等于最终结论会保留矛盾

在菌落PCR案例中,Astra看到了分组差别,却因预设“更大片段才正确”而选错菌落。在液泡案例中,它观察到焦距改变了对比,却在最终答案中过度保留偏好的暗色描述。这两者提示:应独立复核最终结论是否忠实使用了已经观察到的证据。

菌落计数例子同时出现漏计、合并相邻菌落和把空白计入的情况,净计数比参考多约 12%。这是该图的案例误差,不是整个基准的通用误差率。原文将这些错误作为后续改进目标,并没有证明提高总分就能安全地取消人员复核。

BioBasicsBench · OpenAI ·2026-11-06 · Where models still fall short; Building toward reliable lab assistance

返回核心结论

报告与日期

BioBasicsBench · OpenAI ·2026-11-06 · Unnumbered original HTML research dated2026-11-06 · 首次发布 2026-11-06

地图首次发布 2026-11-08T02:40:21.959667+00:00 · 地图修订 2026-11-08T02:40:21.959667+00:00

ChatGPT档案